


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is een TPU en waarom is het belangrijk?

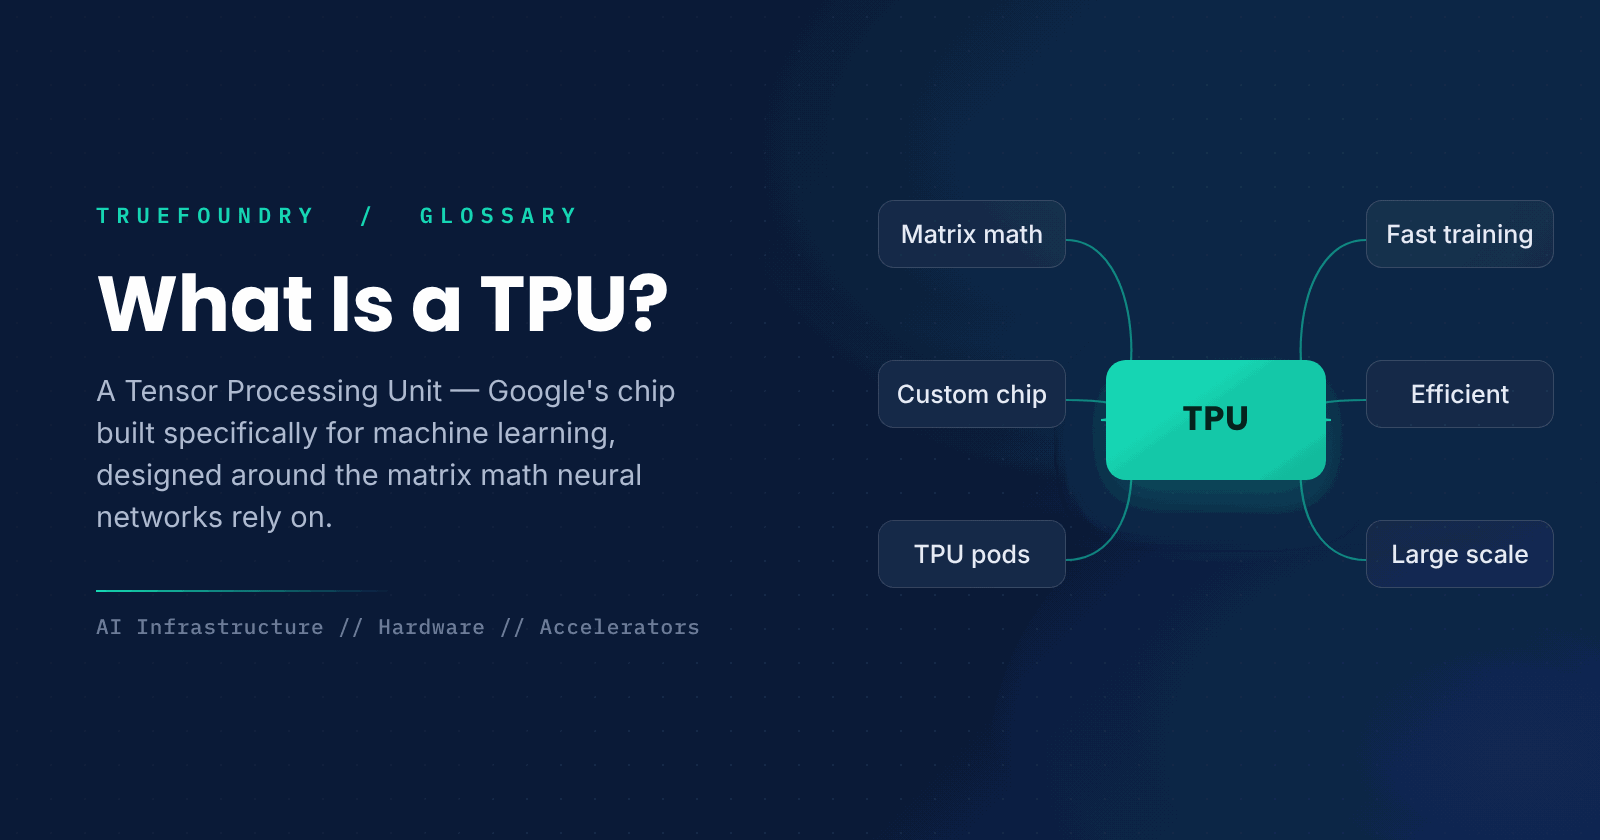
Het trainen en uitvoeren van moderne AI-modellen vereist enorme hoeveelheden van een specifiek type berekening: het vermenigvuldigen van grote matrices met getallen. Algemene processors kunnen dit wel, maar niet efficiënt genoeg voor de grootste modellen. Die vraag leidde tot gespecialiseerde hardware, en de TPU is het antwoord van Google: een chip die vanaf de basis is opgebouwd voor machine learning.
Een TPU, kort voor Tensor Processing Unit, is ontworpen rond de exacte wiskunde waar neurale netwerken op vertrouwen, wat hem zeer snel en energiezuinig maakt voor AI-workloads. Het is een belangrijk alternatief voor GPU's voor grootschalige training en inferentie. Deze gids legt uit wat een TPU is, hoe deze verschilt van andere chips en wanneer het gebruik ervan zinvol is.
We behandelen de definitie, de werking van TPU's, hoe ze zich verhouden tot CPU's en GPU's, en wanneer je ze moet gebruiken.
Wat is een TPU?
Een TPU, of Tensor Processing Unit, is een aangepaste chip, ook wel een application-specific integrated circuit genoemd, die door Google specifiek is ontworpen om machine learning-workloads te versnellen. In plaats van een algemeen doel te dienen, is de chip geoptimaliseerd voor de grote matrixvermenigvuldigingen die de kern vormen van neurale netwerken. Hierdoor kan de chip deze bewerkingen veel sneller en efficiënter uitvoeren dan een algemene chip.
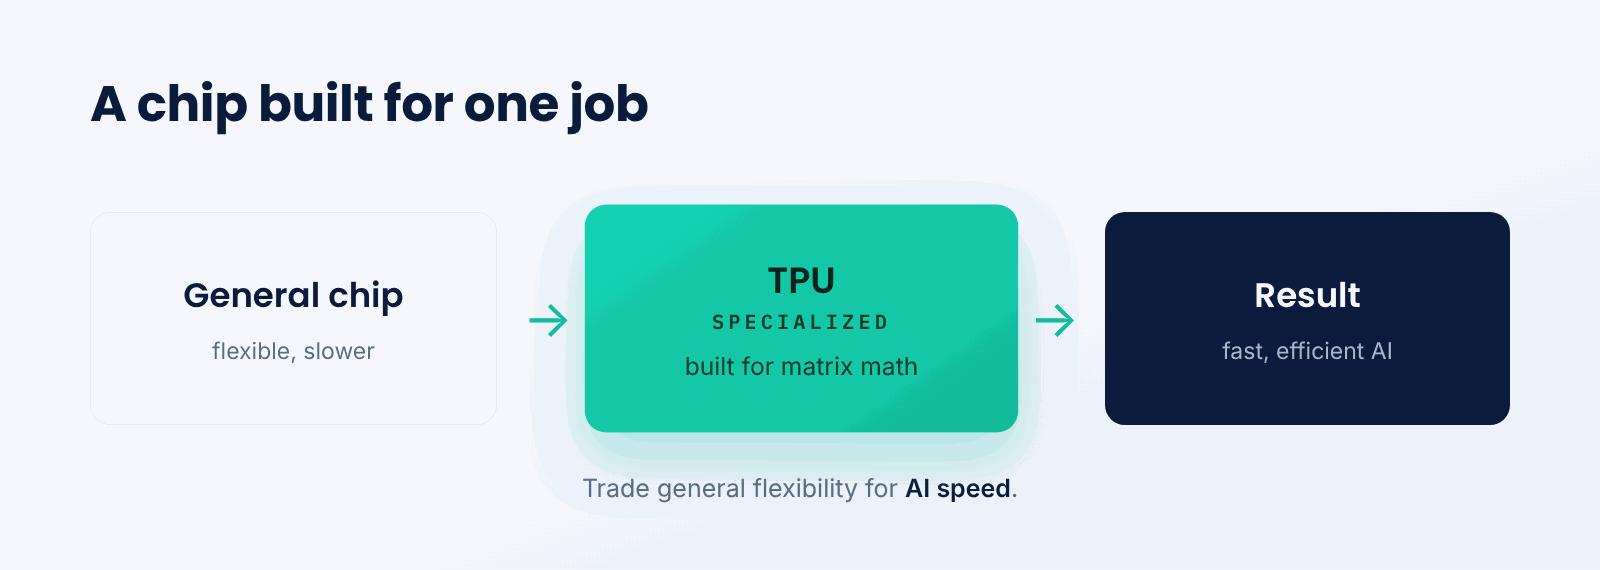
Zie het als een gespecialiseerd keukenapparaat in vergelijking met een koksmes. Een mes kan bijna alles, maar een specifiek hulpmiddel dat voor één taak is gebouwd, zoals een broodbakmachine, doet die taak sneller en consistenter. Een TPU is dat gespecialiseerde hulpmiddel voor de matrixwiskunde van machine learning.
Het kernidee is hardware-specialisatie. Door de chip op te bouwen rond de specifieke bewerkingen die neurale netwerken nodig hebben, offert een TPU algemene flexibiliteit op voor uitzonderlijke snelheid en efficiëntie bij AI-workloads.
Hoe werkt een TPU?
Een TPU versnelt de matrixbewerkingen die de kern vormen van neurale netwerken.
- Gespecialiseerde cores. De chip bevat hardware die is gebouwd voor matrixvermenigvuldiging.
- Data aanvoeren. Modelgewichten en invoergegevens worden naar de chip gestreamd.
- Massaal vermenigvuldigen. De chip voert enorme matrixbewerkingen parallel uit.
- Data in beweging houden. Het ontwerp minimaliseert kostbare geheugenoverdrachten.
- Opschalen. Veel TPU's worden met elkaar verbonden in pods voor zeer grote modellen.
De kern van een TPU is hardware die matrices uiterst efficiënt vermenigvuldigt, waarbij gegevens er zo doorheen stromen dat de resultaten direct in de volgende bewerking worden ingevoerd. Voor de grootste modellen worden veel TPU's met elkaar verbonden in pods met snelle interconnects, zodat ze modellen kunnen trainen en draaien die veel groter zijn dan één chip aankan.
TPU vs. CPU vs. GPU
Een CPU is een processor voor algemeen gebruik; flexibel, maar niet geoptimaliseerd voor de enorme parallelle wiskunde van AI. Een GPU werd gebouwd voor graphics, maar bleek uitstekend geschikt voor de parallelle berekeningen die neurale netwerken nodig hebben. Het is de meest gebruikte AI-versneller, met een breed software-ecosysteem.
Een TPU gaat een stap verder in specialisatie en is specifiek gebouwd voor de matrixwiskunde van machine learning, in plaats van aangepast vanuit een ander doel. Voor geschikte workloads kan deze sneller en energiezuiniger zijn dan een GPU, vooral op grote schaal in Google Cloud. Het nadeel is minder algemeenheid en een beperkter ecosysteem dan bij GPU's, dus de beste keuze hangt af van je workload en platform.
Waarom is een TPU belangrijk?
- Snelheid.Het versnelt de kernwiskunde van neurale netwerken.
- Efficiëntie.Het kan energiezuiniger zijn dan algemene chips.
- Schaal.TPU-pods trainen en draaien zeer grote modellen.
- Kosten.Efficiëntie kan de kosten van grote workloads verlagen.
- Keuze. Het is een belangrijk alternatief voor GPU's voor AI.
Wat zijn de afwegingen?
- Minder algemeen. Het is een gespecialiseerde chip, geen flexibele alleskunner.
- Ecosysteem. De softwareondersteuning is beperkter dan bij GPU's.
- Beschikbaarheid. TPU's zijn voornamelijk toegankelijk via Google Cloud.
- Geschiktheid. Niet elk model of framework is goed geschikt voor een TPU.
Wanneer moet je een TPU gebruiken?
Overweeg een TPU wanneer je grote modellen op schaal traint of serveert en behoefte hebt aan hoge prestaties en efficiëntie, zeker als je al met Google Cloud werkt, waar TPU's direct beschikbaar zijn. Ze blinken uit in grote, matrix-intensieve workloads die aansluiten bij hun ontwerp en ondersteunde frameworks.
Als je behoefte hebt aan brede flexibiliteit, een uitgebreid software-ecosysteem of hardware die op veel platforms beschikbaar is, zijn GPU's vaak de meer praktische keuze. Het afstemmen van de accelerator op je workload, framework en platform zorgt voor de beste prestaties tegen de laagste kosten.
Belangrijke punten over TPU's
- Een TPU is een chip die specifiek is gebouwd voor machine learning.
- Hij is geoptimaliseerd voor de matrixberekeningen die neurale netwerken gebruiken.
- Hij kan sneller en efficiënter zijn dan GPU's voor AI.
- TPU-pods schalen naar zeer grote modellen.
- Hij is minder algemeen inzetbaar en heeft een beperkter ecosysteem dan GPU's.
- Het is een belangrijke optie voor grootschalige AI op Google Cloud.
Conclusie
Een TPU is een chip die speciaal is ontwikkeld om machine learning te versnellen, ontworpen rond de matrixberekeningen waar neurale netwerken van afhankelijk zijn. Die specialisatie maakt hem zeer snel en energiezuinig voor het trainen en draaien van grote modellen, en TPU-pods schalen naar de grootste workloads. Als belangrijk alternatief voor GPU's, vooral op Google Cloud, is het een essentiële optie voor grootschalige AI, met als keerzijde een lagere algemene inzetbaarheid en een kleiner ecosysteem.
TrueFoundry helpt teams bij het draaien van AI-workloads op verschillende hardware binnen hun eigen infrastructuur, inclusief GPU's en andere accelerators, waarbij de rekenkracht wordt afgestemd op de workload. Bij het kiezen van hardware voor grootschalige AI helpt het om te begrijpen wat een TPU te bieden heeft, zodat je de juiste beslissing kunt nemen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is a TPU in simple terms?
It is a chip that Google created specifically for machine learning, so it differs from an ordinary processor in its specialized architecture. Instead of being a generic chip, it is built around the matrix math neural networks rely on, so it can train and run large models faster and more efficiently than an ordinary processor.
How is a TPU different from a GPU?
A GPU was designed for graphics and then repurposed for AI, so it has a very wide software ecosystem. A TPU is purpose-built for machine learning's matrix math, so it can be faster and more power-efficient for suitable workloads, but it is more specialized and has a narrower ecosystem than GPUs.
What does a TPU do well?
Large matrix multiplications, which are the heart of neural network training and inference. The TPU executes these operations quickly by using hardware tailored to them and moving data efficiently, and several TPUs can be interconnected in pods for extremely large models.
How do I access a TPU?
The main place to find TPUs is Google Cloud, where they can be used for model training and inference. This is unlike GPUs, which are offered by many cloud providers and can also be bought directly, giving GPUs wider availability across platforms.
When should I use a TPU instead of a GPU?
Consider a TPU for large, matrix-heavy training or inference at scale, especially if you are on Google Cloud with a supported framework. If you need broad flexibility, a wide ecosystem, or hardware across many platforms, a GPU is often more practical.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


