


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat zijn tokens per seconde en waarom zijn ze belangrijk?

Zodra een taalmodel begint met antwoorden, is de volgende vraag hoe snel de woorden verschijnen. Tokens per second geeft daar antwoord op: het is de snelheid waarmee het model output-tokens produceert. Voor een individueel antwoord is dit de streaming-snelheid die een gebruiker ziet; voor een volledige implementatie is het de doorvoersnelheid die bepaalt hoeveel verkeer het systeem kan verwerken.
Omdat het zowel de gebruikerservaring als de servercapaciteit beschrijft, is tokens per second een van de meest nauwlettend gevolgde statistieken bij het aanbieden van LLM's. Een hogere snelheid betekent vloeiendere streaming voor gebruikers en meer verwerkte verzoeken per GPU, dus begrijpen wat dit beïnvloedt is essentieel voor efficiënte dienstverlening.
Deze gids legt uit wat tokens per second betekent, de twee niveaus die het beschrijft, wat het beïnvloedt en hoe het zich verhoudt tot andere doelen.
Wat is tokens per second?
Tokens per second is het aantal tokens dat een model per seconde genereert. Het kan worden gemeten per verzoek, de snelheid waarmee één antwoord wordt gestreamd, of per server, de gecombineerde snelheid van tokens geproduceerd over alle gelijktijdige verzoeken. Beide gebruiken dezelfde eenheid, maar beschrijven verschillende zaken: individuele responsiviteit versus algehele doorvoersnelheid.
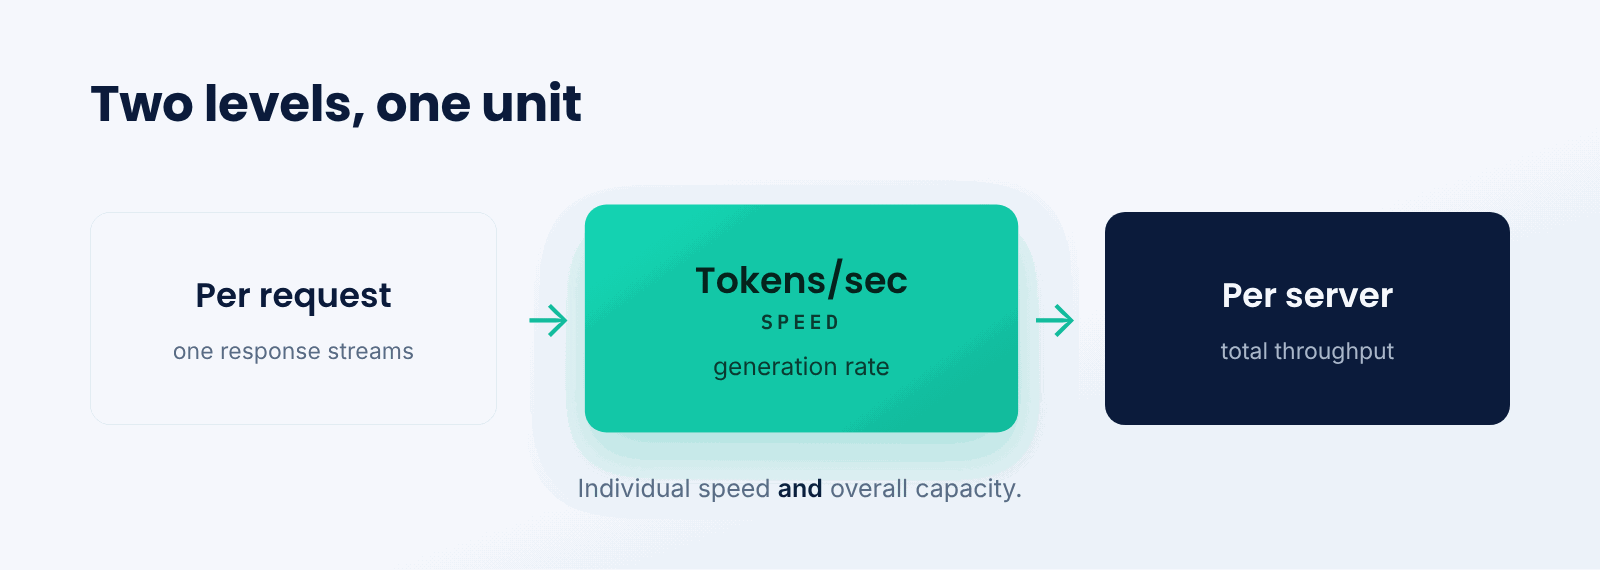
Zie het als een printer. De pagina's-per-minuut voor één document is als de snelheid per verzoek, terwijl het totaal aantal pagina's dat de drukkerij over alle opdrachten heen produceert, vergelijkbaar is met de doorvoersnelheid per server. Dezelfde machine kan op beide manieren worden gemeten en beide getallen zijn om verschillende redenen van belang.
Het belangrijkste is om onderscheid te maken tussen de twee niveaus. Een hoge snelheid per verzoek zorgt voor een vloeiende ervaring; een hoge snelheid per server betekent dat de implementatie veel gebruikers tegelijk kan bedienen.
Wat beïnvloedt tokens per second?
Verschillende factoren bepalen hoeveel tokens per second een implementatie kan produceren.
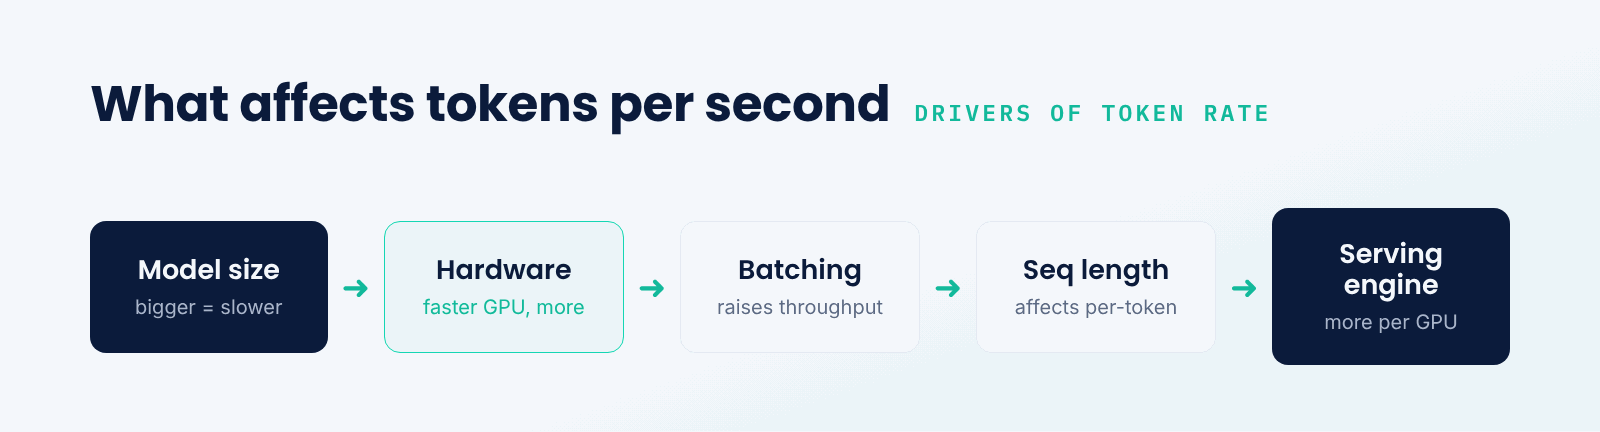
- Modelgrootte. Grotere modellen berekenen meer per token, wat de ruwe snelheid verlaagt.
- Hardware.Snellere GPU's en een betere geheugenbandbreedte verhogen de token-snelheid.
- Batching.Het gelijktijdig verwerken van veel verzoeken verhoogt de totale doorvoersnelheid.
- Sequentielengte. Langere contexten en outputs beïnvloeden de kosten per token.
- Serving engine.Geoptimaliseerde engines halen meer tokens per second uit dezelfde hardware.
Er is een spanning tussen de twee niveaus. Het groeperen van meer verzoeken verhoogt de doorvoer van de server, maar kan elk individueel antwoord iets vertragen. Daarom wordt de server zo afgesteld dat er een balans is tussen de snelheid per gebruiker en de totale capaciteit.
Tokens per seconde per verzoek versus per server
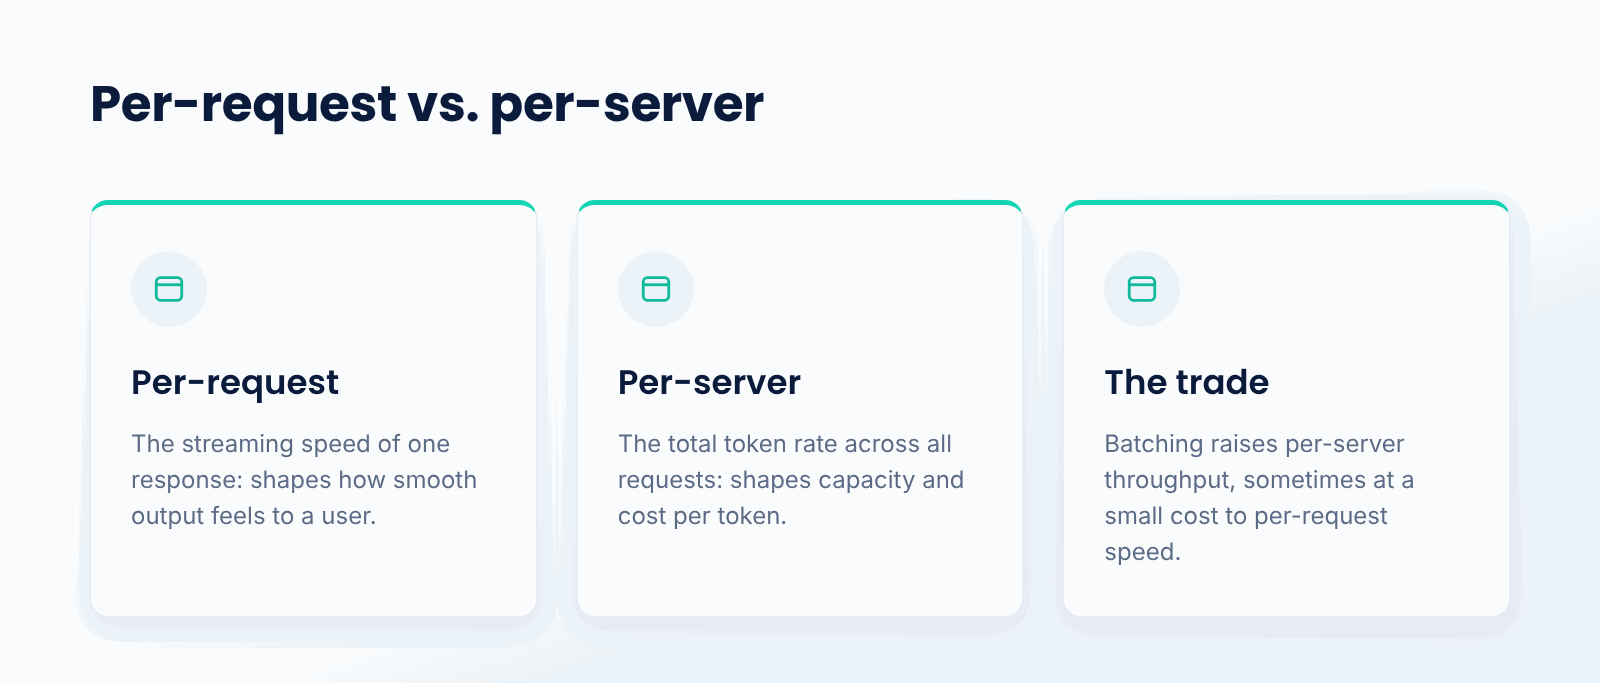
De twee metingen beantwoorden verschillende vragen. Tokens per seconde per verzoek is de streamingsnelheid van één enkel antwoord, wat bepaalt hoe vloeiend de output voor een gebruiker aanvoelt. Tokens per seconde per server is de totale token-rate over alle verzoeken heen, wat bepaalt hoeveel gebruikers de implementatie kan bedienen en wat de kosten per token zijn. Batching verhoogt de tweede, soms ten koste van de eerste.
Goede serveroptimalisatie brengt beide binnen de perken: snel genoeg streamen per verzoek zodat de ervaring vloeiend aanvoelt, en een voldoende hoge doorvoer per server zodat de hardware efficiënt wordt benut. Waar de voorkeur naar uitgaat, hangt af van de vraag of de prioriteit bij interactiviteit of bij schaalbaarheid ligt.
Waarom zijn tokens per seconde belangrijk?
- Streamingbeleving. De snelheid per verzoek bepaalt hoe vloeiend de tekst verschijnt.
- Doorvoer.De snelheid per server bepaalt hoeveel verzoeken je kunt verwerken.
- Kosten per token. Een hogere doorvoer verdeelt de GPU-kosten over meer output.
- Capaciteitsplanning. Het geeft aan hoeveel hardware een werklast nodig heeft.
- Benchmarking.Het is een standaardmanier om modellen en serverconfiguraties te vergelijken.
Wat zijn de afwegingen?
- Latentie versus doorvoer. Meer batching verhoogt de doorvoer, maar kan elk antwoord vertragen.
- Modelgrootte versus snelheid. Grotere modellen zijn vaak beter, maar trager per token.
- Gelijktijdigheid. Veel gelijktijdige verzoeken delen de GPU-capaciteit.
- Contextlengte. Lange sequenties veranderen de kosten per token en het geheugengebruik.
Wanneer moet je tokens per seconde bijhouden?
Houd dit in de gaten zodra je LLM-inferentie aanbiedt en je geeft om de gebruikerservaring of de kosten; in productie is dat eigenlijk altijd het geval. Snelheid per verzoek is belangrijk voor interactieve apps; doorvoer per server is belangrijk voor capaciteits- en kostenplanning.
Voor een eenmalige generatie is het ruwe getal minder belangrijk. Maar elke implementatie die echt verkeer bedient, heeft er baat bij om tokens per seconde op beide niveaus te meten om een balans te vinden tussen reactiesnelheid en de efficiëntie van het hardwaregebruik.
Best practices voor tokens per seconde
- Meet tokens per seconde op zowel het niveau van het verzoek als op serverniveau.
- Gebruik batching om de doorvoer te verhogen, terwijl je de impact per verzoek in de gaten houdt.
- Stem de modelgrootte af op de snelheid en kwaliteit die de use case vereist.
- Gebruik een efficiënte serving-engine om het aantal tokens per GPU te maximaliseren.
- Plan capaciteit op basis van doorvoer per server en verwacht verkeer.
- Breng interactiviteit en kosten in balans op basis van de toepassing.
Conclusion
Tokens per seconde meet hoe snel een model output genereert, zowel als de streamingsnelheid van een enkel antwoord als de totale doorvoer van een implementatie. Het wordt bepaald door de modelgrootte, hardware, batching en de serving-engine, en het vormt een afweging tussen latentie en gelijktijdigheid. Omdat het zowel de gebruikerservaring als de kosten voor het serveren bepaalt, is tokens per seconde een centrale metriek voor het efficiënt draaien van LLM's.
TrueFoundry helpt teams om modellen efficiënt te serveren op hun eigen infrastructuur, waarbij tokens per seconde en GPU-gebruik op één plek inzichtelijk zijn. Of de prioriteit nu ligt bij vloeiende streaming of een hoge doorvoer, tokens per seconde is de metriek die je vertelt hoe je serving presteert.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is tokens per second in simple terms?
It refers to how many tokens a model generates per second. For a single response it is the streaming speed you see; for an entire deployment it is the total output rate that defines how many requests can be handled.
What is the difference between per-request and per-server tokens per second?
Per request is the speed of one response, which affects how smooth it feels to one user. Per server is the combined rate across all requests, which affects total capacity and cost. Batching increases the latter, sometimes slowing down the former.
What affects tokens per second?
Model size, hardware, batching, sequence length, and serving engine. Larger models are slower on a token-by-token basis, faster hardware is quicker, and larger batches increase overall server throughput, usually with a small overhead per request.
Why does tokens per second matter for cost?
Since increased per-server throughput spreads the fixed cost of expensive GPUs over a greater number of tokens. As a deployment generates more tokens per second, the cost of each one drops and it serves more traffic.
How does tokens per second relate to time to first token?
These are latency measurements that complement each other. Time to first token is how long it takes output to start, while tokens per second is the speed at which it streams afterward. An excellent experience requires both a quick start and a steady streaming rate.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


