


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is rekenkracht tijdens het testen en waarom is het belangrijk?


Gedurende het grootste deel van de geschiedenis van deep learning stonden de capaciteiten van een model vast zodra de training was voltooid: je voerde het uit, het gaf een antwoord, en dat was het. Test-time compute verandert dit beeld door de rekenkracht die tijdens het beantwoorden wordt verbruikt te behandelen als een knop waaraan je kunt draaien. Besteed er meer van, en het model kan langer nadenken en vaak moeilijkere vragen correct beantwoorden.
Dit idee staat centraal in de recente golf van redenerende modellen. In plaats van in één keer een antwoord te geven, genereren ze tussenliggende redeneringen, verkennen ze alternatieven en controleren ze hun werk; dit alles verbruikt rekenkracht tijdens de inferentie. De winst is een hogere nauwkeurigheid bij problemen die baat hebben bij deliberatie, zoals wiskunde, programmeren en logica met meerdere stappen.
Deze gids legt uit wat test-time compute is, hoe modellen het gebruiken, hoe het zich verhoudt tot het schalen van de modelgrootte en wanneer het de moeite waard is om er meer van te besteden.
Wat is test-time compute?
Test-time compute, ook wel inference-time compute genoemd, is het rekenwerk dat een model uitvoert terwijl het reageert op een vraag. Het onderscheidt zich van training compute, die eenmalig wordt besteed om het model te bouwen. Test-time compute wordt elke keer dat het model wordt gebruikt verbruikt, en cruciaal is dat de hoeveelheid die wordt besteed per vraag kan variëren.
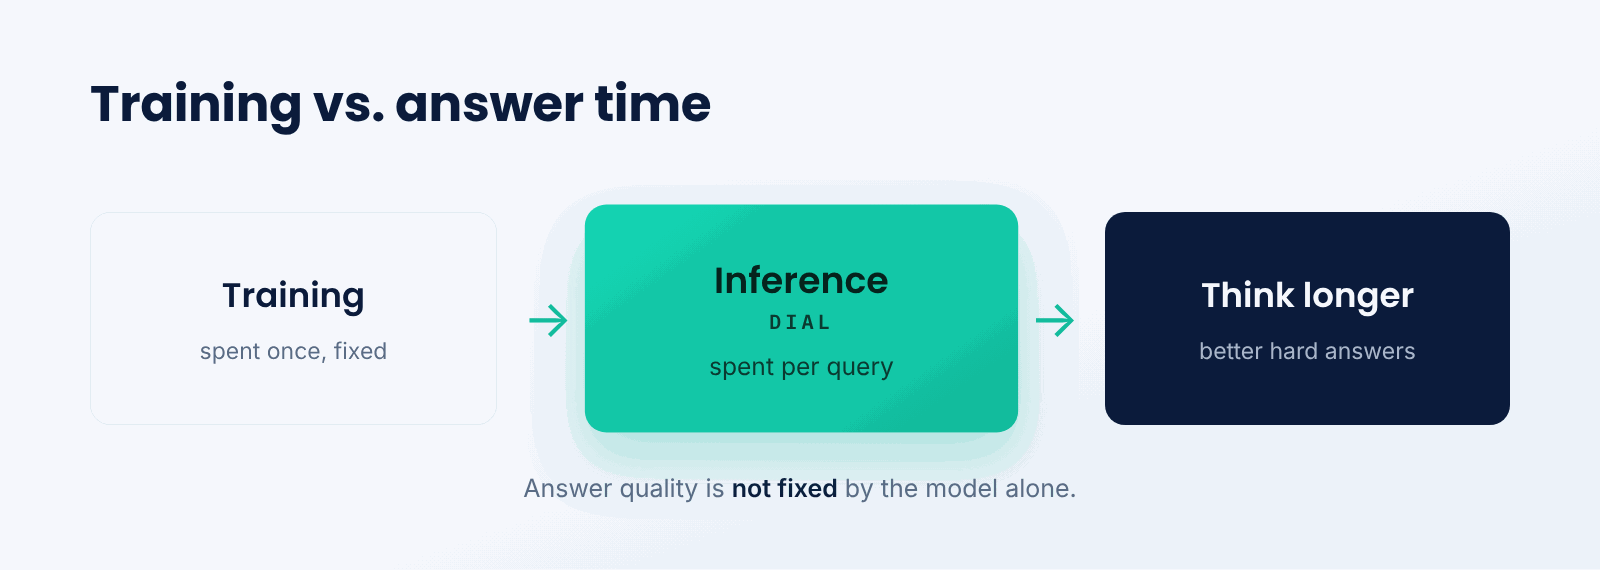
Zie het als een student die een examen maakt. De training is al het studeren dat vooraf is gedaan, wat vaststaat tegen de tijd dat het examen begint. Test-time compute is de tijd die de student tijdens het examen besteedt aan het uitwerken van elke vraag. Meer tijd besteden, het werk controleren en alternatieven proberen leidt meestal tot betere antwoorden op moeilijke vragen.
Het kernidee is dat de kwaliteit van het antwoord niet alleen door het model zelf wordt bepaald. Voor problemen die deliberatie belonen, kan het model meer werk laten verrichten tijdens de inferentie – door langere redeneringen of meerdere pogingen te genereren – de nauwkeurigheid aanzienlijk verhogen ten opzichte van een enkel snel antwoord.
Hoe gebruiken modellen test-time compute?
Modellen zetten extra inferentie-rekenkracht om in betere antwoorden via verschillende strategieën.
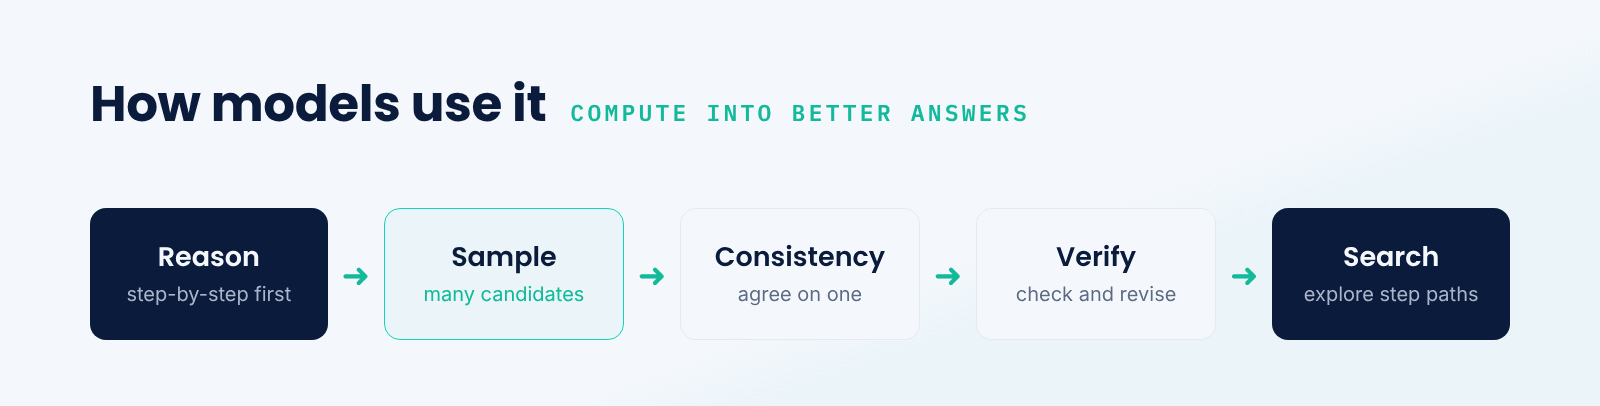
- Langere redeneringen. Het model genereert stapsgewijze redeneringen voordat het tot een definitief antwoord komt.
- Het bemonsteren van vele antwoorden. Het produceert verschillende kandidaat-antwoorden om uit te kiezen.
- Zelfconsistentie. Het kiest het antwoord waar de meeste pogingen het over eens zijn.
- Verificatie. Het controleert of bekritiseert zijn eigen kandidaten en past deze aan.
- Zoekopdrachten.Het verkent een boomstructuur van mogelijke stappen en behoudt de meest veelbelovende paden.
Deze strategieën verbruiken allemaal meer rekenkracht per vraag in ruil voor een beter eindantwoord. De hoeveelheid kan vaak per verzoek worden opgeschaald of afgeschaald, waardoor je zware deliberatie kunt reserveren voor de moeilijke vragen, terwijl je eenvoudige vragen snel en goedkoop beantwoordt.
Test-time compute versus het schalen van modelgrootte
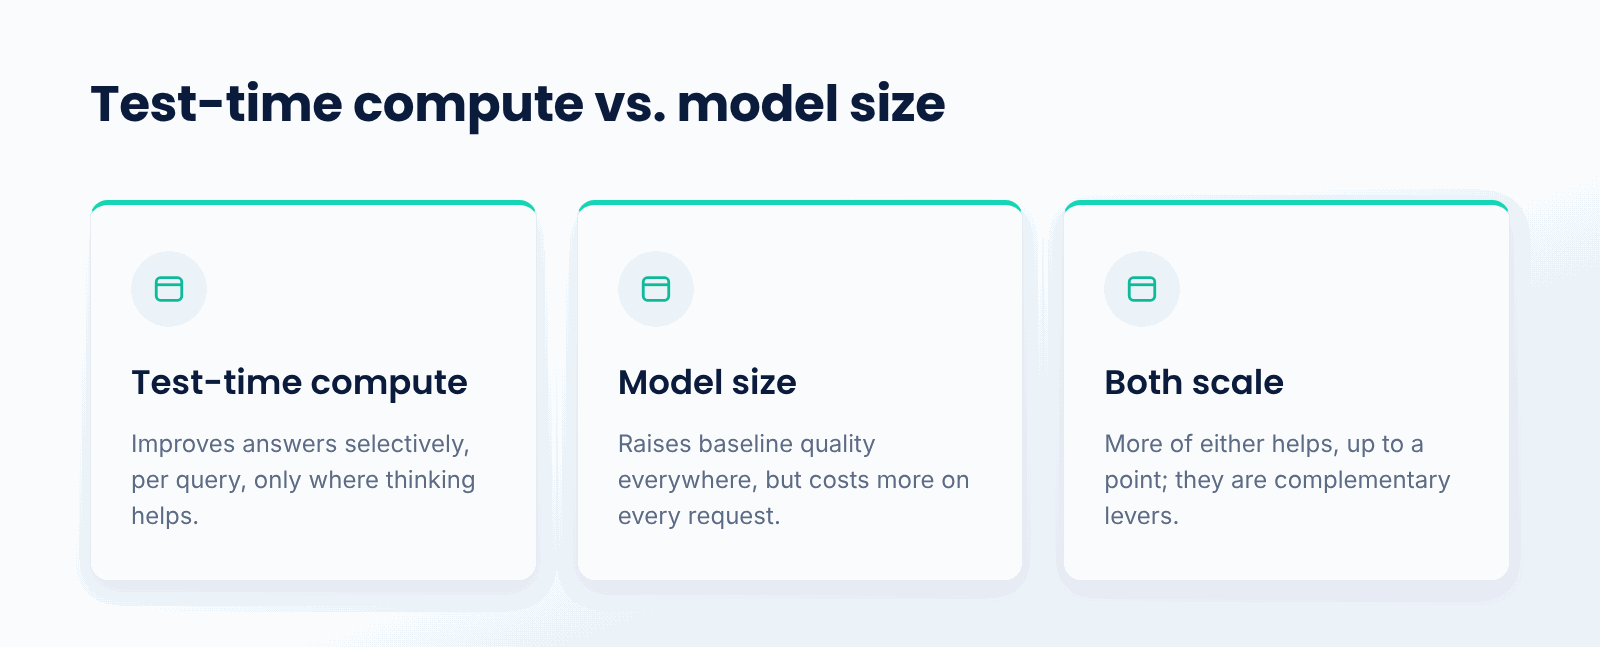
Er zijn twee algemene manieren om een model moeilijkere vragen te laten beantwoorden: het model groter maken, wat de kosten voor zowel training als inferentie permanent verhoogt, of meer rekenkracht besteden tijdens de inferentie van een specifiek model. Het schalen van de modelgrootte verbetert de basiscapaciteiten over de hele linie; het schalen van test-time compute verbetert antwoorden selectief, bij vragen waarbij langer nadenken helpt.
De twee zijn complementair en volgen beide schaaltrends: meer van beide leidt tot op zekere hoogte tot betere resultaten. Test-time compute is aantrekkelijk omdat het flexibel is; je betaalt alleen voor extra denkwerk wanneer een vraag dat vereist, in plaats van voor elk verzoek – ook de eenvoudige – te betalen voor een groter model.
Waarom is test-time compute belangrijk?
- Moeilijkere problemen. Het verhoogt de nauwkeurigheid bij taken die baat hebben bij deliberatie.
- Flexibiliteit.Je kunt alleen extra middelen inzetten voor de vragen die dat nodig hebben.
- Geen hertraining. Het verbetert antwoorden zonder het model aan te passen.
- Een nieuwe schaalas. Het is een aparte knop om aan te draaien, los van model- en datagrootte.
- Redeneerkwaliteit. Het vormt de basis voor de capaciteiten van moderne redeneermodellen.
Wat zijn de afwegingen?
- Latentie.Meer denkwerk betekent tragere antwoorden.
- Kosten.Extra rekenkracht per vraag verhoogt de serverkosten.
- Afnemende meeropbrengst.Voorbij een bepaald punt voegt meer denkwerk nauwelijks iets toe.
- Niet altijd nuttig. Eenvoudige of opzoekvragen hebben er niets aan.
Wanneer moet je meer test-time compute inzetten?
Zet meer in op problemen waarbij correctheid cruciaal is en deliberatie helpt: complexe wiskunde, redeneringen in meerdere stappen, codegeneratie en planning. Voor deze taken rechtvaardigt de nauwkeurigheidswinst door langer nadenken vaak de extra latentie en kosten, zeker wanneer een fout antwoord kostbaar is.
Houd de rekenkracht tijdens het testen laag voor eenvoudige, latentiegevoelige of grootschalige queries. Het beantwoorden van een feitelijke opzoekvraag of een korte classificatie met uitgebreide deliberatie is zonde van het geld en vertraagt de respons zonder enig voordeel. De kunst is om de rekenkracht af te stemmen op de moeilijkheidsgraad van elke query.
Belangrijke punten over rekenkracht tijdens het testen
- Het is de rekenkracht die wordt besteed aan het beantwoorden van een query, niet aan het trainen van het model.
- Redeneermodellen gebruiken dit om na te denken voordat ze antwoorden.
- Strategieën omvatten langer redeneren, sampling, verificatie en zoeken.
- Het ruilt latentie en kosten in voor nauwkeurigheid bij complexe problemen.
- Het is een schaalas die losstaat van de modelgrootte.
- Stem de hoeveelheid af op de moeilijkheidsgraad van elke query om de kosten te beheersen.
Conclusie
Rekenkracht tijdens het testen is de berekening die een model uitvoert tijdens het beantwoorden. Door dit als een instelbare knop te behandelen, kunnen redeneermodellen langer nadenken om moeilijkere problemen op te lossen. Via langer redeneren, sampling, verificatie en zoeken zorgt meer inferentie-rekenkracht voor betere antwoorden, ten koste van latentie en uitgaven. Als schaalas die losstaat van de modelgrootte, biedt het de flexibiliteit om alleen te betalen voor deliberatie waar dit ook echt helpt.
TrueFoundry helpt teams om redeneermodellen efficiënt in te zetten en inferentiekosten te beheersen, zodat zware rekenkracht tijdens het testen kan worden gereserveerd voor de queries die dit nodig hebben. Naarmate redeneermodellen meer worden gebruikt, is het goed beheren van de rekenkracht tijdens het testen essentieel om de balans tussen kwaliteit en kosten te bewaren.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is test-time compute in simple terms?
This refers to the amount of computation performed by the model in response to your query, not during the training phase. By performing more of it, the model can think longer, generating and checking reasoning steps, which leads to better answers on hard problems.
How is test-time compute different from training compute?
Compute used for training the model is a one-time usage that goes into making the model. Test-time compute is spent every time the model answers a query and can vary per request, so you can think longer on hard questions and answer easy ones quickly.
Does more test-time compute always give better answers?
No. It performs better in cases where thought is required, such as mathematical and multi-step reasoning tasks. In simple or look-up tasks, it causes delays and additional costs for negligible gains. Even in difficult tasks, there comes a point when the improvement levels off.
How do reasoning models use test-time compute?
They use it in such things as developing logical reasoning through each step, checking several different responses and taking the one that is most consistent, checking and improving upon their own suggestions, or exploring potential solution paths before making a final choice.
Is it better to scale test-time compute or model size?
They complement each other. Larger models increase baseline quality on all queries but at a higher cost on every request. Additional compute at test time helps answer questions that require thinking, offering greater flexibility by charging for reasoning per query rather than on every request.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


