


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is tensor-parallelisme en waarom is het belangrijk?

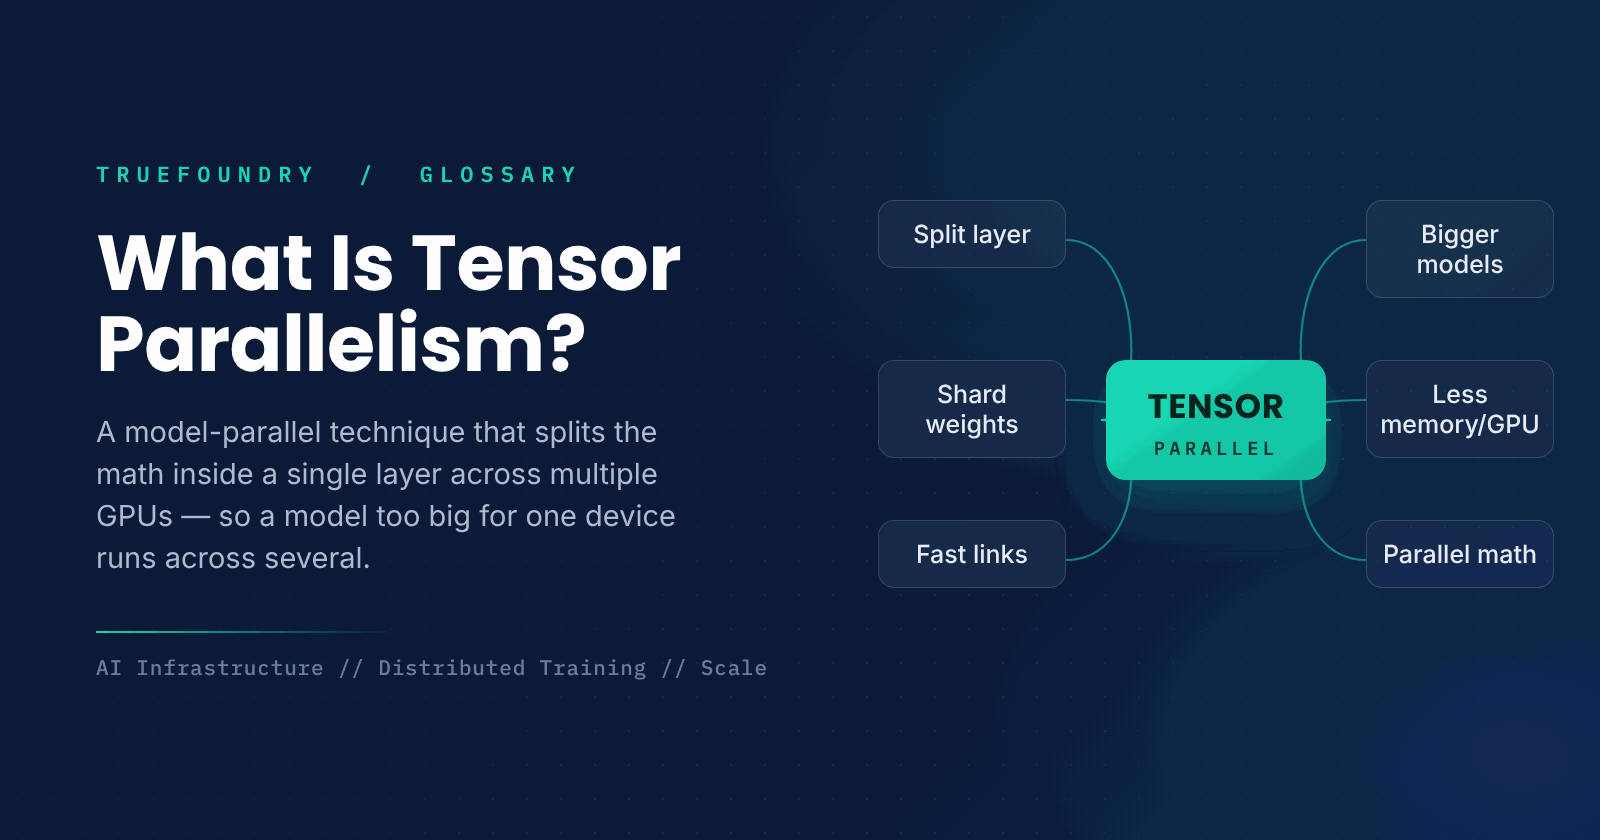
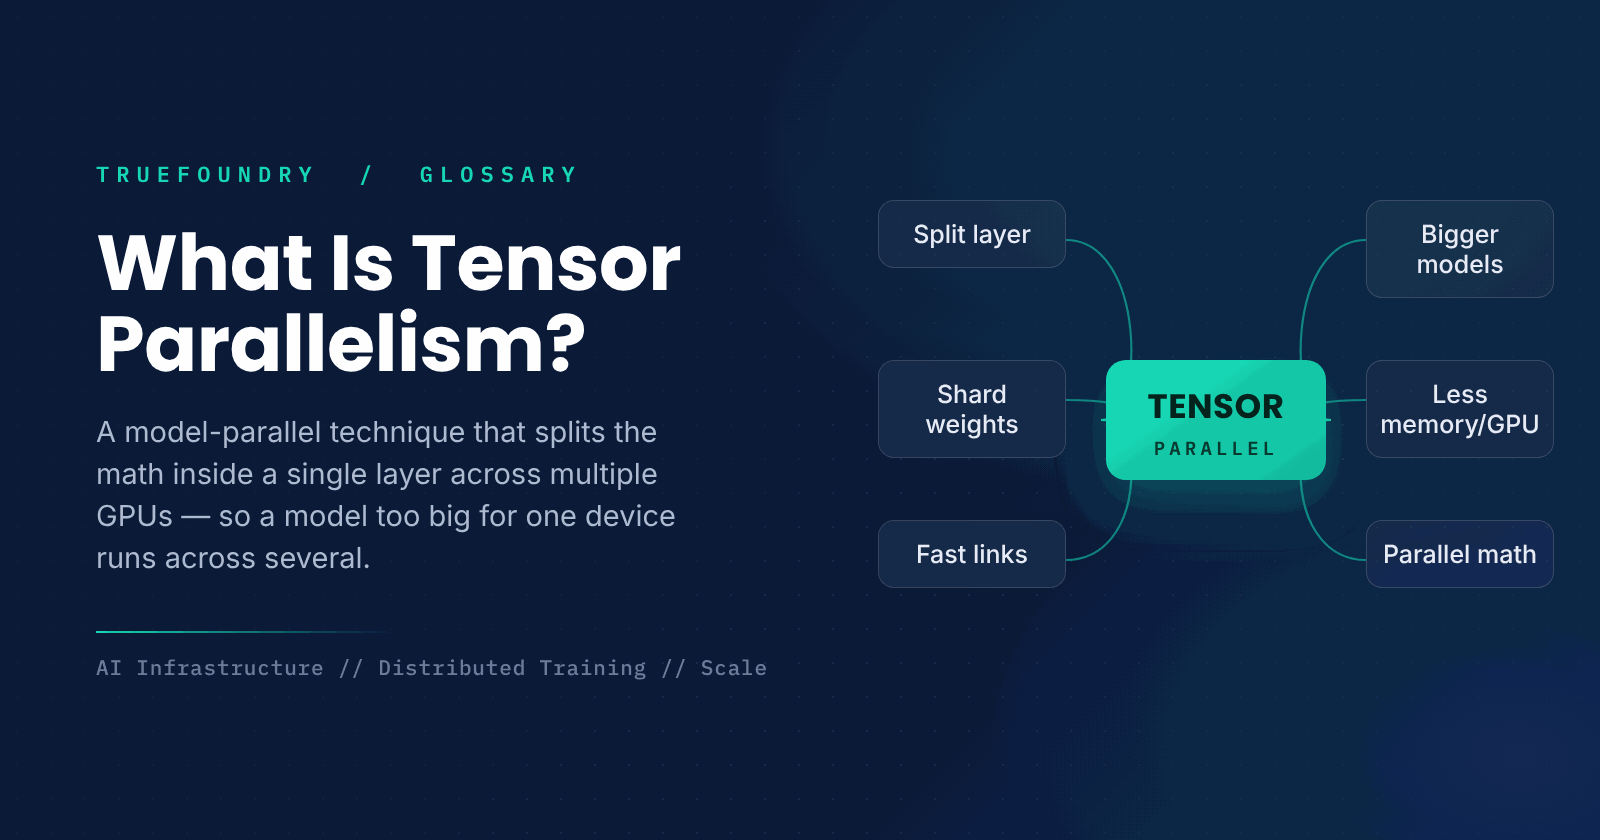
Moderne grote modellen kunnen te omvangrijk zijn voor één enkele GPU, zelfs alleen al om de gewichten op te slaan. Wanneer dat gebeurt, moet het werk worden verdeeld over meerdere GPU's, en er zijn verschillende manieren om dit te doen. Tensor-parallelisme is een van de belangrijkste: het verdeelt de berekeningen binnen elke laag over apparaten, zodat meerdere GPU's samenwerken aan dezelfde operatie.
Dit is anders dan simpelweg verschillende lagen op verschillende GPU's plaatsen. Tensor-parallelisme hakt de matrixoperaties van een enkele laag in stukken, geeft elke GPU een deel om te berekenen en combineert vervolgens de resultaten. Het is een hoeksteen voor het trainen en serveren van de grootste modellen. Deze gids legt uit wat het is, hoe het werkt en wanneer het van belang is.
We behandelen de definitie, de werking, hoe het zich verhoudt tot andere parallellisatiestrategieën en wanneer je het moet gebruiken.
Wat is tensor-parallelisme?
Tensor-parallelisme is een techniek voor model-parallellisatie die de berekening binnen een enkele laag verdeelt over meerdere GPU's. De grote matrices waaruit de operaties van een laag bestaan, worden in brokken verdeeld; elke GPU berekent zijn eigen brok en de gedeeltelijke resultaten worden gecombineerd tot de volledige output. Elke GPU bevat dus slechts een fractie van de gewichten van de laag en voert een fractie van het rekenwerk uit.
Zie het als meerdere accountants die tegelijkertijd aan één gigantisch spreadsheet werken. In plaats van dat ze elk een ander spreadsheet nemen, verdelen ze de kolommen van hetzelfde bestand, telt ieder zijn eigen kolommen op en voegen ze daarna de stukken samen. Tensor-parallelisme verdeelt het werk van één laag op dezelfde manier.
Het kernidee is splitsen binnen een laag, niet over lagen heen. Dit maakt het mogelijk om een laag uit te voeren waarvan de gewichten of activaties te groot zijn voor één enkele GPU om zelfstandig vast te houden.
Hoe werkt tensor-parallelisme?
Tensor-parallelisme partitioneert de matrices van elke laag, berekent parallel en combineert de resultaten.
- Partitioneer de gewichten. Splits de grote matrices van elke laag over GPU's.
- Distribueer de input. Stuur de benodigde input naar elke GPU.
- Bereken parallel. Elke GPU vermenigvuldigt zijn deel van de matrix.
- Communiceer. GPU's wisselen gedeeltelijke resultaten uit via snelle verbindingen.
- Combineer. Voeg de onderdelen samen tot de volledige laagoutput.
Omdat GPU's binnen elke laag gedeeltelijke resultaten moeten uitwisselen, is tensor-parallelisme afhankelijk van zeer snelle verbindingen tussen apparaten. Het is het meest effectief wanneer de GPU's nauw met elkaar verbonden zijn, zoals binnen één server, waar de communicatiekosten klein blijven in verhouding tot de bespaarde rekenkracht.
Tensor- vs. pipeline- vs. dataparallelisme
Dataparallelisme plaatst een volledige kopie van het model op elke GPU en verdeelt de data erover; dit schaalt de doorvoer, maar vereist dat het hele model op één apparaat past. Pipeline-parallelisme plaatst verschillende lagen op verschillende GPU's, zodat een model dat te diep is voor één apparaat in fasen kan draaien. Tensor-parallelisme splitst daarentegen binnen elke laag, zodat een enkele laag die te groot is voor één GPU toch kan draaien.
Deze strategieën zijn complementair en worden vaak gecombineerd. Een zeer groot model kan tensor-parallelisme binnen elke server gebruiken, pipeline-parallelisme over servers heen, en dataparallelisme over replica's. Tensor-parallelisme lost specifiek het probleem op van een laag die te groot is voor één GPU, ten koste van intensieve communicatie binnen de laag.
Waarom is tensor-parallelisme belangrijk?
- Schaal. Het stelt modellen die te groot zijn voor één GPU in staat om over meerdere GPU's te draaien.
- Geheugen. Elke GPU bevat slechts een fractie van de gewichten van elke laag.
- Snelheid. De gesplitste berekeningen worden parallel uitgevoerd over verschillende apparaten.
- Composability. Het is te combineren met pipeline- en dataparallelisme.
- Basis.Het vormt de basis voor het trainen en serveren van de grootste modellen.
Wat zijn de uitdagingen?
- Communicatie. GPU's moeten binnen elke laag resultaten uitwisselen.
- Interconnect. Het vereist snelle verbindingen, idealiter binnen één server.
- Complexiteit.Het correct splitsen van lagen is complex om te implementeren.
- Afnemende meeropbrengst. Te veel GPU's zorgen voor een sterke stijging van de communicatiekosten.
Wanneer moet je tensor-parallelisme gebruiken?
Gebruik tensor-parallelisme wanneer een model, of zelfs een enkele laag, te groot is om op één GPU te passen. Het is essentieel voor de grootste modellen, waarbij geen enkel apparaat de gewichten kan bevatten, en het is het meest effectief wanneer de samenwerkende GPU's een snelle interconnect delen, zoals die in één server.
Als je model al op één GPU past, heb je geen tensor-parallelisme nodig en kan eenvoudigere dataparallelisme beter volstaan. Maar voor echt grote modellen is het een van de kerninstrumenten die training en serving überhaupt mogelijk maken.
Belangrijke punten over tensor-parallelisme
- Tensor-parallelisme verdeelt de berekeningen van één laag over meerdere GPU's.
- Elke GPU bevat en berekent een deel van dezelfde operatie.
- Het maakt modellen mogelijk die te groot zijn voor één GPU.
- Het vereist snelle interconnects om gedeeltelijke resultaten uit te wisselen.
- Het is te combineren met pipeline- en dataparallelisme.
- Het is essentieel voor het trainen en serveren van grote modellen.
Conclusie
Tensor-parallelisme maakt het mogelijk om modellen te draaien die te groot zijn voor één GPU door de berekeningen binnen elke laag te verdelen over meerdere apparaten. Elke GPU berekent een deel van dezelfde operatie en de gedeeltelijke resultaten worden gecombineerd, waardoor een laag die op geen enkel apparaat zou passen, toch kan worden uitgevoerd. Het is een hoeksteen voor het trainen en serveren van de grootste modellen, vooral wanneer GPU's snelle interconnects delen.
TrueFoundry helpt teams om grote modellen efficiënt te trainen en te serveren op hun eigen infrastructuur, inclusief de parallelle strategieën die een model over vele GPU's verspreiden. Wanneer een model uit zijn jasje groeit op één apparaat, is tensor-parallelisme een van de belangrijkste technieken om het draaiende te houden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is tensor parallelism in simple terms?
This is how models are run across multiple GPUs, with the computations within each layer split up. Rather than a single GPU performing an operation in its entirety, multiple GPUs each perform part of it and their results are then combined. This lets a model too big for one GPU run on several together.
How is tensor parallelism different from pipeline parallelism?
In pipeline parallelism, different layers are allocated to different GPUs, enabling the model to run in stages. In tensor parallelism, each layer is split and its computations are distributed between multiple GPUs. They solve different problems and are usually combined.
Why does tensor parallelism need fast interconnects?
Because the GPUs must exchange partial results within every layer. That communication happens continuously during computation, so slow links would dominate the runtime. It works best when the cooperating GPUs share a fast connection, such as those inside a single server.
Can tensor parallelism be combined with other strategies?
Yes, and generally it is for very large models. A typical setup uses tensor parallelism within each server, pipeline parallelism between servers, and data parallelism between replicas, so the three techniques combined scale the model far beyond one GPU.
When do I need tensor parallelism?
When your model, or even just a single layer, is too big to fit into one GPU. It becomes crucial for the biggest models. If your model already fits into one device, you do not need it, and simpler data parallelism may work better.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


