


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Supervised Fine-Tuning en waarom is het belangrijk?

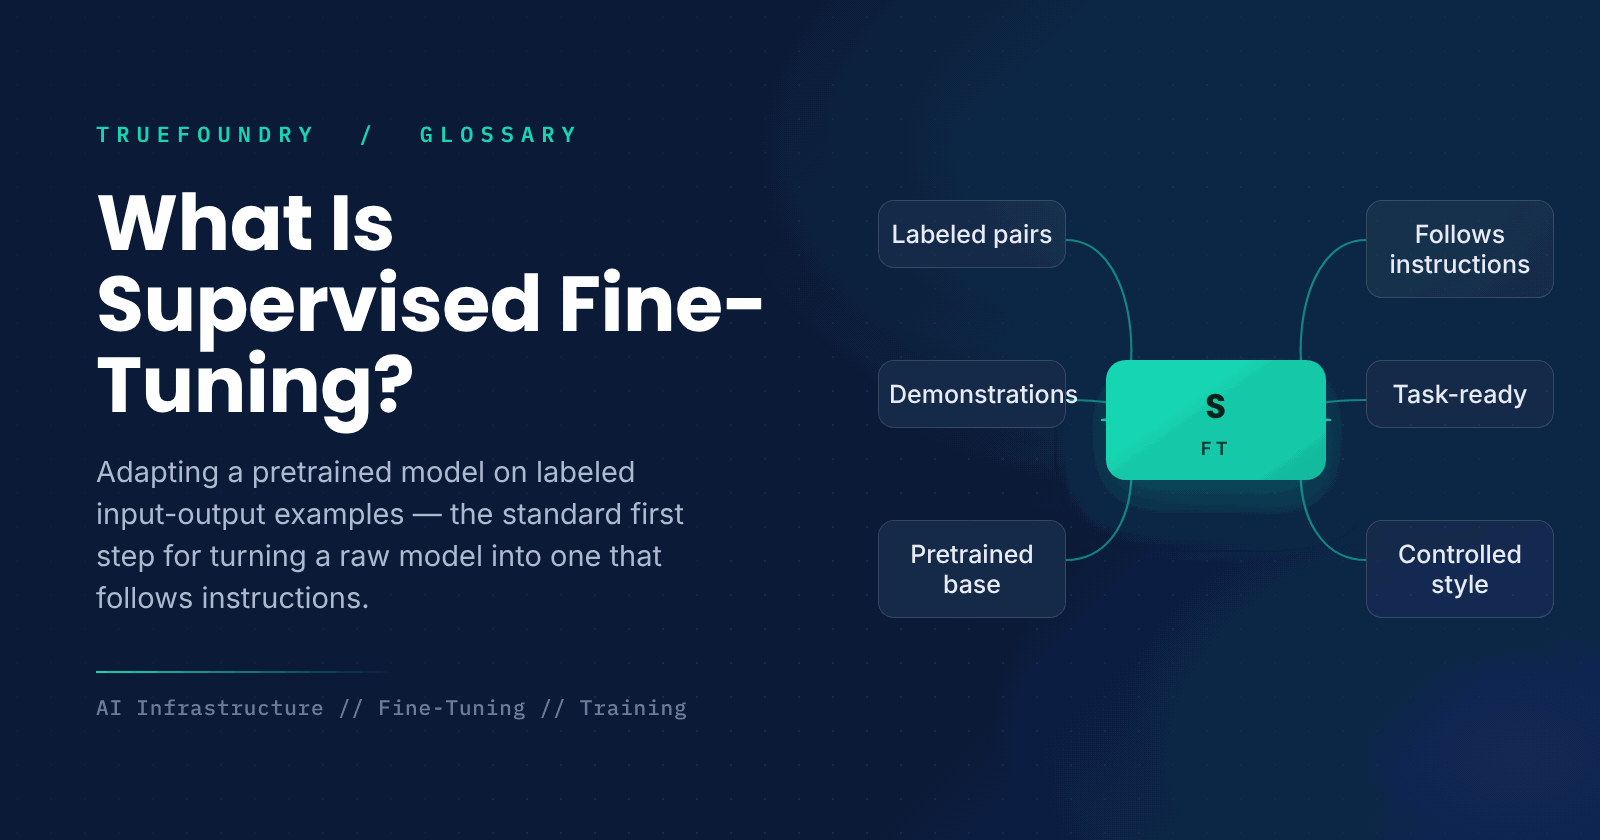
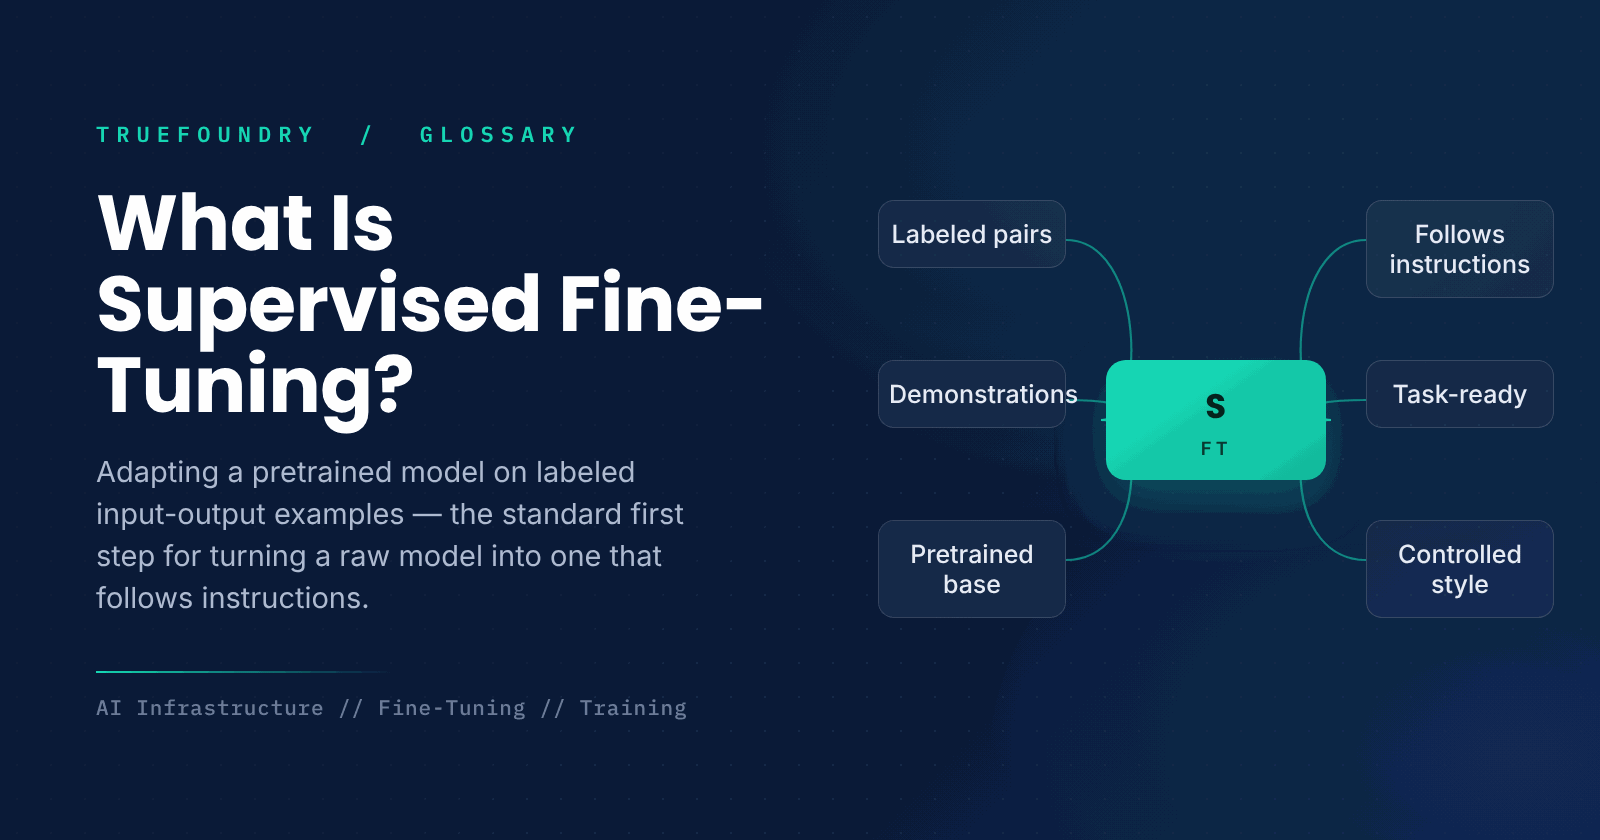
Een vooraf getraind taalmodel heeft brede kennis opgenomen uit enorme hoeveelheden tekst, maar doet nog niet betrouwbaar wat je vraagt. Het kan tekst aanvullen, maar het is niet geleerd om instructies op te volgen, in een bepaalde stijl te antwoorden of een specifieke taak uit te voeren. Supervised fine-tuning is de manier waarop je dit aanleert door te trainen op samengestelde voorbeelden van precies het gedrag dat je wilt zien.
Dit is de standaard eerste stap bij het aanpassen van een model voor daadwerkelijk gebruik. Door het model veel input-outputparen te tonen die het juiste antwoord demonstreren, stuur je de gewichten bij om dit gedrag te imiteren, waardoor een algemene voorspeller verandert in een nuttige assistent of taakspecifieke tool. Deze gids legt uit wat supervised fine-tuning is, hoe het werkt en waar het in het proces past.
We behandelen de definitie, het trainingsproces, hoe het zich verhoudt tot pretraining en preference tuning, en wanneer je het moet gebruiken.
Wat is supervised fine-tuning?
Supervised fine-tuning, vaak afgekort tot SFT, is het proces waarbij een vooraf getraind model verder wordt getraind op een gelabelde dataset van input-outputparen, zodat het leert om de gewenste output te produceren bij de gegeven input. Omdat elk voorbeeld voorzien is van het juiste antwoord, is de training 'supervised' (begeleid): het model krijgt direct het doelantwoord te zien en past zich aan om dit te evenaren.
Zie het als een stage na een algemene opleiding. Het vooraf getrainde model weet al veel over taal en de wereld, als een belezen afgestudeerde. Supervised fine-tuning is de praktijktraining waarbij het model uitgewerkte voorbeelden krijgt van de exacte taken die het gaat uitvoeren, en leert om dat gedrag te reproduceren.
Het kernidee is leren van demonstraties. Je leert het model niet zozeer nieuwe feiten, maar eerder hoe het moet reageren: welk formaat het moet gebruiken, welke instructies het moet opvolgen en hoe een goed antwoord voor jouw taak eruitziet.
Hoe werkt supervised fine-tuning?
SFT traint het model om voor elke input de gelabelde doel-output te reproduceren.
- Verzamel data. Verzamel input-outputparen die het gewenste gedrag demonstreren.
- Begin bij de basis. Start met een vooraf getraind model.
- Train op paren. Toon elke input en laat het model de doel-output voorspellen.
- Pas gewichten aan. Update het model om het verschil met de doelwaarden te verkleinen.
- Evalueer.Test op achtergehouden voorbeelden om te bevestigen dat het model generaliseert.
Het trainingsdoel is om de output van het model te laten overeenstemmen met het gelabelde doel voor elke input. Door middel van vele voorbeelden leert het model het algemene patroon in plaats van specifieke antwoorden uit het hoofd te leren. Het resultaat is een model dat reageert in de gedemonstreerde stijl en de soorten instructies in de trainingsdata opvolgt.
SFT versus pretraining versus voorkeursafstemming
Pretraining leert het model algemene taal en kennis aan op basis van enorme hoeveelheden ongelabelde tekst, zonder een specifieke taak voor ogen. Daarna volgt supervised fine-tuning, waarbij gelabelde voorbeelden worden gebruikt om het model te leren instructies op te volgen en taken uit te voeren. Dit bouwt direct voort op de basis die met pretraining is gelegd.
Voorkeursafstemming, zoals RLHF of DPO, komt meestal na SFT. In plaats van het model één enkel correct antwoord te tonen, leert het model welke van verschillende antwoorden de voorkeur van mensen geniet, waardoor toon, behulpzaamheid en veiligheid worden verfijnd. SFT zorgt voor competent gedrag; voorkeursafstemming polijst dit naar menselijke voorkeuren.
Waarom is supervised fine-tuning belangrijk?
- Instructies opvolgen. Het verandert een ruw model in een model dat prompts opvolgt.
- Taakspecialisatie. Het past een algemeen model aan op jouw specifieke taak.
- Controle.Het vormt de opmaak, stijl en toon aan de hand van voorbeelden.
- Basis. Het vormt de basis voor latere voorkeursafstemming.
- Datagebruik. Een bescheiden set goede voorbeelden kan al veel bereiken.
Wat zijn de uitdagingen?
- Datakwaliteit. Slechte of inconsistente voorbeelden leiden tot slecht gedrag.
- Labelkosten. Het creëren van voorbeelden van hoge kwaliteit kost echt moeite.
- Overfitting. Een te beperkte dataset kan het algemene vermogen schaden.
- Beperkingen van de scope. SFT alleen is mogelijk niet voldoende om genuanceerde menselijke voorkeuren vast te leggen.
Wanneer moet je supervised fine-tuning gebruiken?
Gebruik supervised fine-tuning wanneer je wilt dat een model specifieke instructies opvolgt, een bepaalde stijl aanneemt of een taak uitvoert die met alleen prompting niet betrouwbaar kan worden afgehandeld. Het is de juiste methode wanneer je beschikt over, of kunt beschikken over, een set gelabelde voorbeelden die het gewenste gedrag demonstreren.
Als een goed geformuleerde prompt bij een capabel model al voldoet, heb je wellicht helemaal geen fine-tuning nodig. Maar wanneer je consistent, gespecialiseerd gedrag vereist, is supervised fine-tuning de standaard en meest directe manier om dit te bereiken, en meestal de eerste stap vóór enige vorm van preference tuning.
Kernpunten over supervised fine-tuning
- SFT past een voorgetraind model aan met behulp van gelabelde input-outputparen.
- Het leert het model om gedemonstreerd gedrag te imiteren.
- Het verandert een basismodel in een model dat instructies opvolgt.
- Het gaat meestal vooraf aan preference tuning zoals RLHF of DPO.
- Datakwaliteit is de belangrijkste factor voor het resultaat.
- Het is ideaal wanneer prompting alleen niet betrouwbaar genoeg is.
Conclusie
Supervised fine-tuning is de manier waarop een voorgetraind model wordt geleerd hoe het zich moet gedragen, door het te trainen op gelabelde voorbeelden van de gewenste inputs en outputs. Het is de standaard eerste stap bij het aanpassen van een model voor praktisch gebruik, waarbij een algemene voorspeller wordt omgezet in een model dat instructies opvolgt en specifieke taken uitvoert. De kwaliteit van de demonstratiedata bepaalt grotendeels hoe goed het resultaat is.
TrueFoundry helpt teams om modellen efficiënt te fine-tunen en te serveren op hun eigen infrastructuur, inclusief supervised fine-tuning-pipelines die basismodellen omvormen tot taakgerichte assistenten. Wanneer je betrouwbaar, gespecialiseerd gedrag nodig hebt, is SFT het startpunt van de aanpassing.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is supervised fine-tuning in simple terms?
It means teaching a pretrained model by example. You give it many input-output pairs that show the correct response, and it adjusts to imitate them, turning a general model into one that follows instructions and handles specific tasks.
How is SFT different from pretraining?
Pretraining enables the model to learn language and knowledge from large amounts of text that are not labeled and have no particular task assigned to them. SFT follows pretraining and uses labeled samples to teach the model to carry out tasks and follow instructions, building on what pretraining established.
How is SFT different from RLHF or DPO?
SFT gives the model only one right way of responding to each input. Preference tuning such as RLHF or DPO instead trains the model on which response among many options people prefer. SFT is usually done first to establish competent behavior, and preference tuning then refines it toward human preferences.
How much data does supervised fine-tuning need?
This depends on the task itself; however, quality always matters more than sheer quantity. In many cases, a few examples created in a thoughtful and consistent way work better than a large but noisy set, because the model learns the behavior the examples demonstrate, good or bad.
When should I use SFT instead of just prompting?
Use SFT in cases where merely giving prompts is insufficient to elicit the required behavior from your model, or when you need consistent style, format, or task performance. If you have a great prompt for a strong model, you might not even need SFT.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


