


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Speculative Decoding en waarom is het belangrijk?

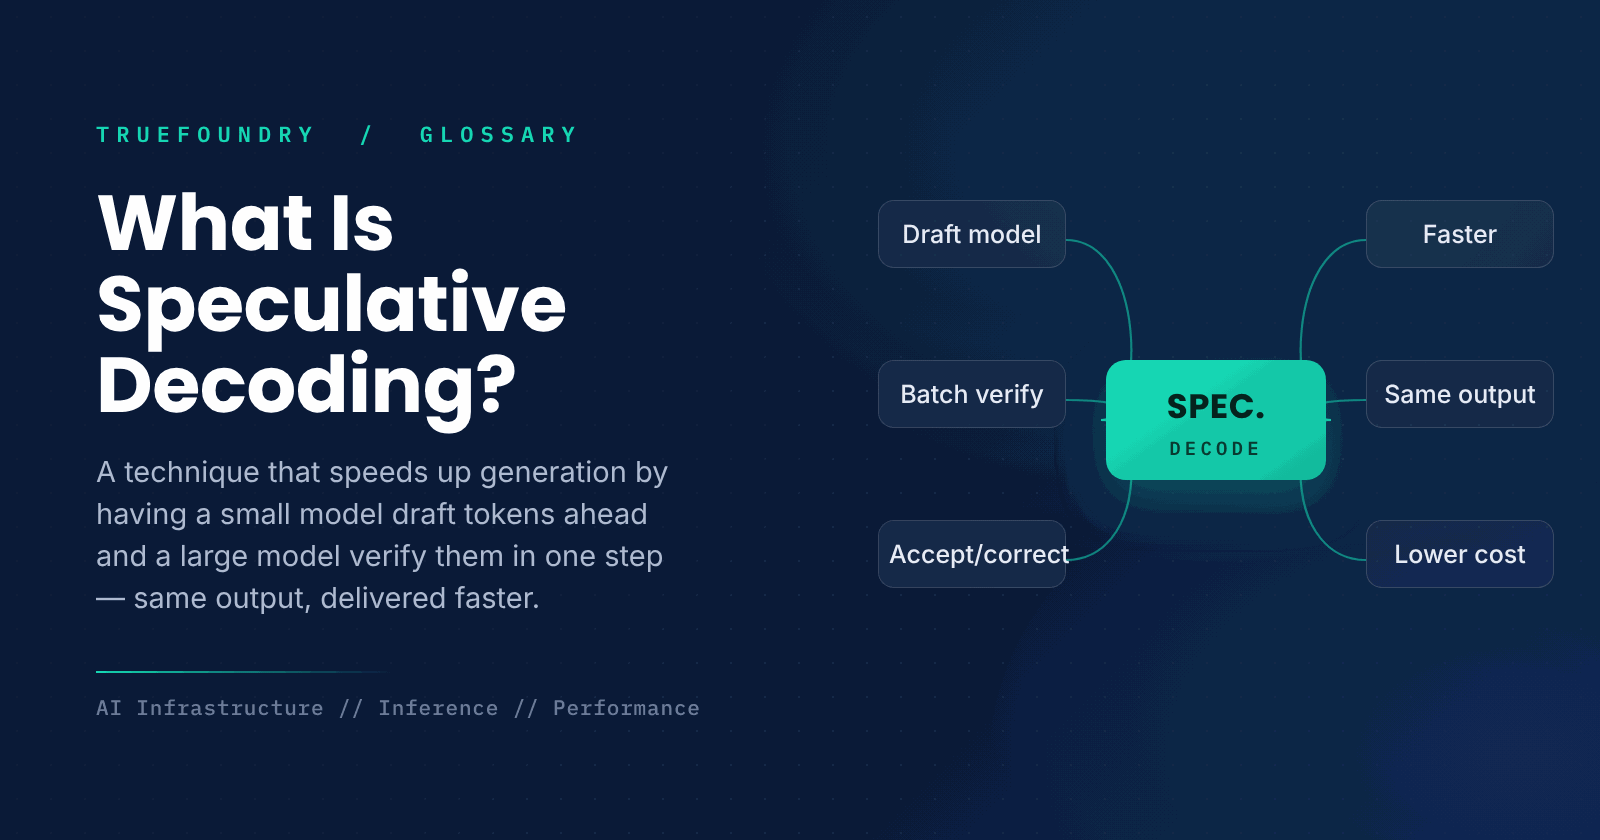
Taalmodellen genereren tekst token voor token, waarbij elk token een volledige doorloop door het model vereist. Voor een groot model is dat traag en kostbaar, omdat elk afzonderlijk token een zware berekening betekent. Speculative decoding is een slimme manier om dit te versnellen zonder de output van het model te veranderen.
Het idee is om een klein, snel model alvast enkele tokens vooruit te laten gokken en het grote model vervolgens al die gokken in één keer te laten controleren. Het verifiëren van een reeks tokens in één doorloop is veel sneller dan ze stuk voor stuk genereren, waardoor het grote model effectief meerdere tokens per stap produceert. Deze gids legt uit hoe het werkt en waarom het belangrijk is.
We behandelen de definitie, de werking, de vergelijking met standaard decoding en wanneer je het moet gebruiken.
Wat is speculative decoding?
Speculative decoding is een optimalisatie voor inferentie waarbij een groot doelmodel wordt gekoppeld aan een klein, snel conceptmodel. Het conceptmodel stelt snel enkele komende tokens voor en het grote model verifieert deze allemaal in één voorwaartse doorloop; het accepteert de tokens waarmee het instemt en corrigeert het eerste token waarmee het niet instemt. Het resultaat is dezelfde output die het grote model zou hebben geproduceerd, maar dan sneller gegenereerd.
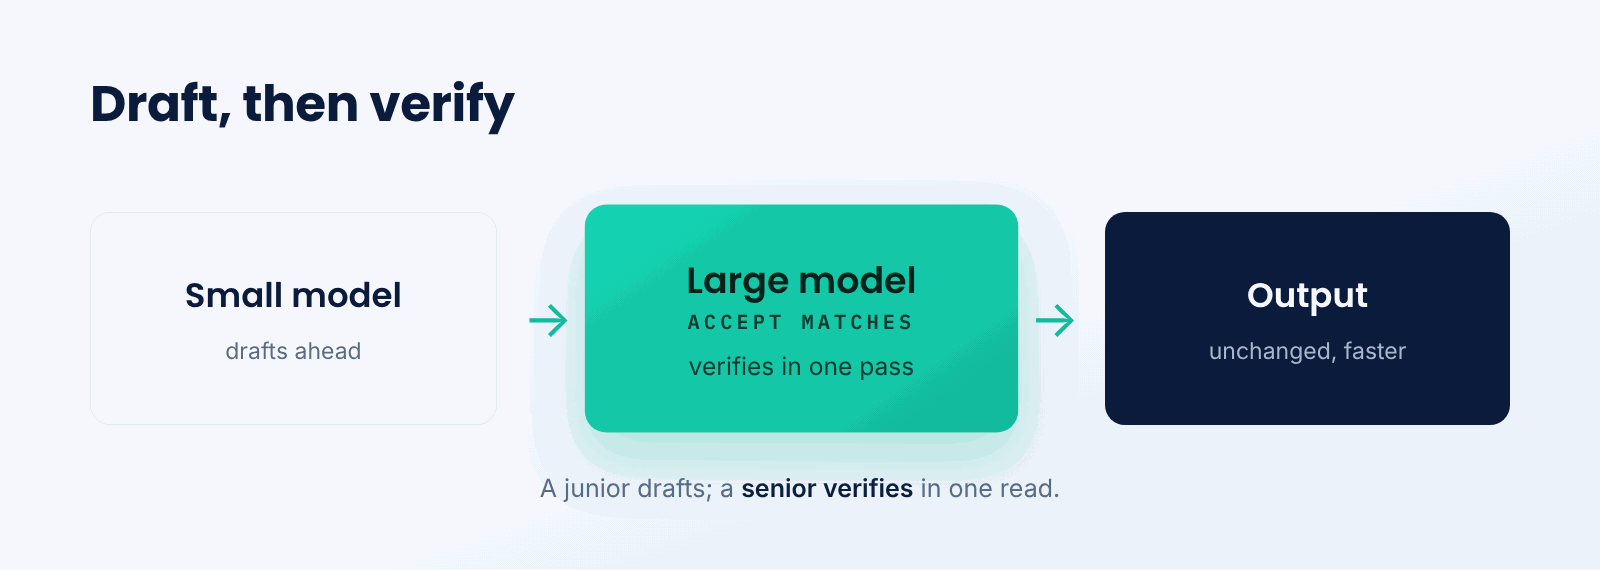
Zie het als een junior schrijver die een zin opstelt en een senior redacteur die deze in één snelle lezing controleert. De redacteur behoudt de juiste delen en corrigeert de eerste fout, wat veel sneller is dan elk woord vanaf nul schrijven. Speculative decoding koppelt op dezelfde manier een snelle opsteller aan een zorgvuldige controleur.
Het kernidee is: eerst opstellen, dan verifiëren. Omdat het controleren van meerdere voorgestelde tokens tegelijk goedkoper is dan ze individueel genereren, hoeft het dure model minder sequentieel werk te verrichten terwijl het exact dezelfde output produceert.
Hoe werkt speculative decoding?
Een klein model stelt tokens op; het grote model verifieert ze in één doorloop.
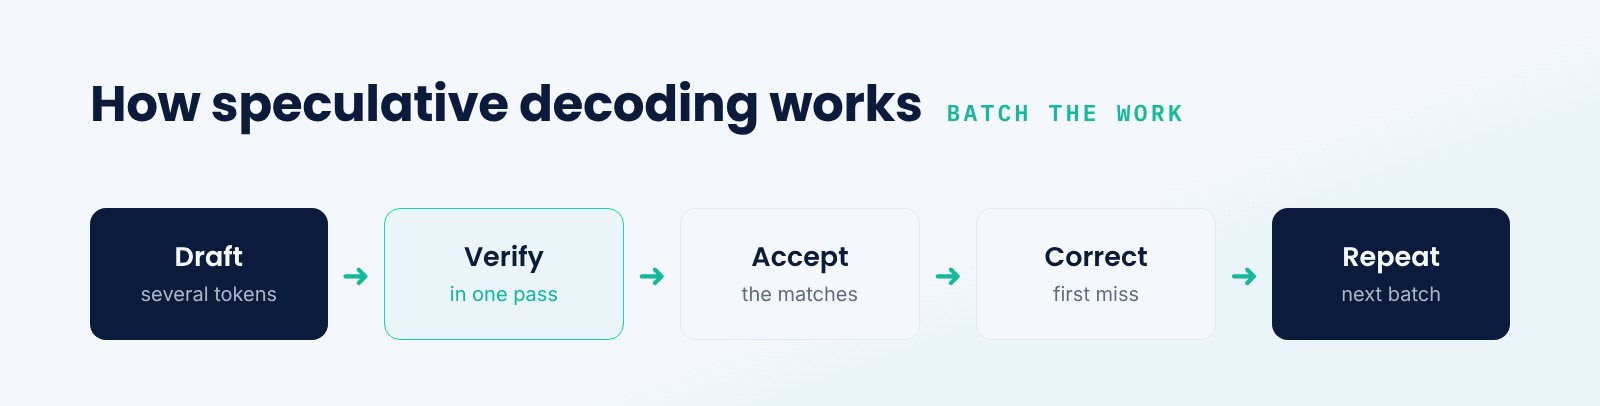
- Stel vooruit. Het kleine model stelt snel enkele volgende tokens voor.
- Verifieer samen. Het grote model controleert ze allemaal in één voorwaartse doorloop.
- Accepteer overeenkomsten. Behoud de eerste tokens waarmee het grote model instemt.
- Corrigeer de rest. Herstel de eerste afwijking en verwerp wat daarna komt.
- Herhalen.Stel de volgende reeks op vanaf het punt waar de verificatie is geëindigd.
De versnelling ontstaat doordat het grote model een reeks tokens verifieert in ongeveer de tijd die het zou kosten om er één te genereren. Wanneer de gokken van het kleine model vaak kloppen, worden er per stap veel tokens geaccepteerd, waardoor de generatie versnelt. Cruciaal is dat de verificatiestap garandeert dat de uiteindelijke output overeenkomt met wat het grote model alleen zou produceren.
Speculatieve versus standaard decodering
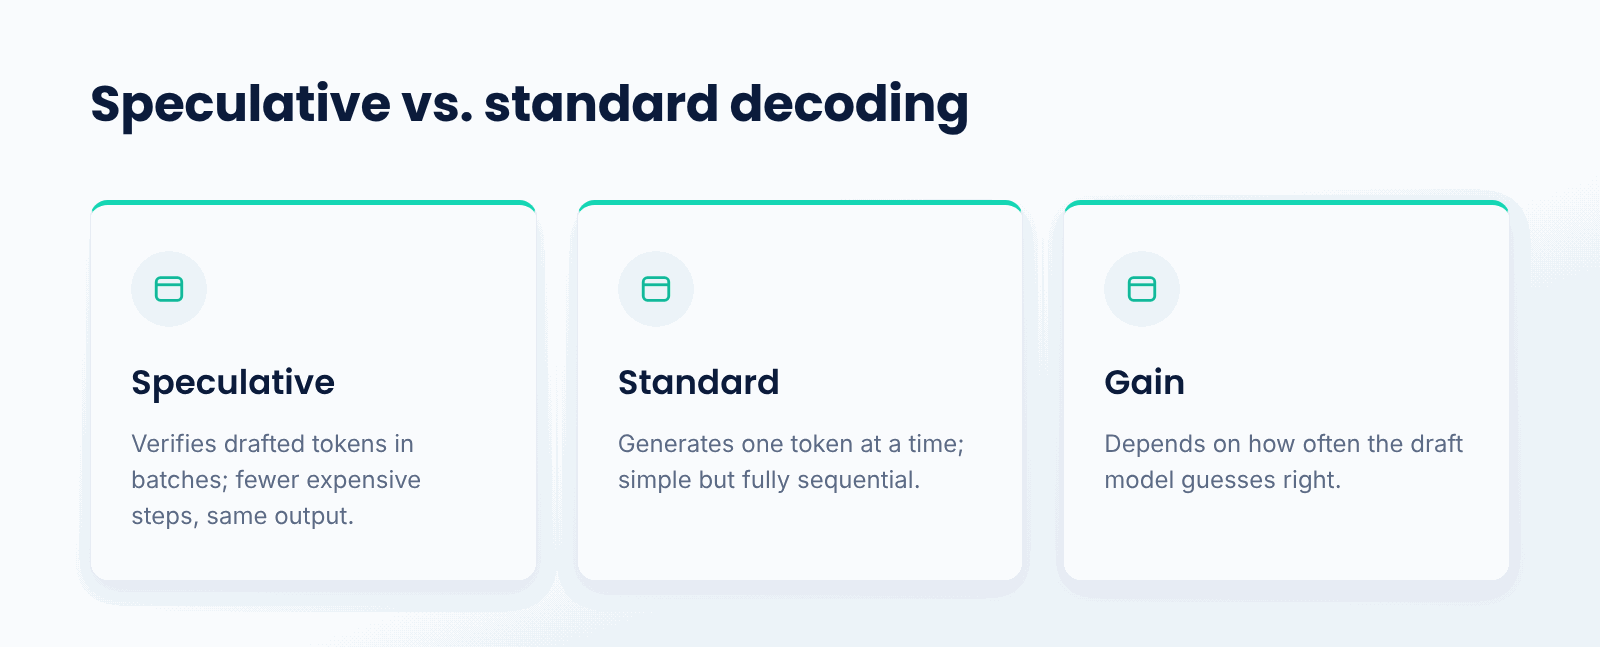
Standaard decodering genereert één token per keer, waarbij voor elk token een volledige doorloop door het grote model nodig is. Dit is eenvoudig en nauwkeurig, maar inherent sequentieel. De snelheid wordt daarom direct beperkt door de omvang van het grote model en voor elk token worden de volledige kosten in rekening gebracht.
Speculatieve decodering levert exact dezelfde output, maar vermindert het aantal kostbare sequentiële stappen door voorgestelde tokens in batches te verifiëren. De keerzijde is de extra complexiteit van het draaien van een tweede conceptmodel en het feit dat de winst afhangt van hoe vaak het concept correct is. Wanneer het conceptmodel goed aansluit, kan de snelheidswinst aanzienlijk zijn zonder verlies van kwaliteit.
Waarom is speculatieve decodering belangrijk?
- Snelheid.Het genereert tekst sneller met grote modellen.
- Dezelfde output. Het verandert niets aan wat het model produceert.
- Lagere kosten.Snellere generatie betekent goedkopere inferentie.
- Betere latentie. Antwoorden komen sneller terug.
- Efficiëntie.Het haalt meer uit dure hardware.
Wat zijn de afwegingen?
- Extra model. Het vereist het draaien van een apart conceptmodel.
- Variabele winst. De snelheidswinst hangt af van de nauwkeurigheid van het concept.
- Afstemming. Het conceptmodel moet goed passen bij het doelmodel.
- Complexiteit.De serveropzet is complexer.
Wanneer moet je speculatieve decodering gebruiken?
Gebruik speculatieve decodering wanneer je een groot taalmodel aanbiedt en snellere generatie en lagere latentie wilt zonder in te leveren op de kwaliteit van de output. Het is vooral waardevol voor interactieve toepassingen, waar reactiesnelheid belangrijk is, en op schaal, waar snellere inferentie direct de kosten verlaagt.
Als je al een klein model gebruikt, of als latentie geen rol speelt, is de extra complexiteit het misschien niet waard. Maar wanneer je de kwaliteit van een groot model nodig hebt met een hogere snelheid, is speculative decoding een van de meest effectieve manieren om dit te bereiken, aangezien het niets verandert aan de output.
Belangrijke punten over speculative decoding
- Speculative decoding versnelt de generatie zonder de output te veranderen.
- Een klein model stelt tokens voor; een groot model verifieert deze.
- Het verifiëren van een batch is sneller dan het genereren van tokens per stuk.
- Geaccepteerde tokens worden behouden; de eerste foutieve token wordt gecorrigeerd.
- De winst hangt af van hoe vaak het voorstel correct is.
- Het verlaagt de latentie en kosten van inferentie.
Conclusie
Speculative decoding versnelt de generatie van grote taalmodellen door een klein, snel model alvast enkele tokens vooruit te laten lopen, waarna een groot model deze in één stap verifieert. Omdat batch-verificatie sneller is dan het genereren van tokens per stuk, wordt tekst sneller geproduceerd en garandeert de verificatie dat de output exact is wat het grote model zou hebben gegenereerd. Het is een cruciale optimalisatie voor snellere, goedkopere inferentie met een lagere latentie.
TrueFoundry helpt teams om modellen efficiënt op hun eigen infrastructuur te draaien, inclusief inferentie-optimalisaties zoals speculative decoding die latentie en kosten verlagen zonder in te leveren op kwaliteit. Wanneer je snel antwoorden van een groot model nodig hebt, is speculative decoding een krachtig hulpmiddel.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is speculative decoding in simple terms?
It is an approach for speeding up text generation by a large language model. A fast, small model predicts a number of upcoming tokens, and the large model then validates them all together, keeping those it agrees with. Because validating a batch takes less time than generating tokens one at a time, the text comes out faster.
Does speculative decoding change the output?
No. The large model validates every drafted token and fixes the first disagreement it encounters, so the end result is exactly what the large model would have generated on its own. Speculative decoding affects speed, not output.
Why is speculative decoding faster?
Because the large model can validate several proposed tokens in roughly the time it takes to produce one. When the small draft model's predictions are often correct, many tokens are accepted per step, so the expensive model does far less sequential work.
What does speculative decoding require?
A large target model and a smaller, faster draft model that is well matched to it. The draft model proposes tokens and the target model validates them. This setup is more complex than standard decoding, and the speedup depends on how often the draft model is right.
When should I use speculative decoding?
When serving a large model and you want faster generation and lower latency without sacrificing quality, especially for interactive applications or at scale where speed cuts cost. If latency is not a concern, the extra complexity may not be worth it.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


