


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Serverless Inference en waarom is het belangrijk?

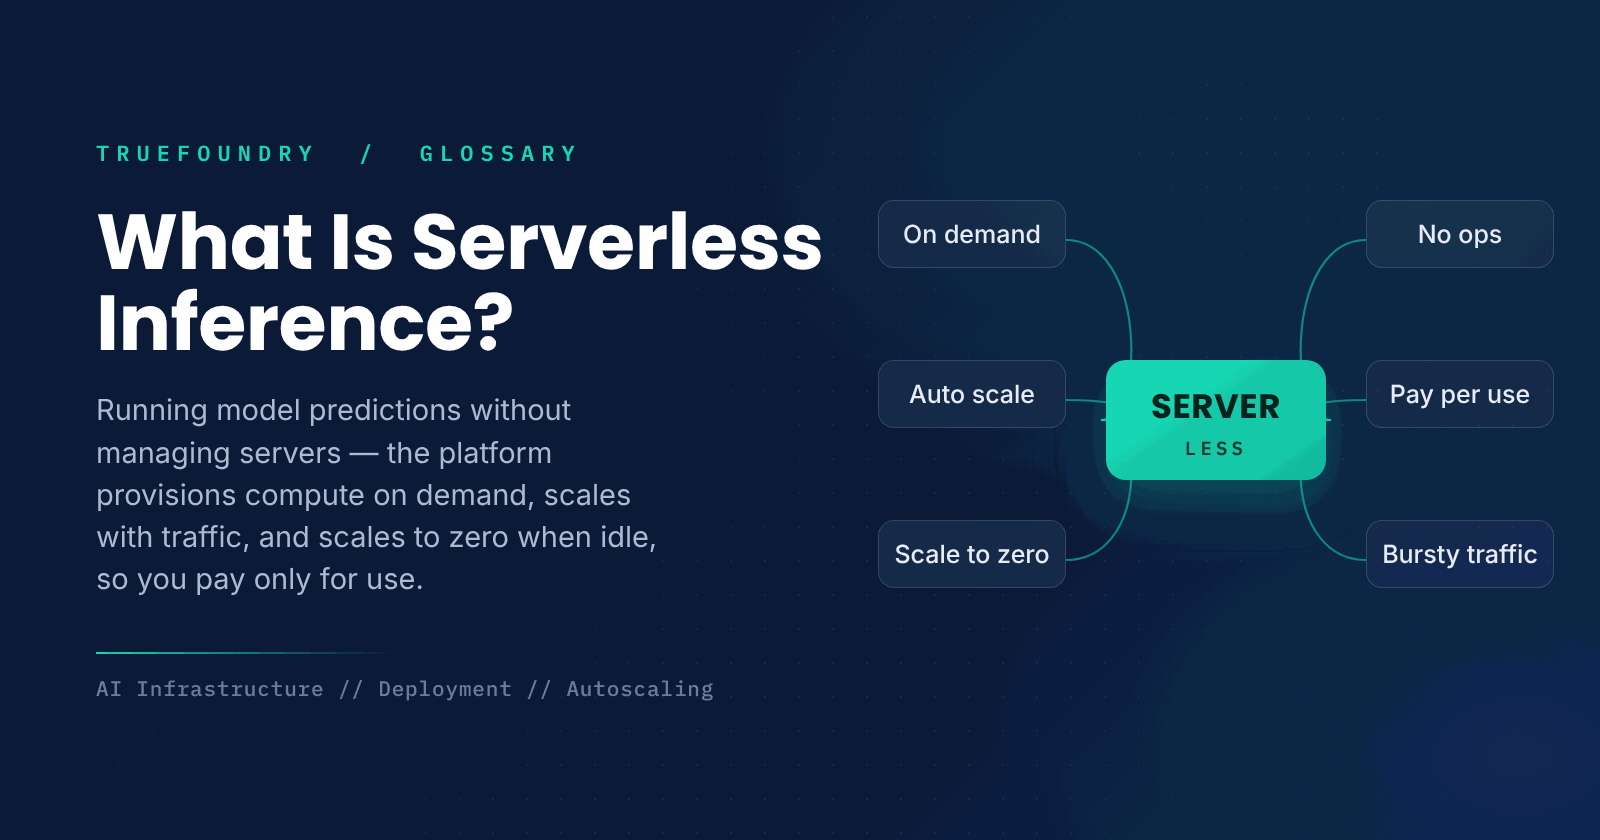
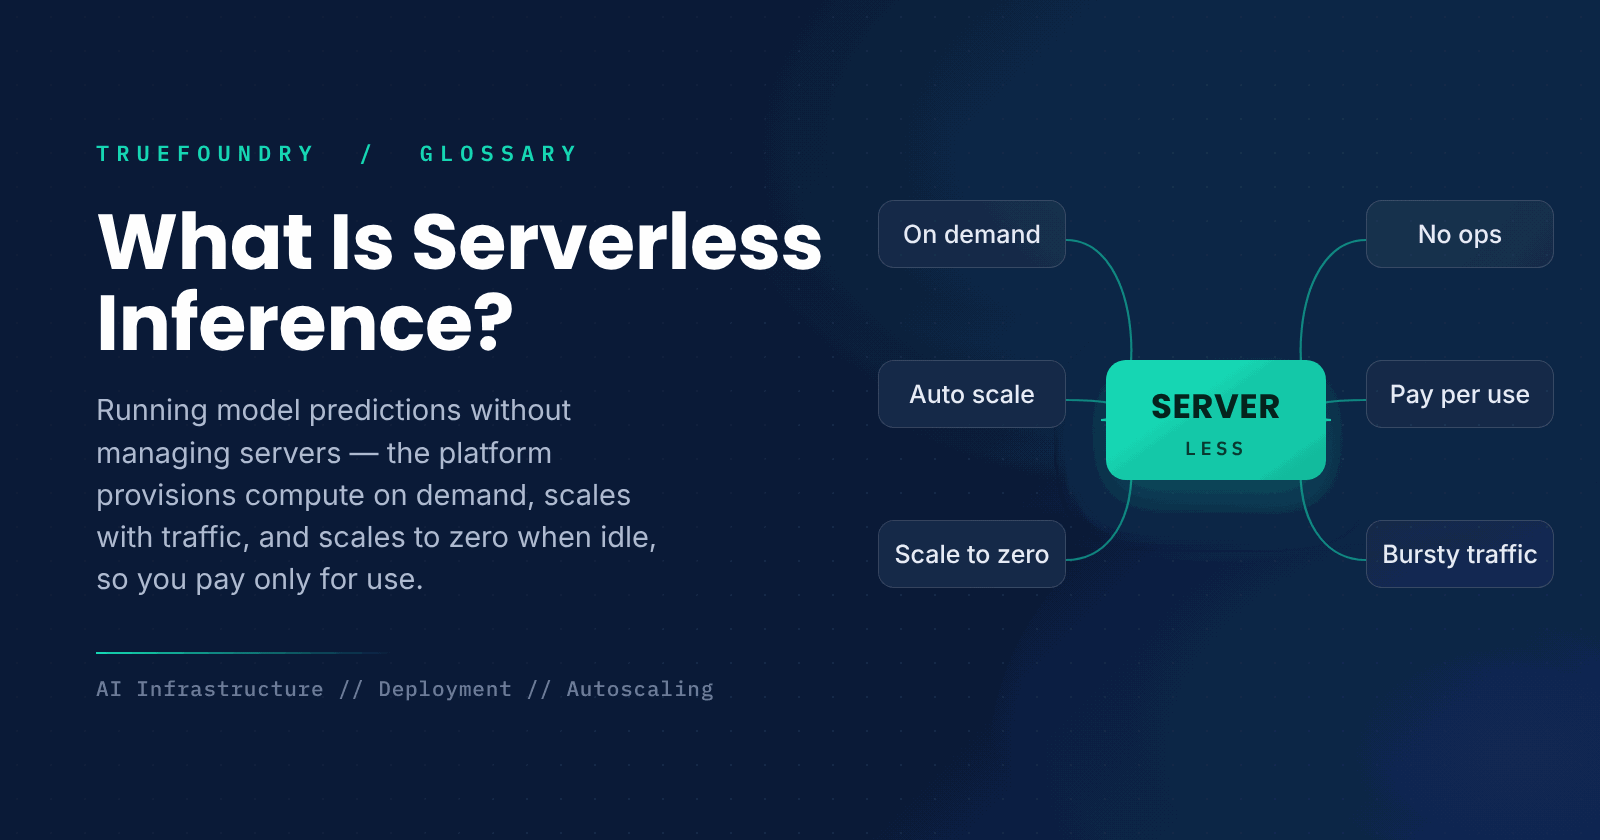
Het draaien van een model in productie betekent meestal dat er servers klaar moeten staan om verzoeken te beantwoorden. Deze moet je inrichten, schalen en betalen, ongeacht of ze druk zijn of niet. Voor workloads met onregelmatig verkeer betekent dit dat je ofwel betaalt voor ongebruikte capaciteit, of dat je moet haasten wanneer de vraag piekt. Serverless inference biedt een ander model: jij geeft je model aan het platform, en het platform regelt de infrastructuur.
Bij serverless inference wordt rekenkracht gecreëerd wanneer er verzoeken binnenkomen, geschaald op basis van de vraag en weer vrijgegeven wanneer het systeem inactief is, waardoor je alleen betaalt voor wat je gebruikt. Het neemt de last van serverbeheer weg en is geschikt voor workloads met variabel of moeilijk te voorspellen verkeer. Deze gids legt uit wat het is, hoe het werkt en wat de afwegingen zijn.
We bespreken de definitie, de werking, de vergelijking met 'always-on' serveren en wanneer je het moet gebruiken.
Wat is serverless inference?
Serverless inference is een implementatiemodel waarbij een platform de voorspellingen van je model op aanvraag uitvoert en de onderliggende rekenkracht automatisch beheert. Je hoeft geen servers in te richten of te onderhouden; in plaats daarvan wijst het platform resources toe wanneer er verzoeken binnenkomen, schaalt deze mee met de belasting en kan het terugschalen naar nul wanneer er geen verkeer is, waarbij je alleen betaalt voor het werkelijke gebruik.
Zie het als elektriciteit uit het net in plaats van een generator die je zelf bezit en moet laten draaien. Je hoeft niet dag en nacht een machine te laten draaien; je neemt stroom af wanneer je het nodig hebt en betaalt voor wat je verbruikt. Serverless inference biedt modelvoorspellingen op dezelfde manier, waarbij het platform achter de schermen de techniek regelt.
Het kernidee is het uitbesteden van infrastructuurbeheer. Jij richt je op het model en de verzoeken, en het platform zorgt voor het inrichten, schalen en afbouwen van de rekenkracht die nodig is om ze te verwerken.
Hoe werkt serverless inference?
Het platform start rekenkracht op wanneer verzoeken binnenkomen en geeft deze weer vrij wanneer ze stoppen.
- Implementeer het model. Geef het platform je model en de bijbehorende vereisten.
- Wacht in ruststand. Bij afwezigheid van verkeer draait er geen rekenkracht en betaal je niets.
- Ontvang een verzoek. Het platform wijst rekenkracht toe om het verzoek te verwerken.
- Schaal met de belasting. Het voegt capaciteit toe of verwijdert deze naarmate de vraag verandert.
- Schaal naar nul. Wanneer het verkeer stopt, wordt de rekenkracht weer vrijgegeven.
Omdat rekenkracht op aanvraag wordt gecreëerd, kan het eerste verzoek na een periode van inactiviteit vertraging oplopen terwijl resources opstarten; dit staat bekend als een cold start. Platforms proberen dit tot een minimum te beperken, maar het is het voornaamste compromis van schalen naar nul. Zodra de service warm is, reageert deze normaal en schaalt deze soepel mee met de vraag.
Serverless versus always-on inference
Bij always-on serving draait er continu toegewezen rekenkracht die direct klaarstaat om verzoeken te beantwoorden. Dit biedt een voorspelbare lage latentie zonder cold starts, maar je betaalt voor de capaciteit, zelfs als deze ongebruikt blijft, wat inefficiënt is bij onregelmatig verkeer. Het is geschikt voor stabiele workloads met een hoog volume waarbij de servers zelden inactief zijn.
Serverless inference daarentegen wordt op aanvraag ingericht en schaalt naar nul, waardoor je alleen betaalt voor het gebruik en kosten voor inactiviteit vermijdt. Het compromis is een mogelijke cold-start-latentie en minder controle over de omgeving. Het is geschikt voor variabele, grillige of kleinschalige workloads waarbij betalen voor always-on capaciteit inefficiënt zou zijn.
Waarom is serverless inference belangrijk?
- Geen serverbeheer. Het platform beheert de infrastructuur.
- Kostenefficiëntie. Je betaalt alleen voor de rekenkracht die je gebruikt.
- Automatisch schalen. De capaciteit schaalt mee met de vraag.
- Schaal naar nul. Inactieve workloads kosten niets om beschikbaar te houden.
- Snellere iteratie. Teams kunnen modellen uitrollen zonder ops-infrastructuur te bouwen.
Wat zijn de afwegingen?
- Cold starts. Het eerste verzoek na inactiviteit kan trager zijn.
- Minder controle. Je hebt beperkte invloed op de omgeving.
- Kosten bij schaalvergroting. Bij constant hoog verkeer kan always-on goedkoper zijn.
- Limieten. Grote modellen of speciale hardware worden mogelijk niet ondersteund.
Wanneer moet je serverless inference gebruiken?
Gebruik serverless inference voor workloads met variabel, onvoorspelbaar of laag verkeer, waarbij betalen voor altijd actieve servers zou leiden tot verspilling van capaciteit. Het is ideaal voor nieuwe applicaties, interne tools en piekbelastingen, en voor teams die modellen willen implementeren zonder infrastructuur te beheren.
Voor stabiel verkeer met een hoog volume, waarbij servers zelden inactief zouden zijn, of waar de latentie van een 'cold start' onacceptabel is, kan altijd actieve hosting de betere keuze zijn. Het afstemmen van het hostingmodel op het verkeerspatroon is wat zowel de kosten als de latentie onder controle houdt.
Belangrijke punten over serverless inference
- Serverless inference voert voorspellingen uit zonder dat je servers hoeft te beheren.
- Rekenkracht wordt op aanvraag toegewezen en schaalt mee met de belasting.
- Het kan naar nul schalen, dus inactieve tijd kost niets.
- Je betaalt alleen voor de rekenkracht die je gebruikt.
- Cold starts zijn het voornaamste nadeel van schalen naar nul.
- Het is geschikt voor variabele, onregelmatige of kleinschalige workloads.
Conclusie
Met serverless inference kun je modelvoorspellingen uitvoeren zonder de onderliggende servers te beheren. Het platform voorziet op aanvraag in rekenkracht, schaalt mee met het verkeer en geeft resources vrij wanneer ze inactief zijn. Je betaalt alleen voor wat je gebruikt en vermijdt de kosten van onbenutte capaciteit, met als mogelijke keerzijde de latentie van een cold start. Voor variabele of onvoorspelbare workloads is dit een efficiënte manier met weinig overhead om modellen te serveren.
TrueFoundry helpt teams bij het implementeren en serveren van modellen op hun eigen infrastructuur, inclusief autoscaling en 'scale-to-zero'-hosting, waardoor de kosten voor inference in lijn blijven met de werkelijke vraag. Wanneer het verkeer onregelmatig is, is serverless-stijl inference de manier om efficiënt te werken zonder te betalen voor inactieve servers.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is serverless inference in simple terms?
It means you do not have to manage any servers at all, since the service creates compute when requests come in, scales it with demand, and stops it when idle. This way you pay only for the compute you use, much like pulling electricity from the grid instead of running your own generator.
What is a cold start?
It is the delay on the first request after a period of no activity, while the platform provisions and warms up compute to handle it. This is the main compromise of scaling to zero; platforms aim to reduce it, and once warmed up the service performs normally.
How is serverless different from always-on inference?
Always-on serving keeps compute running continuously, ready to respond instantly and predictably, but you are charged even when it is idle. Serverless works based on usage and can scale to zero, charging you only when you use it. The tradeoff is possible cold-start latency and less control over the environment.
Does serverless inference save money?
For low or unpredictable traffic, usually yes, because you avoid paying for idle capacity. For predictable high-volume traffic, where servers would rarely be idle, always-on serving can be cheaper. The savings depend on how uneven your traffic is.
When should I use serverless inference?
For bursty or low-volume jobs, new services, internal tools, and whenever you want to deploy models without managing your own infrastructure. For consistently high-volume traffic and latency-sensitive uses where cold starts are unacceptable, always-on serving might be more appropriate.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


