


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Self-Supervised Learning en waarom is het belangrijk?

De doorbraak achter moderne taalmodellen is niet alleen hun omvang, maar ook de manier waarop ze worden getraind. Ze leren van enorme hoeveelheden onbewerkte tekst die door niemand is gelabeld, en toch begrijpen ze na afloop grammatica, feiten en redeneringen. De truc die dit mogelijk maakt is self-supervised learning: de data zichzelf laten superviseren.
Het idee is om een ongelabelde dataset automatisch om te zetten in een supervised probleem. Door een deel van de data te verbergen en het model te vragen dit te voorspellen op basis van de rest, creëer je een trainingssignaal zonder enige menselijke annotatie. Doe dit op grote schaal en het model leert rijke representaties van de onderliggende structuur, of dat nu taal, afbeeldingen of audio is.
Deze gids legt uit wat self-supervised learning is, hoe het werkt, hoe het zich verhoudt tot unsupervised en supervised learning, en waarom het zo belangrijk is.
Wat is self-supervised learning?
Self-supervised learning is een methode waarbij een model direct vanuit ongelabelde data supervisiesignalen genereert. Een deel van de input wordt achtergehouden en het model wordt getraind om dit te voorspellen op basis van het resterende deel. Omdat het juiste antwoord simpelweg de achtergehouden data is, worden labels automatisch aangemaakt, zonder dat daar menselijke inspanning voor nodig is.
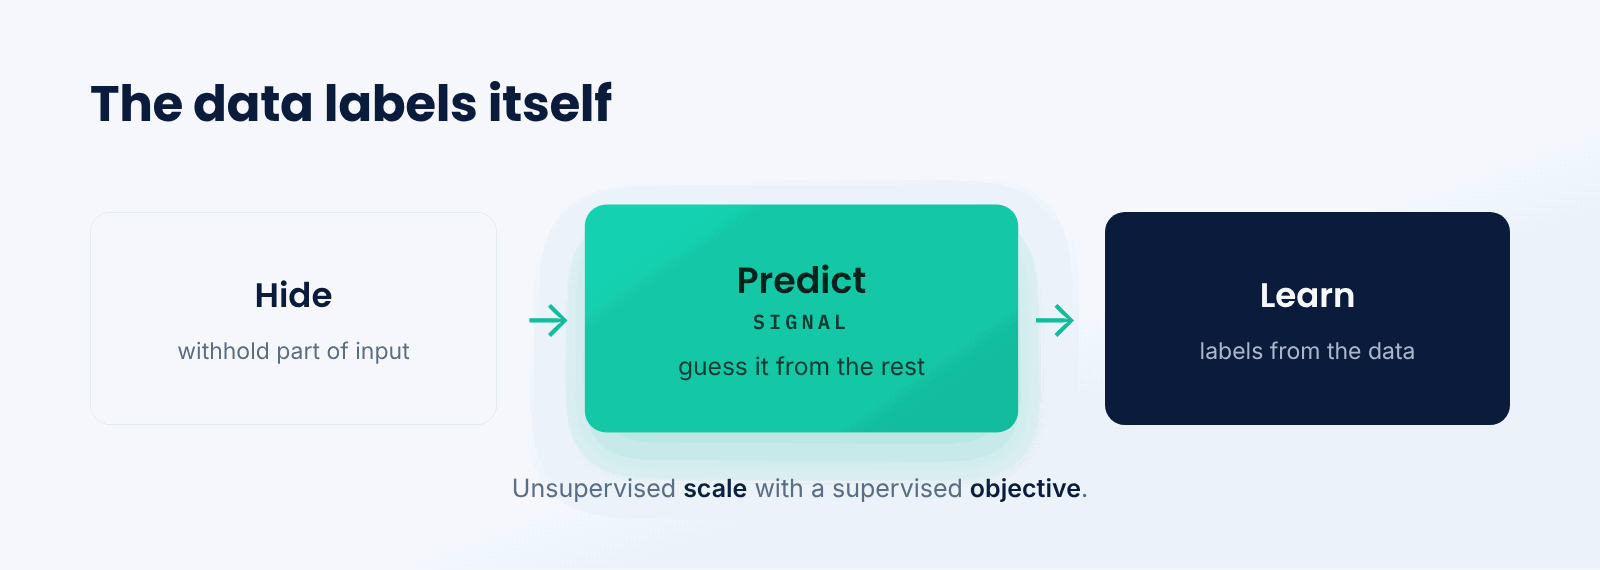
Zie het als het invullen van de open plekken in een tekst. Als je een woord in een zin afdekt en probeert te raden wat het is op basis van de omliggende woorden, test en ontwikkel je je begrip van taal. Een self-supervised model speelt dit invulspel miljarden keren en leert zo diepe patronen over hoe de data is gestructureerd.
Het kernidee is dat de data zijn eigen labels levert. Dit combineert het beste van twee werelden: het automatische, labelvrije karakter van unsupervised learning met het duidelijke voorspellende doel van supervised learning, wat het zo effectief maakt op grote schaal.
Hoe werkt self-supervised learning?
Bij de training wordt een voorspellingstaak opgezet op basis van de onbewerkte data, waarna er wordt geleerd van de pogingen van het model om deze op te lossen.
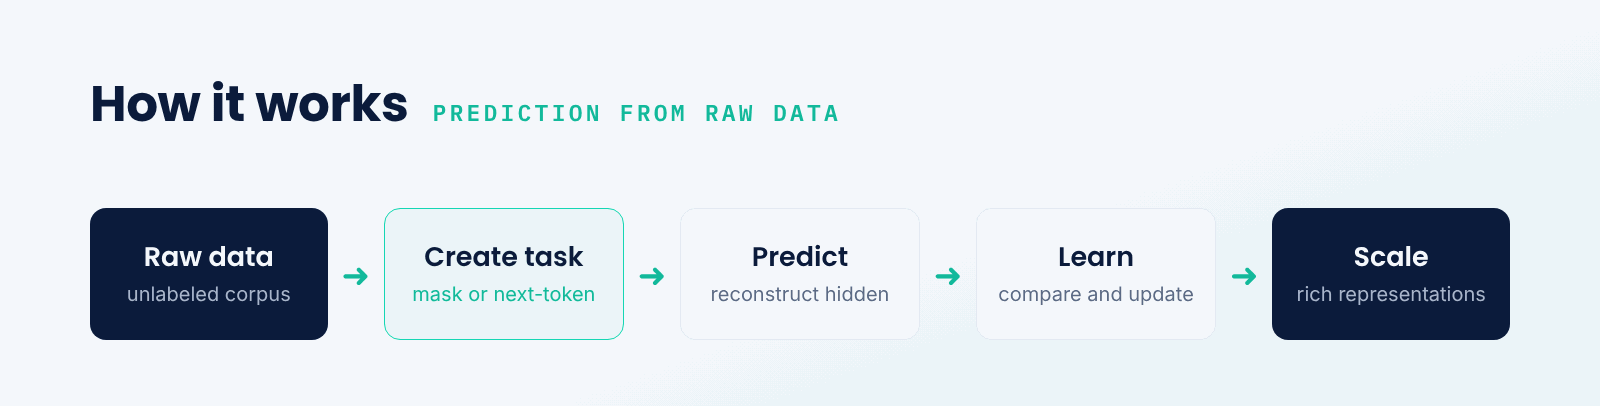
- Neem onbewerkte data. Begin met ongelabelde tekst, afbeeldingen of andere data.
- Creëer een taak. Verberg een deel van de data, zoals door woorden te maskeren of het volgende token te verbergen.
- Voorspel. Het model probeert het verborgen deel te reconstrueren op basis van wat er overblijft.
- Leer. Vergelijk de voorspelling met de werkelijke verborgen data en update het model.
- Schaal op. Herhaal dit proces bij enorme datasets om rijke representaties op te bouwen.
De klassieke taak voor taalmodellen is het voorspellen van het volgende token op basis van de voorgaande tokens. Door dit op een enorme corpus toe te passen, wordt het model gedwongen om grammatica, feiten en redeneerpatronen te leren. Dit is de reden waarom zelf-gesuperviseerde pretraining zulke capabele modellen voor algemeen gebruik oplevert.
Zelf-gesuperviseerd vs. ongesuperviseerd vs. gesuperviseerd
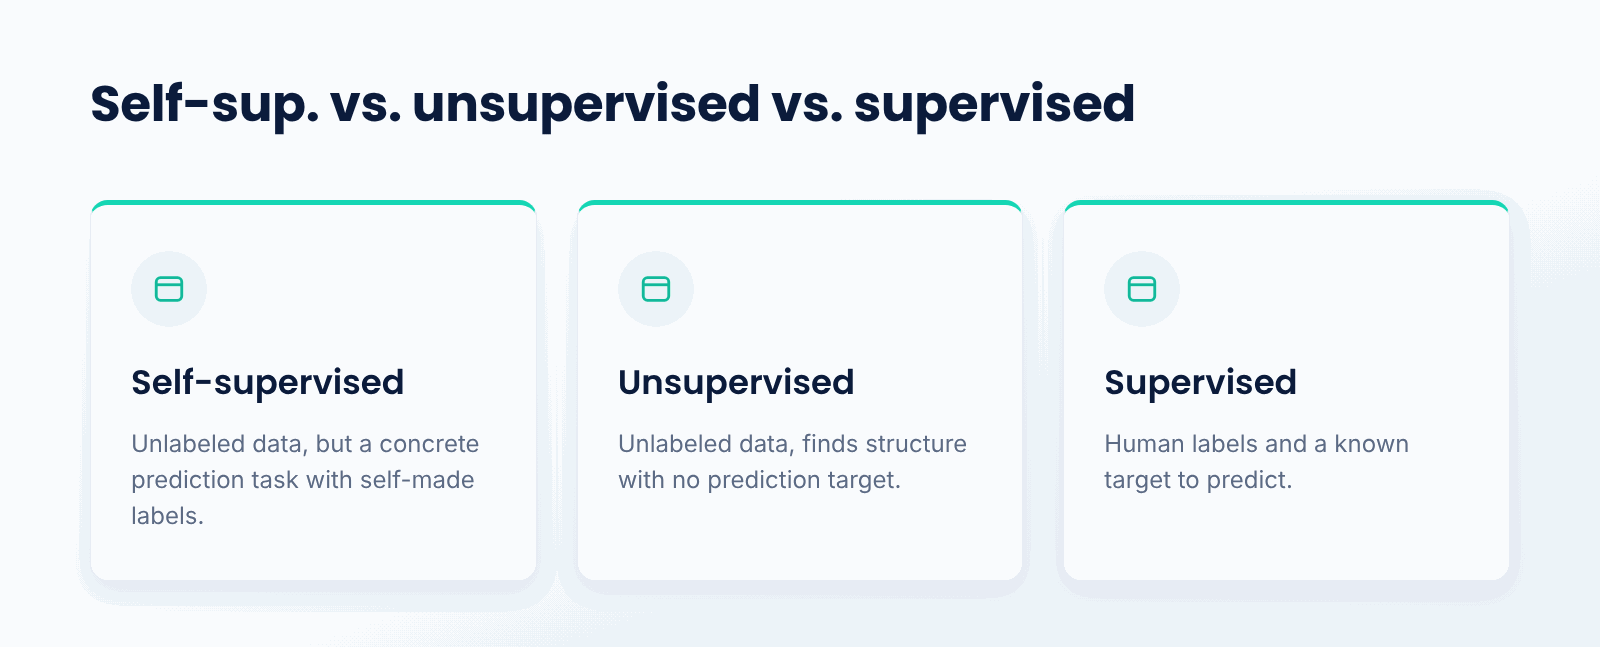
Bij gesuperviseerd leren worden menselijke labels gebruikt om bekende antwoorden te voorspellen. Ongesuperviseerd leren vindt structuren in ongelabelde data zonder een voorspellingsdoel. Zelf-gesuperviseerd leren bevindt zich hier tussenin: het gebruikt ongelabelde data zoals bij ongesuperviseerd leren, maar zet een concrete voorspellingstaak op zoals bij gesuperviseerd leren, waarbij gebruik wordt gemaakt van labels die het zelf uit de data genereert.
Die tussenpositie is de kracht ervan. Het combineert de schaalbaarheid van leren van ongelabelde data met het sterke leersignaal van een voorspellingsdoel. Daarom is zelf-gesuperviseerde pretraining, gevolgd door gesuperviseerde fine-tuning, het dominante recept geworden voor het bouwen van krachtige modellen.
Waarom is zelf-gesuperviseerd leren belangrijk?
- Geen labeling. Het leert van onbewerkte data zonder menselijke annotatie.
- Schaal.Het kan trainen op vrijwel onbeperkte hoeveelheden ongelabelde data.
- Foundation models. Dit is hoe LLM's en andere foundation models worden gepretraind.
- Transfer. De representaties die het leert, zijn goed overdraagbaar naar vele taken.
- Efficiëntie.Het vermindert de afhankelijkheid van schaarse, dure gelabelde data.
Wat zijn de afwegingen?
- Rekenkracht. Pretraining op grote schaal vereist enorme rekenkracht.
- Datakwaliteit.Het model neemt patronen en vooroordelen over van de onbewerkte data.
- Taakontwerp. De pretext-voorspellingstaak moet zorgvuldig worden gekozen om nuttige kenmerken te leren.
- Indirect doel. Het pretraining-doel is een proxy, niet de uiteindelijke taak waar het je om gaat.
Wanneer wordt self-supervised learning gebruikt?
Het is de standaardmethode voor het pretrainen van foundation-modellen, waarbij algemene representaties worden geleerd uit enorme hoeveelheden ongelabelde data voordat ze worden aangepast aan specifieke taken. Wanneer je over een overvloed aan ongelabelde data beschikt en een model wilt dat de structuur ervan diepgaand begrijpt, is self-supervised learning de aangewezen aanpak.
In de praktijk wordt het bijna altijd gecombineerd met een latere supervised of op voorkeuren gebaseerde stap. De self-supervised fase bouwt op goedkope wijze brede capaciteiten op uit ruwe data, en de daaropvolgende fase specialiseert het model. Dit is de manier waarop de meeste state-of-the-art systemen worden gebouwd.
Kernpunten van self-supervised learning
- Het creëert zijn eigen labels uit ongelabelde data.
- Het model voorspelt verborgen delen van de input op basis van de rest.
- Het combineert de schaalbaarheid van unsupervised learning met een doelstelling in supervised-stijl.
- Het is de manier waarop grote taalmodellen worden gepretraind.
- De representaties zijn overdraagbaar naar vele downstream-taken.
- Het wordt meestal gevolgd door supervised fine-tuning.
Conclusie
Self-supervised learning traint een model door het verborgen delen van ongelabelde data te laten voorspellen, waarbij labels uit de data zelf worden gegenereerd. Door de schaal van ongelabelde data te combineren met het sterke signaal van een voorspellingstaak, is dit de manier waarop grote taalmodellen en andere foundation-modellen worden gepretraind om rijke, overdraagbare representaties te leren. De voornaamste kosten zitten in de rekenkracht die nodig is om op grote schaal te pretrainen.
TrueFoundry helpt teams bij het fine-tunen en serveren van modellen die zijn gebouwd op self-supervised pretraining, en vormt de brug van een algemeen gepretraind model naar een ingezet, taakspecifiek model. Het begrijpen van self-supervised learning verklaart hoe de meest capabele modellen van vandaag tot stand komen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is self-supervised learning in simple terms?
It involves training the model by getting it to complete the missing parts of unlabeled data. You cover up some of the data and get the model to guess the covered-up part using the rest, so the data provides its own labels and no human annotation is needed.
How is it different from unsupervised learning?
Unlike unsupervised learning, which detects patterns in the dataset without any targeted outcome, self-supervised learning uses the same type of data but designs a specific prediction task by generating its own labels from the input, giving it a stronger, more directed learning signal.
How are language models trained with it?
The classic task involves predicting the subsequent token based on the previous tokens. Repeated many times over a huge corpus of text, this makes the model understand grammar, facts, and reasoning, which is how large language models become so capable through pretraining.
Does self-supervised learning need any labels?
No labeling by humans involved. The labels are intrinsic to the data because the right answer is simply what is left out. That is why it can learn from nearly unlimited unlabeled data at no extra cost of labeling.
Is self-supervised learning used alone?
Not generally. This approach develops broad capability at a low cost from raw data during the pretraining phase, after which supervised fine-tuning or preference-based training tailors the model to the particular tasks you care about.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


