


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is RLHF en waarom is het belangrijk?

Een taalmodel dat alleen getraind is om het volgende token te voorspellen, leert tekst aan te vullen, maar niet per se om behulpzaam, waarheidsgetrouw of veilig te zijn. Het zal met plezier een prompt voltooien op manieren die iemand onbehulpzaam of ongepast kan vinden. RLHF is de techniek die die kloof overbrugt en een ruw model vormgeeft tot een assistent die zich gedraagt zoals mensen daadwerkelijk willen.
Het kerninzicht is dat het moeilijk is om precies op te schrijven wat een goed antwoord maakt, maar dat het voor mensen makkelijk is om twee antwoorden te vergelijken en te zeggen welke beter is. RLHF zet die menselijke vergelijkingen om in een trainingssignaal, waardoor het model leert om het soort antwoorden te produceren dat mensen verkiezen in een enorm scala aan situaties.
Deze gids legt uit wat RLHF is, hoe de fasen op elkaar aansluiten, hoe het zich verhoudt tot standaard fine-tuning en waarom het belangrijk is voor het bouwen van nuttige modellen.
Wat is RLHF?
RLHF staat voor reinforcement learning from human feedback. Het is een methode om het gedrag van een model af te stemmen op menselijke voorkeuren door menselijke oordelen als basis te gebruiken voor een beloningssignaal, en vervolgens het model te optimaliseren om die beloning te maximaliseren. Het resultaat is een model waarvan de output door mensen doorgaans als behulpzamer en passender wordt beoordeeld.
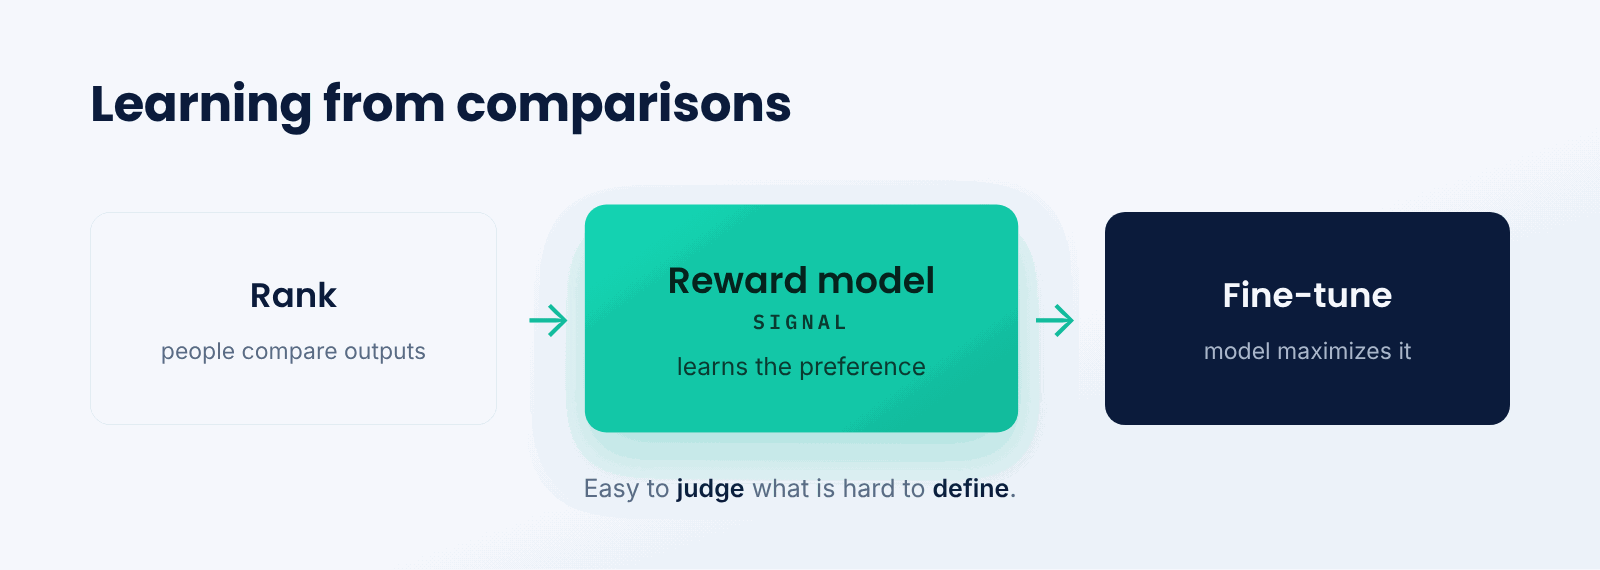
Zie het als coaching. Een coach specificeert zelden de perfecte techniek tot in detail, maar kan een poging bekijken en zeggen of deze beter of slechter was dan een andere. Na vele rondes van die feedback convergeert de atleet naar een goede vorm. RLHF coacht een model op dezelfde manier, waarbij menselijke voorkeursoordelen worden gebruikt in plaats van expliciete regels.
Het belangrijkste idee is leren van vergelijkingen in plaats van vaste doelen. Omdat mensen betrouwbaar kunnen zeggen welk van twee antwoorden beter is, zelfs als ze het ideale antwoord niet kunnen definiëren, worden voorkeursgegevens een praktische manier om een model naar gewenst gedrag te sturen.
Hoe werkt RLHF?
RLHF verloopt doorgaans in drie fasen die voortbouwen op een voorgetraind model.
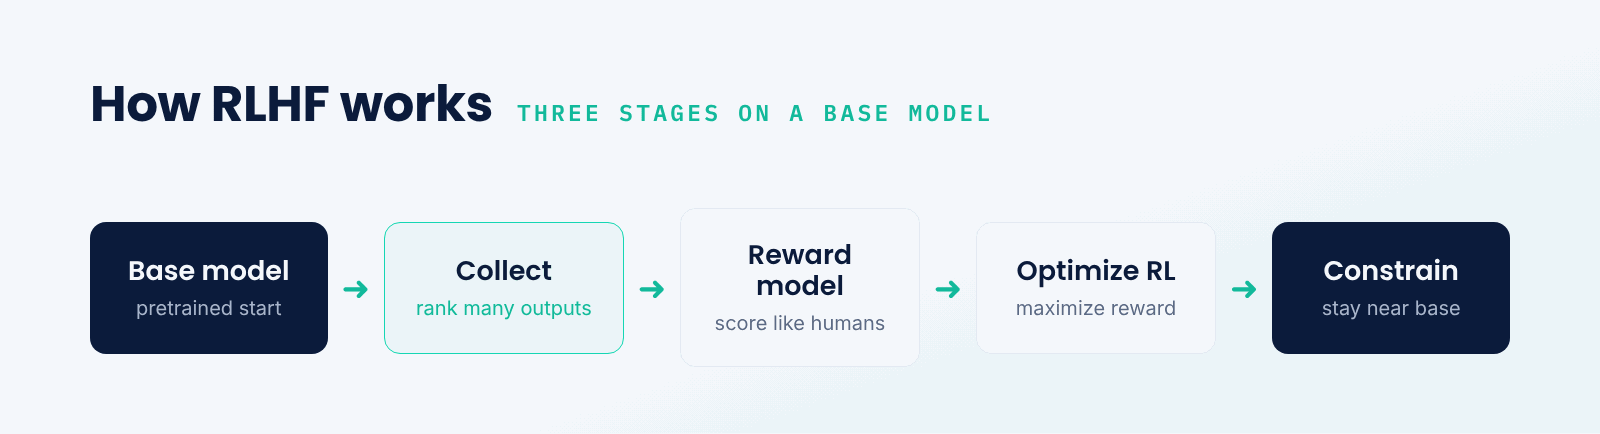
- Begin bij een basismodel. Start met een voorgetraind, vaak op instructies afgestemd, taalmodel.
- Verzamel voorkeuren.Laat mensen modeloutputs voor vele prompts rangschikken of vergelijken.
- Train een beloningsmodel. Pas een model aan dat antwoorden scoort om overeen te komen met die menselijke rangschikkingen.
- Optimaliseer met RL. Fine-tune het taalmodel om de score van het beloningsmodel te maximaliseren.
- Houd het gegrond. Beperk updates zodat het model dicht bij zijn oorspronkelijke gedrag blijft.
De fase van reinforcement learning laat het model antwoorden verkennen en beloond worden voor antwoorden die het beloningsmodel hoog scoort, terwijl een beperking voorkomt dat het te ver afdrijft van het basismodel. Deze balans duwt het model richting gewenst gedrag zonder de taalvaardigheid te verliezen die het tijdens de voortraining heeft geleerd.
RLHF versus supervised fine-tuning
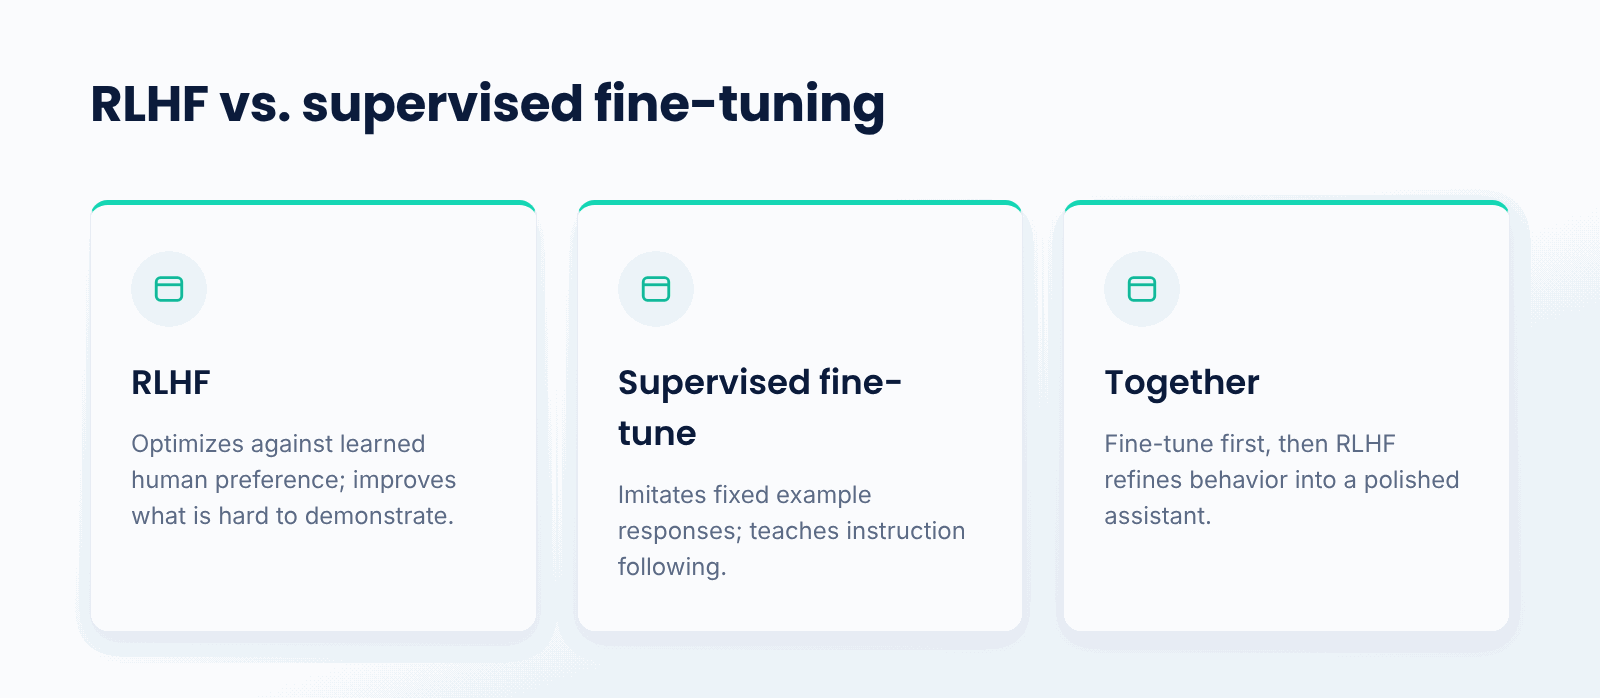
Supervised fine-tuning traint een model om een reeks voorbeeldantwoorden te imiteren, waarbij het leert om de gedemonstreerde antwoorden te reproduceren. RLHF gaat verder: in plaats van vaste voorbeelden te imiteren, optimaliseert het op basis van een aangeleerd model van menselijke voorkeuren, waardoor het gedrag kan verbeteren dat moeilijk te demonstreren, maar makkelijk te beoordelen is.
In de praktijk worden beide samen gebruikt. Supervised fine-tuning leert het model eerst om instructies op te volgen met behulp van demonstraties, en RLHF verfijnt vervolgens het gedrag aan de hand van feedback op voorkeuren. Deze combinatie verandert een capabel basismodel in een gepolijste, goed afgestemde assistent.
Waarom is RLHF belangrijk?
- Afstemming.Het stuurt modellen aan op behulpzaam, eerlijk en veilig gedrag.
- Bruikbaarheid.Het verandert ruwe tekstvoorspellers in bruikbare assistenten.
- Moeilijk te specificeren doelen. Het legt voorkeuren vast die lastig als regels te formuleren zijn.
- Kwaliteit.Het verbetert merkbaar hoe nuttig antwoorden voor mensen aanvoelen.
- Veiligheid. Het vermindert schadelijke of ongepaste output.
Wat zijn de afwegingen?
- Menselijke kosten. Het verzamelen van kwalitatieve voorkeursdata is arbeidsintensief.
- Beloningshacking.Het model kan gebreken in het beloningsmodel uitbuiten.
- Vooringenomenheid. Het resulterende gedrag weerspiegelt de voorkeuren van de mensen die het hebben gelabeld.
- Complexiteit.Het meerfasige RL-proces is lastiger uit te voeren dan eenvoudige fine-tuning.
Wanneer wordt RLHF gebruikt?
RLHF wordt gebruikt om chat- en assistentmodellen voor algemeen gebruik af te stemmen, waarbij de kwaliteit van het gedrag, behulpzaamheid en veiligheid van belang zijn voor een breed scala aan invoer. Het is de stap die een model prettig en betrouwbaar maakt in de omgang, waardoor het de standaard is bij het bouwen van conversationele modellen voor consumenten.
Voor specifieke, goed gedefinieerde taken waarbij correcte output direct kan worden gedemonstreerd, kan supervised fine-tuning alleen volstaan, en eenvoudigere methoden voor voorkeursoptimalisatie worden steeds vaker gebruikt als lichtere alternatieven. Maar waar subjectieve kwaliteit en brede afstemming van belang zijn, blijven RLHF of de opvolgers daarvan essentieel.
Belangrijke punten over RLHF
- RLHF stemt een model af op menselijke voorkeuren.
- Mensen rangschikken output; een beloningsmodel leert deze te scoren.
- Het model wordt met RL gefinetuned om die beloning te maximaliseren.
- Het bouwt voort op, en vormt een aanvulling op, supervised fine-tuning.
- Het verbetert de behulpzaamheid en veiligheid, maar verhoogt de kosten en complexiteit.
- Het kan worden ondermijnd door reward hacking en bias bij de beoordelaars.
Conclusie
RLHF stemt een taalmodel af op menselijke voorkeuren door een beloningsmodel te trainen op basis van menselijke rangschikkingen en het model vervolgens te finetunen om die beloning te maximaliseren. Voortbouwend op supervised fine-tuning verandert het een capabel maar ruw basismodel in een behulpzame, welgemanierde assistent. Hoewel het extra data- en proceskosten met zich meebrengt en risico's zoals reward hacking introduceert, blijft het een van de belangrijkste technieken om modellen daadwerkelijk nuttig te maken.
TrueFoundry helpt teams bij het finetunen en inzetten van afgestemde modellen op hun eigen infrastructuur, en ondersteunt de trainingsworkflows die basismodellen omvormen tot productie-assistenten. Naarmate afstemmingsmethoden evolueren, is inzicht in RLHF essentieel om te begrijpen hoe moderne modellen zich gedragen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is RLHF in simple terms?
It is a method for training a model such that it produces the kinds of outputs that humans prefer. Humans rate which responses they prefer, the reward model learns from those ratings, and the language model is then refined to produce responses that score well.
Why is RLHF needed if a model is already trained?
A model that learns just how to predict text extends prompts, but may do so without really helping at all, being truthful, or even safe. RLHF directs that skill toward useful behavior desired by real people, turning a text predictor into a usable, well-aligned assistant.
What is the reward model in RLHF?
This is a model trained to rate answers the way humans do, learned from people's rankings of outputs. It substitutes for human judgment during reinforcement learning, providing an optimization goal the language model can achieve at scale.
How is RLHF different from fine-tuning?
Fine-tuning under supervision trains the model to mimic example solutions. RLHF maximizes for a learned model of human preferences, which allows it to develop behavior that is difficult to demonstrate but simple to evaluate. They are typically combined in use.
What are the risks of RLHF?
The first type is reward hacking, which means the model takes advantage of flaws in the reward model instead of genuinely improving. Another is bias, as the learned behavior reflects the preferences of the feedback givers. It is also costly and complex to run.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


