


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is een reward model en waarom is het belangrijk?

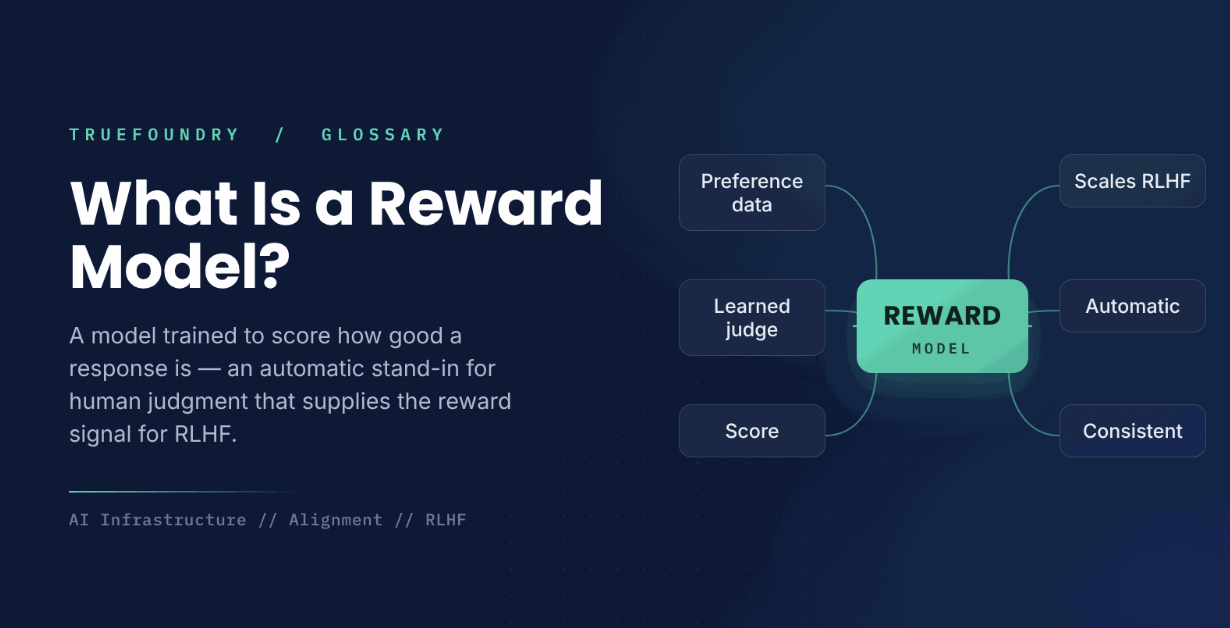
Om een taalmodel af te stemmen op menselijke voorkeuren is een manier nodig om goede antwoorden van slechte te onderscheiden, op een schaal die geen enkel team van menselijke beoordelaars kan bijhouden. Je kunt mensen niet elke kandidaat-reactie laten beoordelen tijdens de training; dat zijn er simpelweg te veel. Een reward model lost dit op door te leren antwoorden te beoordelen zoals mensen dat zouden doen, zodat het oordeel automatisch en eindeloos kan worden toegepast.
Een reward model is getraind op gegevens over menselijke voorkeuren en geeft bij een antwoord een score die aangeeft hoe goed dit is. Die score wordt het signaal dat reinforcement learning aanstuurt, wat de manier is waarop reinforcement learning from human feedback (RLHF) schaalt. Deze gids legt uit wat een reward model is, hoe het wordt gebouwd en waarom het belangrijk is.
We behandelen de definitie, het trainingsproces, hoe het in RLHF past en wanneer het van belang is.
Wat is een reward model?
Een reward model is een machine learning-model dat een antwoord, of een combinatie van prompt en antwoord, neemt en een numerieke score geeft die aangeeft hoe goed dat antwoord is volgens menselijke voorkeuren. Het is getraind om menselijk oordeel te benaderen, zodat je in plaats van een persoon te vragen elk antwoord te beoordelen, het reward model kunt vragen, direct en op elke schaal.
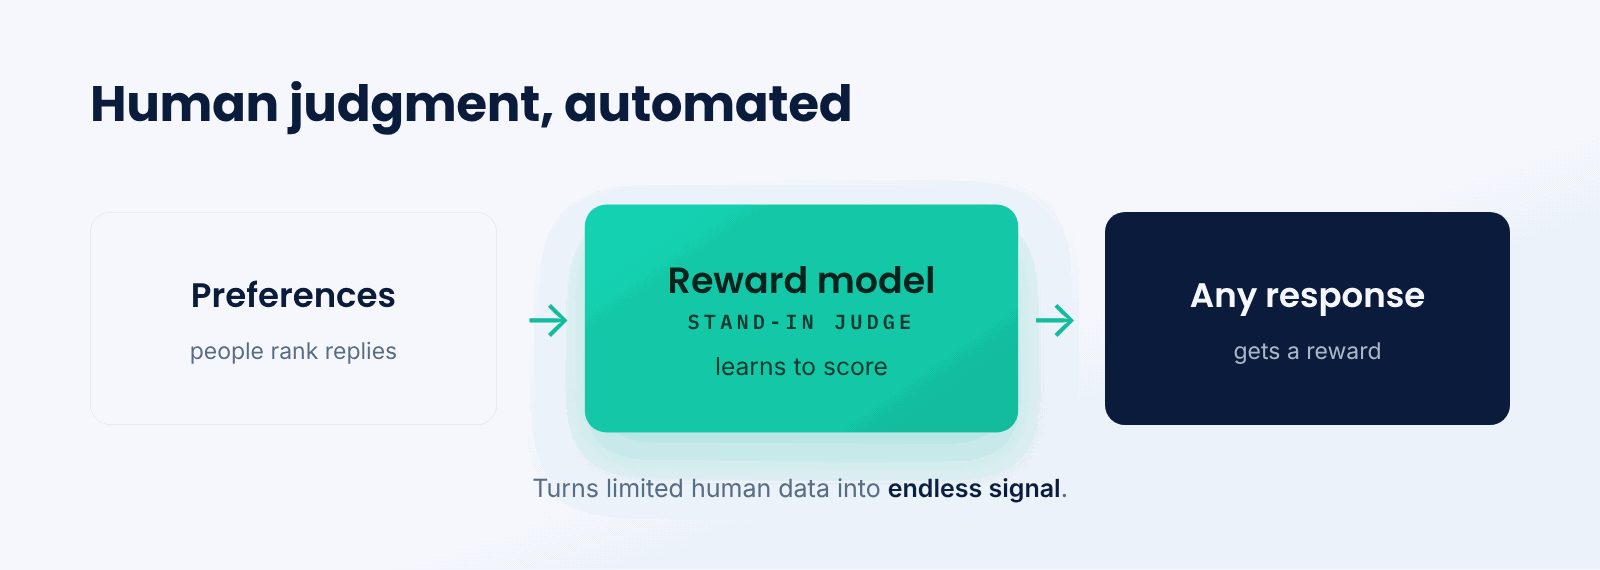
Zie het als een getrainde jurylid bij een wedstrijd die heeft geïnternaliseerd wat de menselijke juryleden waarderen. Eenmaal getraind kan dit jurylid een eindeloze stroom inzendingen consistent en snel beoordelen, als vervanger voor de groep mensen die het heeft geleerd wat kwaliteit is. Een reward model is die geautomatiseerde jury voor AI-antwoorden.
Het kernidee is om menselijke voorkeuren om te zetten in een herbruikbare score. Door te leren van voorbeelden van wat mensen verkiezen, legt het reward model die voorkeur vast in een vorm die je automatisch kunt toepassen tijdens de training.
Hoe wordt een reward model getraind en gebruikt?
Een reward model leert van menselijke vergelijkingen en beoordeelt vervolgens antwoorden tijdens de training.
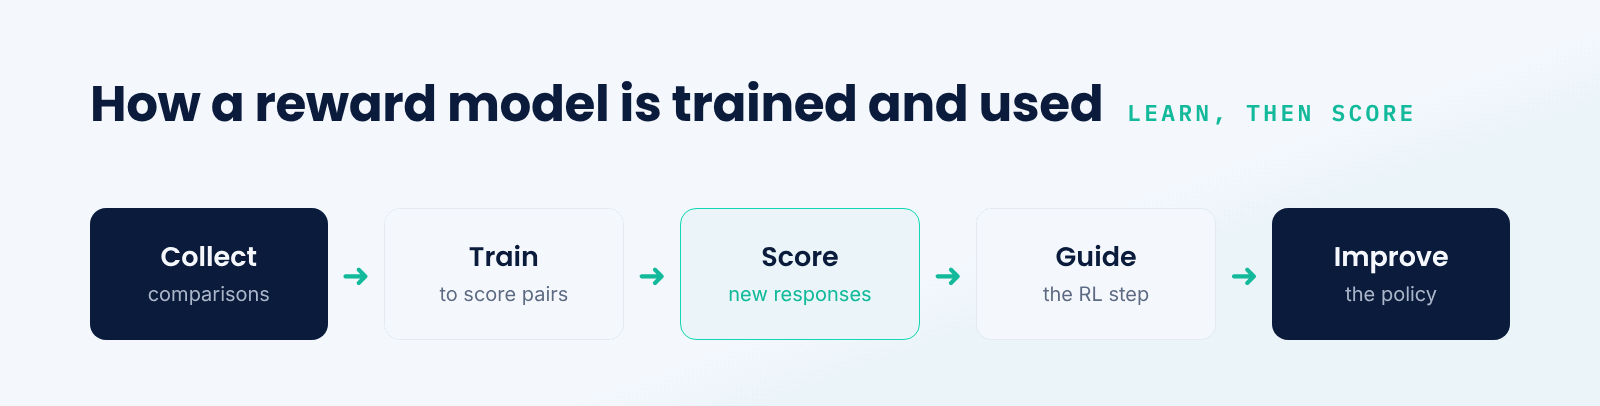
- Verzamel vergelijkingen. Laat mensen kandidaat-antwoorden rangschikken of er een keuze uit maken.
- Train het model. Leer het om hogere scores te geven aan de geprefereerde antwoorden.
- Beoordeel antwoorden. Gebruik het om nieuwe antwoorden automatisch te beoordelen.
- Stuur het leerproces aan. Voer de scores in bij de stap van reinforcement learning.
- Verbeter het model. Het beleid leert om antwoorden te produceren die een hogere score krijgen.
Het beloningsmodel wordt meestal getraind op paren waarbij een mens de betere van twee antwoorden heeft gekozen, waarbij het leert om aan het geprefereerde antwoord een hogere score toe te kennen. Tijdens RLHF genereert het taalmodel dat wordt getraind antwoorden, beoordeelt het beloningsmodel deze, en stuurt reinforcement learning het taalmodel aan richting antwoorden die het beloningsmodel hoog waardeert.
Het beloningsmodel in RLHF
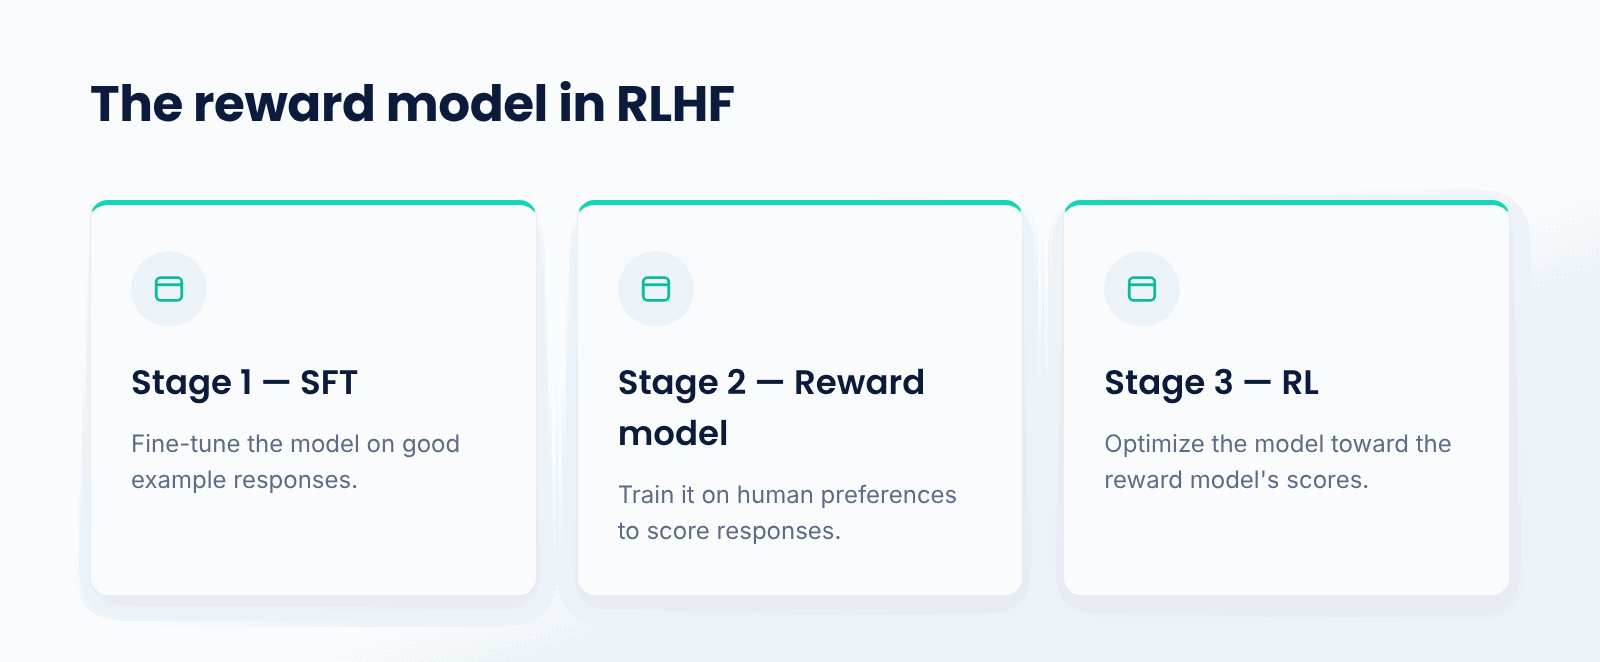
RLHF bestaat uit drie fasen, en het beloningsmodel is de tweede. Eerst wordt een model gefinetuned op goede voorbeelden. Ten tweede wordt een beloningsmodel getraind op basis van menselijke voorkeursdata om antwoorden te beoordelen. Ten derde gebruikt reinforcement learning de scores van het beloningsmodel om het taalmodel te optimaliseren richting gewenst gedrag.
Het beloningsmodel is de spil: het zet een beperkte set menselijke oordelen om in een onbeperkte bron van trainingssignalen. Dit is ook de reden waarom de kwaliteit ervan zo belangrijk is, omdat het taalmodel zal optimaliseren naar alles wat het beloningsmodel beloont, inclusief de gebreken. Een bevooroordeeld of manipuleerbaar beloningsmodel leidt tot een verkeerd afgesteld eindmodel.
Waarom is een beloningsmodel belangrijk?
- Schaal.Het past menselijk oordeel toe op een schaal die ver uitgaat boven wat mensen zelf zouden kunnen beoordelen.
- Automatisering.Het beoordeelt antwoorden direct tijdens de training.
- Afstemming. Het is de manier waarop RLHF een model stuurt richting voorkeuren.
- Consistentie.Het beoordeelt op basis van één enkele aangeleerde standaard.
- Hefboomwerking. Het zet beperkte menselijke data om in een eindeloos signaal.
Wat zijn de uitdagingen?
- Kwaliteitsafhankelijkheid. Het eindmodel neemt de gebreken van het beloningsmodel over.
- Beloningshacking. Modellen kunnen eigenaardigheden uitbuiten om hoge scores te behalen.
- Datakosten. Het vereist kwalitatieve menselijke voorkeursvergelijkingen.
- Drift.Voorkeuren en contexten veranderen in de loop van de tijd.
Wanneer is een reward model van belang?
Een reward model is van belang zodra je reinforcement learning from human feedback (RLHF) gebruikt om een model af te stemmen, omdat dit de component is die het beloningssignaal levert. Het is essentieel voor het op grote schaal bouwen van behulpzame, afgestemde assistenten, waarbij menselijke voorkeuren de training moeten sturen, maar niet voor elk antwoord kunnen worden verzameld.
Als je een model afstemt met een methode die het reward model overslaat, zoals direct preference optimization, train je er wellicht helemaal geen. Maar waar RLHF ook wordt gebruikt, het reward model vormt het hart van het proces en de kwaliteit ervan is cruciaal voor het resultaat.
Kernpunten over reward models
- Een reward model beoordeelt hoe goed een antwoord is.
- Het leert menselijke voorkeuren op basis van vergelijkingsdata.
- Het fungeert automatisch en op grote schaal als vervanger voor menselijk oordeel.
- Het levert het beloningssignaal dat RLHF aanstuurt.
- Het uiteindelijke model optimaliseert op basis van wat het beloont.
- De kwaliteit ervan is cruciaal voor de afstemming.
Conclusie
Een reward model is de geautomatiseerde rechter die reinforcement learning from human feedback mogelijk maakt. Het leert van menselijke voorkeursdata om antwoorden te scoren en levert het beloningssignaal dat een model naar gewenst gedrag stuurt. Het zet een beperkte set menselijke oordelen om in een eindeloze bron van trainingssignalen; daarom is het essentieel voor het op grote schaal afstemmen van modellen en is de kwaliteit ervan zo belangrijk.
TrueFoundry helpt teams bij het trainen en afstemmen van modellen op hun eigen infrastructuur, inclusief de reward modeling- en RLHF-pipelines die modellen sturen naar menselijke voorkeuren. Wanneer afstemming op grote schaal het doel is, is het reward model de component die het mogelijk maakt.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is a reward model in simple terms?
It is a model that scores how good a response is, trained to judge the way people would. Instead of having a human assess each response during training, you have the reward model do it, which gives a score instantly and at any scale.
How is a reward model trained?
On human preference data, most often pairs of responses in which a human selects the better one. The reward model learns to assign a higher score to the selected response, thus approximating human judgment and becoming able to evaluate new responses on its own.
How does a reward model fit into RLHF?
It forms the second of RLHF's three stages. The model undergoes an initial fine-tune, then the reward model is trained on human preferences to score responses, and reinforcement learning uses those scores to push the language model toward responses the reward model rates highly.
What is reward hacking?
It is when a model learns to exploit quirks or weaknesses in the reward model to get high scores without actually being better. Since the model optimizes toward whatever the reward model rewards, a flawed reward model can be gamed, which is why its quality matters so much.
Do all alignment methods use a reward model?
No. RLHF relies on one, but some approaches, such as direct preference optimization, align a model directly from preference data without training a separate reward model. Whether you need one depends on the alignment method you choose.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


