


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is QLoRA en waarom is het belangrijk?

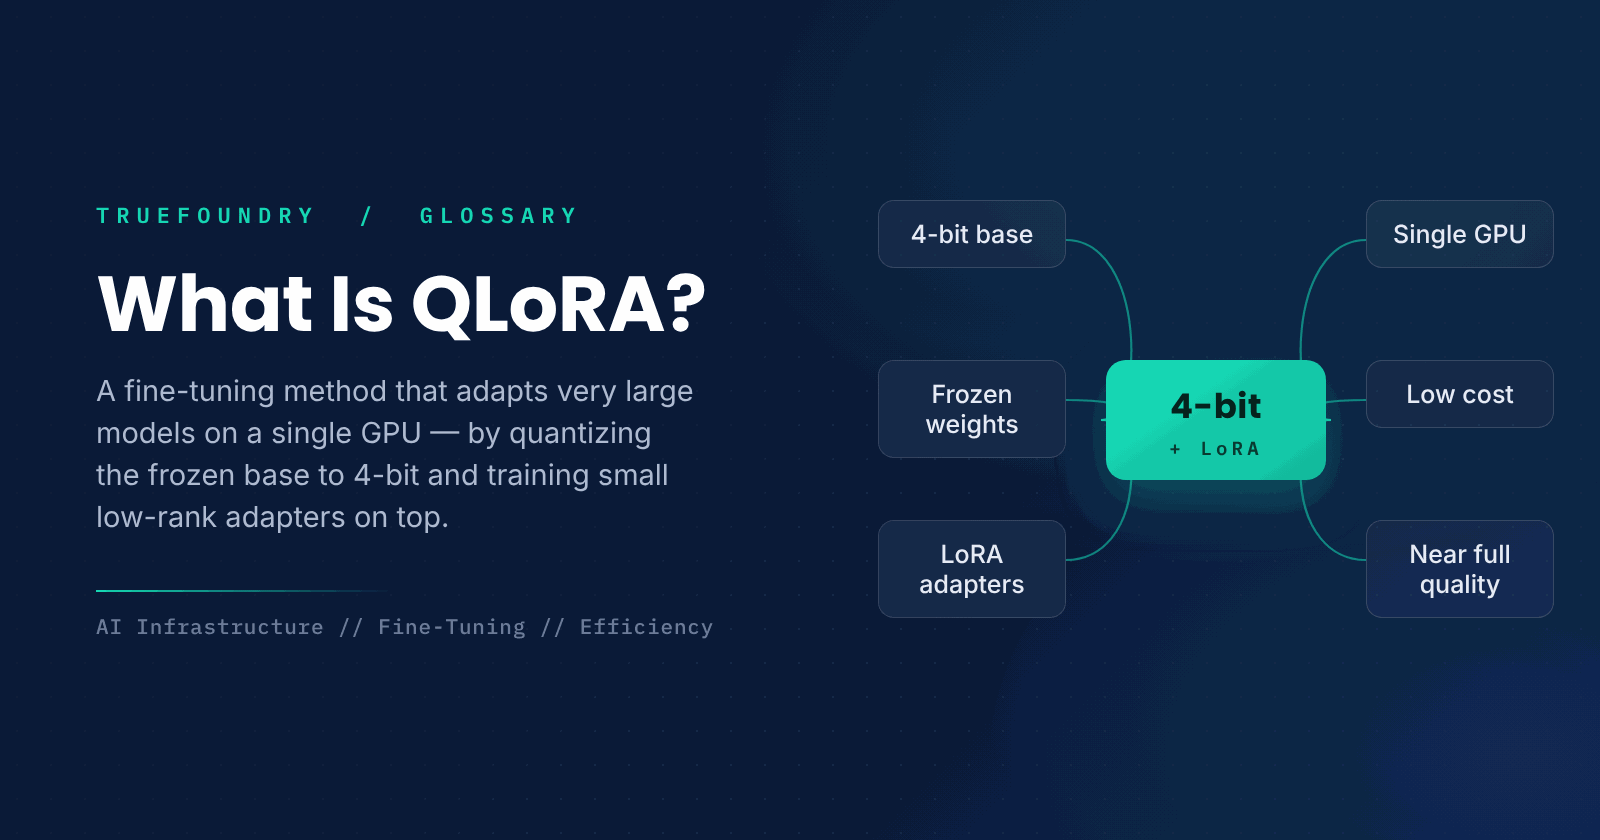
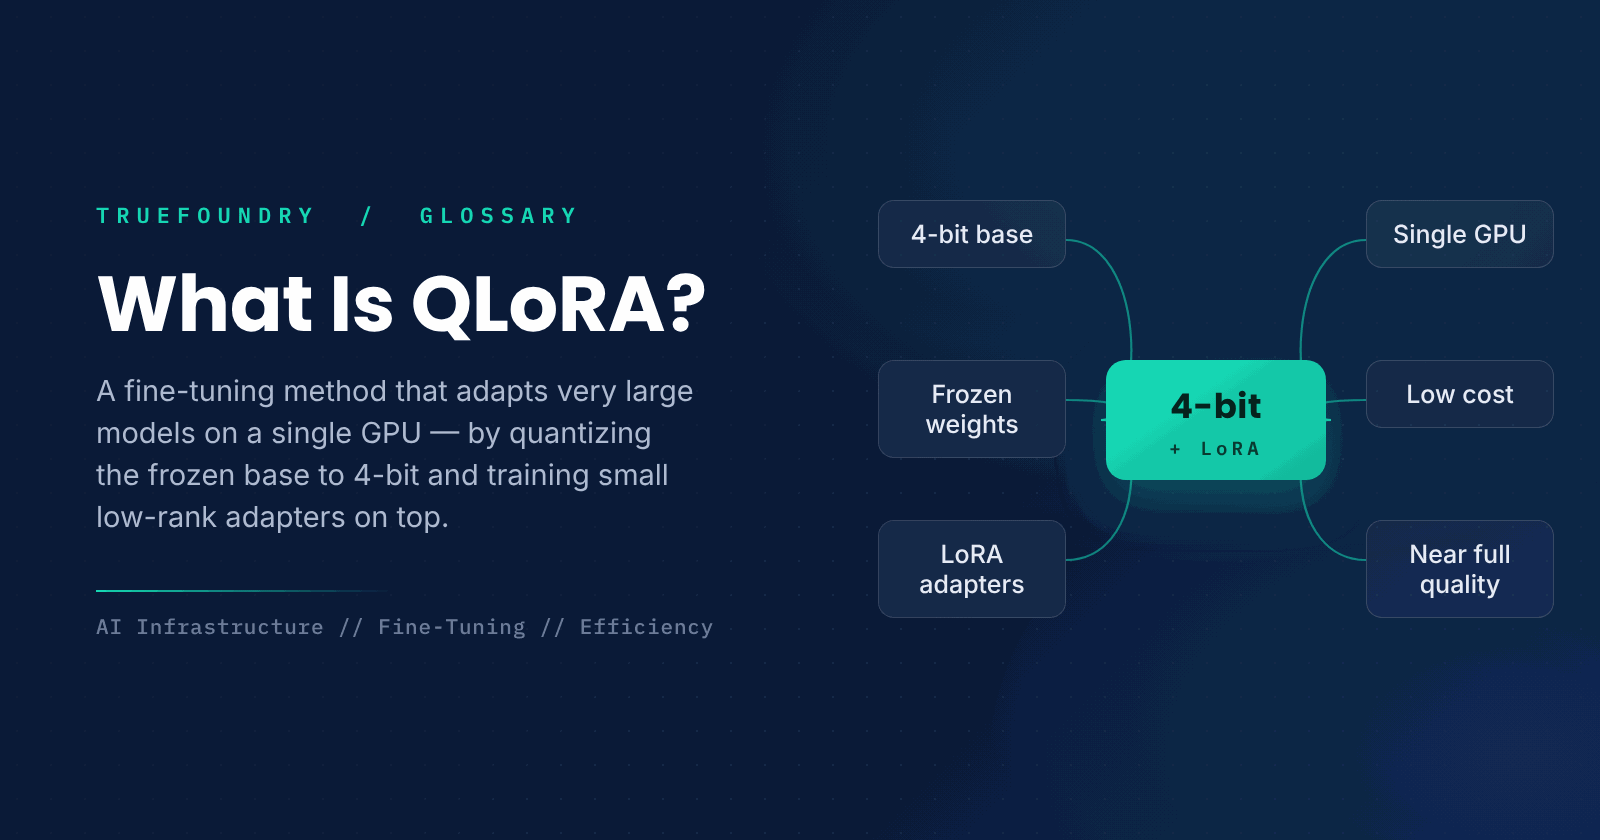
Voor het fine-tunen van een groot taalmodel was voorheen een cluster van dure GPU's nodig, omdat bij de training elk van de miljarden gewichten van het model wordt aangepast en gradiënten en optimizer-statussen voor allemaal moeten worden opgeslagen. QLoRA heeft daar verandering in gebracht door het mogelijk te maken om zeer grote modellen op één GPU te fine-tunen, waardoor maatwerk voor veel meer teams binnen handbereik komt.
Dit wordt bereikt door twee ideeën te combineren. Ten eerste wordt het basismodel gecomprimeerd naar 4-bit precisie, zodat het in een fractie van het geheugen past. Ten tweede wordt dat gecomprimeerde model bevroren en wordt er slechts een kleine set toegevoegde gewichten getraind. Het resultaat is een enorme afname van het geheugen dat nodig is voor fine-tuning, met een kwaliteit die dicht in de buurt komt van volledige fine-tuning.
Deze gids legt uit wat QLoRA is, hoe het werkt, hoe het zich verhoudt tot LoRA en kwantisatie, en wanneer je het moet gebruiken.
Wat is QLoRA?
QLoRA, kort voor Quantized Low-Rank Adaptation, is een parameter-efficiënte fine-tuningmethode die een klein aantal adaptergewichten traint bovenop een groot basismodel dat is gekwantiseerd naar 4-bit precisie. Het basismodel blijft bevroren en gecomprimeerd, waardoor bijna al het geheugen dat normaal gesproken aan training wordt besteed, wordt geëlimineerd, terwijl de kleine adapters de taakspecifieke wijzigingen opvangen.
Zie het als het annoteren van een naslagwerk in plaats van het te herschrijven. Het dikke boek blijft zoals het is, compact opgeslagen in de kast, en je voegt een dunne set plakbriefjes toe die aanpassen hoe je het gebruikt. QLoRA houdt het enorme model vast en gecomprimeerd, en de kleine adapters zijn de notities die het aanpassen aan jouw taak.
Het kernidee is het combineren van compressie met parameter-efficiënte training. Kwantisatie verkleint de geheugenvoetafdruk van het bevroren basismodel, en low-rank adapters betekenen dat je slechts een fractie van de parameters traint, waardoor de twee samen fine-tuning van enorme modellen haalbaar maken op bescheiden hardware.
Hoe werkt QLoRA?
QLoRA kwantiseert het basismodel, bevriest het en traint lichtgewicht adapters daarop.
- Kwantiseer de basis. Sla de gewichten van het voorgetrainde model op in 4-bit precisie om geheugen te besparen.
- Bevries het. Houd die basisgewichten vast; ze worden niet bijgewerkt tijdens de training.
- Voeg adapters toe. Voeg kleine low-rank gewichtsmatrices (LoRA) in het model in.
- Train alleen de adapters. Update alleen de adapters op basis van jouw taakgegevens.
- Implementeer. Gebruik de gekwantiseerde basis samen met de getrainde adapters tijdens de inferentie.
Omdat alleen de kleine adapters worden getraind, neemt het geheugen voor gradiënten en de optimizer-status drastisch af, en omdat de bevroren basis in 4-bit is, krimpt de voetafdruk ook. QLoRA voegt zorgvuldige technieken toe om 4-bit training stabiel te houden, waardoor de kwaliteit dicht bij die van full-precision fine-tuning blijft.
QLoRA vs. LoRA vs. volledige fine-tuning
Bij volledige fine-tuning wordt elk gewicht in het model op volledige precisie bijgewerkt, wat maximale flexibiliteit biedt maar enorm veel geheugen vereist. LoRA bevriest het basismodel en traint alleen kleine adapters, waardoor het aantal trainbare parameters sterk wordt verminderd terwijl de basis op normale precisie blijft. QLoRA gaat nog een stap verder door ook die bevroren basis te kwantiseren naar 4-bit, wat het geheugengebruik nog verder verlaagt.
Het praktische verschil zit in de hardware die je nodig hebt. Volledige fine-tuning van een groot model kan veel GPU's vereisen; LoRA vermindert dat aanzienlijk; QLoRA kan het terugbrengen tot een enkele GPU. De afweging is klein: de gekwantiseerde basis van QLoRA introduceert een kleine benadering, maar in de praktijk blijft de kwaliteit voor de meeste taken dicht bij die van volledige fine-tuning.
Waarom is QLoRA belangrijk?
- Toegankelijkheid. Het maakt het fine-tunen van grote modellen mogelijk op een enkele GPU.
- Lagere kosten. Het verlaagt de hardware- en geheugenvereisten voor het aanpassen van modellen aanzienlijk.
- Kwaliteit. Het behoudt het grootste deel van de kwaliteit van volledige fine-tuning.
- Draagbaarheid. Getrainde adapters zijn klein en eenvoudig op te slaan en uit te wisselen.
- Democratisering. Het maakt het aanpassen van modellen bereikbaar voor meer teams.
Wat zijn de afwegingen?
- Kwantisatiefout. 4-bit opslag voegt een kleine mate van benadering toe.
- Inferentie-instellingen. Voor het serveren moeten de gekwantiseerde basis en de adapters aan elkaar worden gekoppeld.
- Niet altijd optimaal. Voor de allerhoogste kwaliteit kan volledige fine-tuning nog steeds net iets beter presteren.
- Taakbeperkingen. Zeer grote gedragsveranderingen kunnen het bereik van kleine adapters overschrijden.
Wanneer moet je QLoRA gebruiken?
Gebruik QLoRA wanneer je een groot model wilt fine-tunen, maar beperkt bent in GPU-geheugen of budget; dit geldt voor de meeste teams buiten de grootste laboratoria. Het is ideaal voor het aanpassen van een groot open-source model aan een specifiek domein of taak op een enkele GPU, waar volledige fine-tuning onpraktisch zou zijn.
Als je over ruime hardware beschikt en de allerbeste kwaliteit nodig hebt, blijft volledige fine-tuning een optie. En als een kleiner model al volstaat, heb je QLoRA wellicht helemaal niet nodig. Maar voor efficiënte, betaalbare aanpassing van grote modellen is QLoRA vaak de methode bij uitstek.
Kernpunten over QLoRA
- QLoRA combineert 4-bit kwantisatie met LoRA-adapters.
- Het basismodel is bevroren en gecomprimeerd; alleen adapters worden getraind.
- Het maakt het fine-tunen van grote modellen mogelijk op een enkele GPU.
- De kwaliteit blijft dicht in de buurt van volledige fine-tuning.
- Getrainde adapters zijn klein en draagbaar.
- Het is ideaal wanneer GPU-geheugen of budget beperkt is.
Conclusie
QLoRA maakt het fine-tunen van grote taalmodellen veel toegankelijker door 4-bit kwantisatie van een bevroren basismodel te combineren met kleine, trainbare LoRA-adapters. Dit verlaagt het benodigde geheugen voor fine-tuning aanzienlijk, vaak tot slechts één GPU, terwijl de kwaliteit dicht bij volledige fine-tuning blijft. Voor teams die grote modellen willen aanpassen zonder een groot hardwarebudget, is QLoRA een van de belangrijkste beschikbare technieken.
TrueFoundry helpt teams om modellen efficiënt te fine-tunen en te serveren op hun eigen infrastructuur, inclusief parameter-efficiënte methoden zoals QLoRA die de GPU-kosten laag houden. Wanneer het betaalbaar aanpassen van grote modellen belangrijk is, is QLoRA een essentieel hulpmiddel om dat te bereiken.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is QLoRA in simple terms?
It is an approach for refining a large model with far less GPU memory required. The method stores the original model in a compressed 4-bit format and keeps it frozen, training only a few extra weights. That lets you customize a big model on a single GPU.
How is QLoRA different from LoRA?
While LoRA freezes the base model and trains small adapters, it keeps the base at full precision. QLoRA follows the same procedure for training small adapters, but the base is also compressed into 4-bit to further reduce memory usage. That extra compression is what makes single-GPU fine-tuning of large models possible.
Does QLoRA reduce model quality?
Only a little. There is some degree of approximation introduced by the 4-bit quantized base. However, QLoRA uses methods that keep training stable, and in practice the fine-tuned quality stays quite close to full fine-tuning for most tasks.
What hardware does QLoRA need?
Far less than full fine-tuning. By quantizing the base model and training only the adapters, fine-tuning a large model can be done on just one GPU, where full fine-tuning might otherwise require many.
When should I use QLoRA instead of full fine-tuning?
Whenever GPU memory or budget is constrained, which is usually the case. QLoRA provides the vast majority of the quality of full fine-tuning while using much less memory. Full fine-tuning is justified only when there are enough resources for the absolute best quality.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


