


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Prompt Caching en hoe werkt het?

Veel LLM-applicaties sturen steeds opnieuw hetzelfde grote tekstblok: een lange systeemprompt, een set instructies of een document waar de gebruiker herhaaldelijk vragen over stelt. Elke keer dat die tekst naar het model gaat, verwerkt het model deze vanaf het begin, wat tijd en geld kost. Prompt caching elimineert deze verspilling door de verwerkte vorm van het herhaalde deel op te slaan en te hergebruiken.
Het resultaat is snellere, goedkopere antwoorden voor elke werklast met een stabiele, herhaalde context. In plaats van te betalen voor het opnieuw lezen van hetzelfde voorvoegsel bij elk verzoek, betaalt de applicatie één keer en hergebruikt het daarna, wat de reden is dat prompt caching een standaardoptimalisatie is geworden voor LLM-systemen in productie.
Deze gids legt uit wat prompt caching is, hoe het werkt, wanneer het nuttig is en waar je op moet letten.
Wat is prompt caching?
Prompt caching is een optimalisatie die de interne verwerking van een prompt-voorvoegsel door het model opslaat, zodat deze kan worden hergebruikt bij latere verzoeken die hetzelfde voorvoegsel delen. Wanneer er een nieuw verzoek binnenkomt waarvan het begin overeenkomt met een gecachet voorvoegsel, slaat het model het opnieuw verwerken van dat deel over en begint het met genereren vanaf het punt waar de nieuwe, unieke inhoud begint.
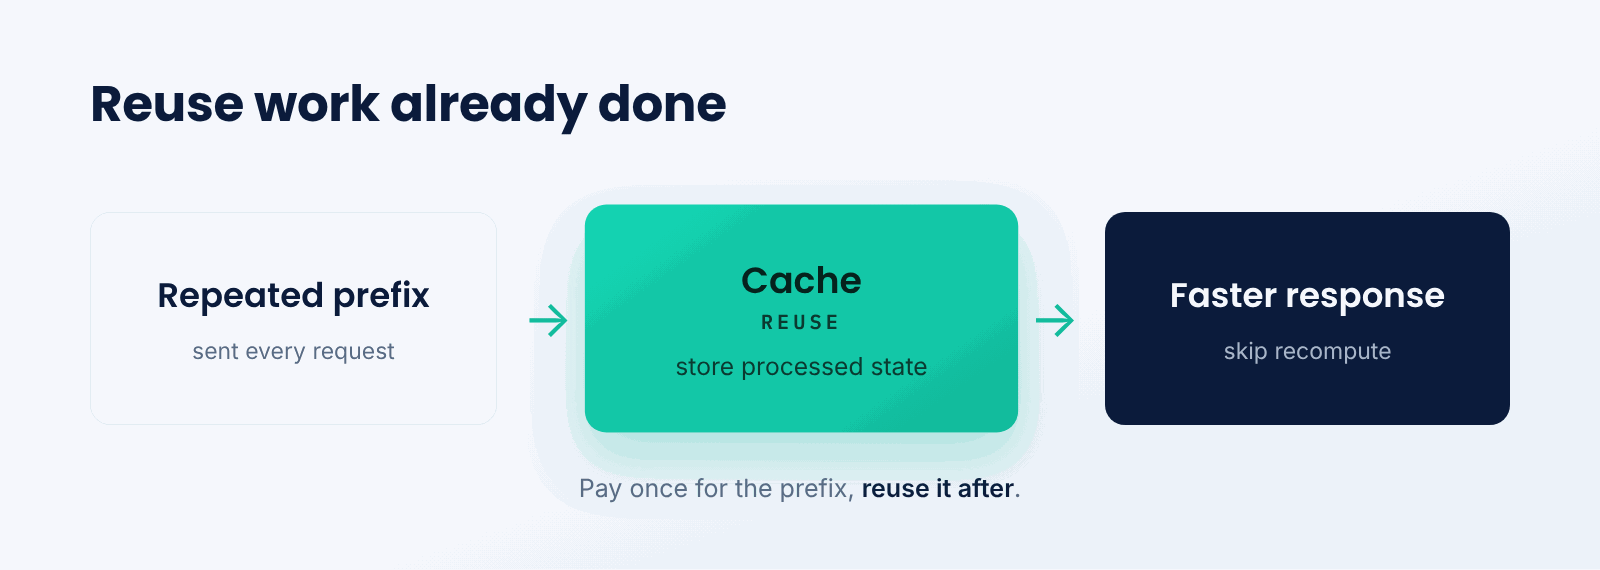
Zie het als een docent die elke dag dezelfde inleiding geeft. In plaats van deze telkens vanaf nul voor te bereiden, hergebruikt hij dezelfde dia's en gaat hij direct door naar wat nieuw is. Met prompt caching kan het model het werk dat het al aan het gedeelde begin heeft verricht hergebruiken en alleen inspanning leveren voor wat er is veranderd.
Het kernidee is het hergebruiken van berekeningen. Het gecachete item is niet alleen de tekst, maar de verwerkte representatie ervan, dus de besparing zit in het vermeden werk, niet alleen in de opslag.
Hoe werkt prompt caching?
Het model verwerkt een voorvoegsel één keer, slaat het resultaat op en hergebruikt het wanneer latere prompts op dezelfde manier beginnen.
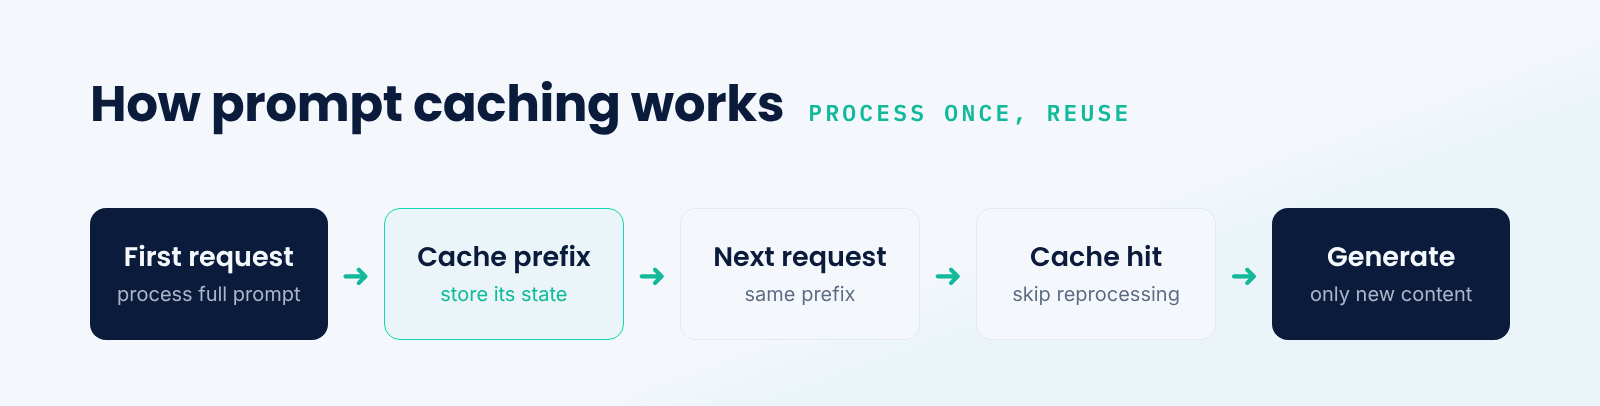
- Eerste verzoek. Het model verwerkt de volledige prompt, inclusief het lange gedeelde voorvoegsel.
- Cache het voorvoegsel. De verwerkte status voor dat voorvoegsel wordt opgeslagen, gekoppeld aan de exacte inhoud ervan.
- Volgend verzoek. Er komt een nieuwe prompt binnen die begint met hetzelfde voorvoegsel.
- Cache-hit. Het model hergebruikt de opgeslagen status in plaats van het voorvoegsel opnieuw te verwerken.
- Genereren. Het model verwerkt alleen de nieuwe inhoud en produceert het antwoord sneller.
Omdat de cache gekoppeld is aan het exacte voorvoegsel, zorgt zelfs een kleine wijziging aan het begin ervoor dat de match niet meer klopt. Het meest cachebare ontwerp plaatst de stabiele inhoud, zoals de systeemprompt en vaste context, eerst en de variabele inhoud als laatste.
Wat levert prompt-caching op?
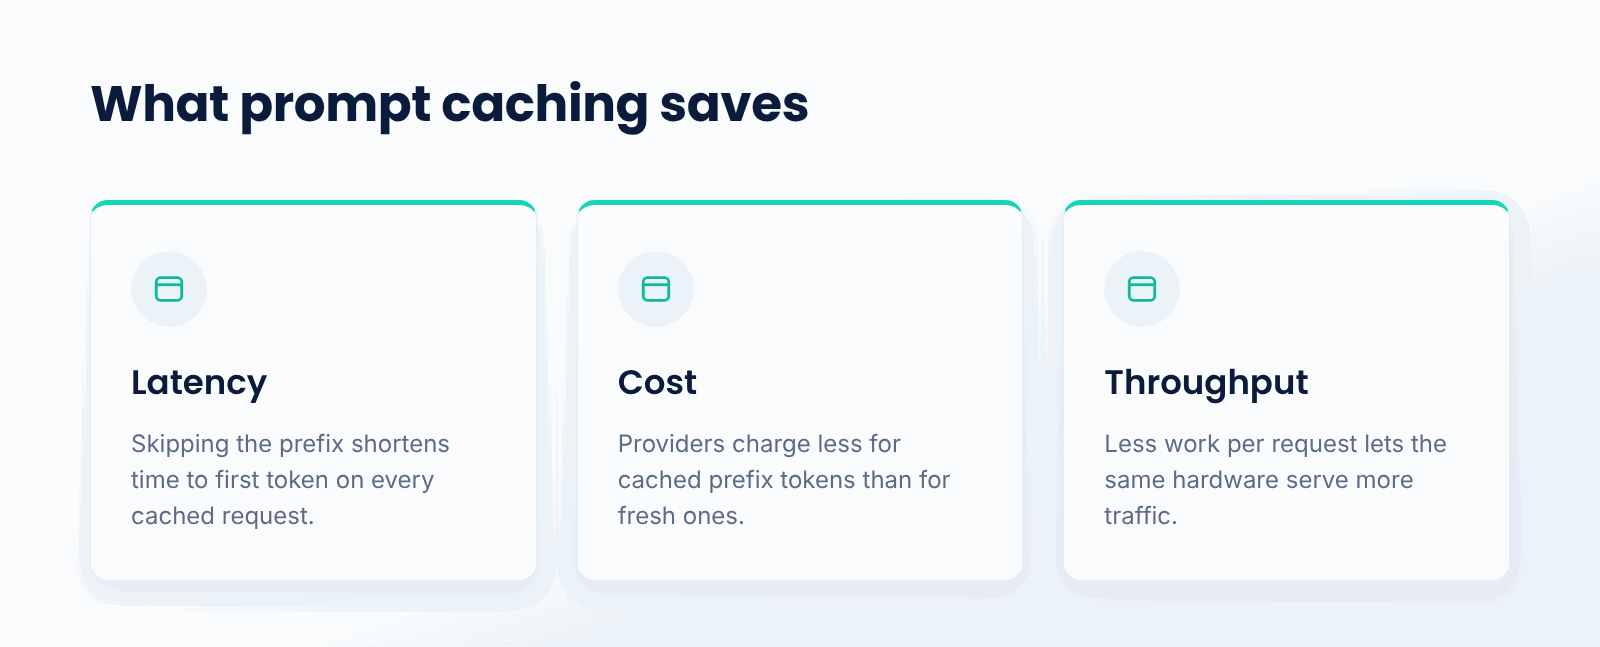
Het voordeel is op drie manieren merkbaar. De latentie daalt omdat het model het voorvoegsel niet opnieuw hoeft te verwerken, wat vooral de tijd tot het eerste token verkort. De kosten dalen omdat aanbieders doorgaans minder rekenen voor gecachte voorvoegsel-tokens dan voor nieuwe. De doorvoersnelheid verbetert omdat elk verzoek minder werk vereist, waardoor dezelfde hardware meer verkeer kan verwerken.
Deze winst schaalt mee met hoe groot en hoe vaak het voorvoegsel wordt herhaald. Een korte prompt die eenmalig wordt verzonden levert weinig op; een lange context die bij duizenden verzoeken wordt hergebruikt levert veel op. Daarom is caching vooral belangrijk voor toepassingen met een hoog volume en veel gedeelde context.
Wanneer is prompt-caching nuttig?
- Lange systeemprompts. Een groot instructieblok dat bij elk verzoek wordt hergebruikt, is uitstekend te cachen.
- Document-Q&A. Herhaalde vragen over hetzelfde document maken gebruik van de reeds verwerkte context.
- Few-shot prompts. Vaste voorbeelden aan het begin van elke prompt zijn cachebaar.
- Chatgeschiedenis. Een stabiel gespreksvoorvoegsel kan worden hergebruikt naarmate de chat groeit.
- Hoog verzoekvolume. Hoe vaker hetzelfde voorvoegsel wordt herhaald, hoe meer caching loont.
Wat zijn de beperkingen?
- Exacte match vereist. Elke wijziging aan het voorvoegsel, hoe klein ook, veroorzaakt een cache-miss.
- Cache-levensduur. Gecachte voorvoegsels verlopen, dus bij zeer zelden hergebruik wordt de cache mogelijk niet geraakt.
- Prompt-volgorde. Voordelen vereisen eerst stabiele inhoud en daarna variabele inhoud.
- Niet universeel. Eenmalige of sterk variabele prompts hebben weinig baat bij caching.
Wanneer moet je prompt caching gebruiken?
Gebruik het wanneer je applicatie herhaaldelijk een grote, stabiele prefix verstuurt; dit komt vaak voor bij assistenten met lange systeemprompts, documenttools en few-shot-opstellingen. Hoe groter de gedeelde context en hoe hoger het aantal verzoeken, des te meer caching zowel de snelheid als de kosten verbetert.
Voor korte, unieke prompts die incidenteel worden verstuurd, voegt caching weinig toe. Maar het structureren van prompts zodat het stabiele deel eerst komt, en het inschakelen van caching waar de provider dit ondersteunt, is meestal een makkelijke winst voor productieworkloads.
Best practices voor prompt caching
- Plaats stabiele inhoud, systeemprompts en vaste context aan het begin van de prompt.
- Houd variabele, per-verzoek inhoud aan het einde, zodat de prefix constant blijft.
- Hergebruik exact dezelfde prefix-tekst zodat de cache betrouwbaar wordt geraakt.
- Meet latentie en kosten met en zonder caching om de winst te bevestigen.
- Houd rekening met de levensduur van de cache, zodat je weet wanneer hergebruik nog voordeel oplevert.
- Gebruik een gateway om caching consistent toe te passen en te monitoren over verschillende modellen heen.
Conclusie
Prompt caching hergebruikt de verwerkte vorm van een herhaalde prompt-prefix, zodat het model deze niet bij elk verzoek opnieuw hoeft te berekenen. Voor applicaties die een grote, stabiele context opnieuw versturen, verlaagt dit de latentie en kosten en verhoogt het de doorvoer, waarbij de winst toeneemt naarmate de prefix groter en vaker herhaald wordt. De belangrijkste vereiste is een exacte prefix-match, wat het loont om stabiele inhoud eerst te plaatsen.
Met de AI Gateway van TrueFoundry kunnen teams profiteren van prompt caching over verschillende modellen heen en het effect op latentie en kosten op één plek monitoren. Naarmate LLM-applicaties steeds grotere gedeelde contexten versturen, is caching een directe manier om ze sneller en goedkoper te maken.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is prompt caching in simple terms?
It is reusing the model's processing of a repeated part of a prompt so it does not redo that work every time. When many requests share the same long opening, the model processes that opening just once and reuses it, which is faster and cheaper.
What does prompt caching actually store?
Not only the text itself, but the model's processed representation of the prefix. That is what lets the model skip the computation on later requests, so the saving is in the work avoided, not only in storing the words.
Why does the prefix have to match exactly?
Because the cache is keyed to the exact content of the prefix. Even a small change at the start produces a different key and a cache miss, which is why stable content should come first and variable content last.
How much does prompt caching save?
It depends on the length and repetition of the prefix. A long context reused across many requests can cut time to first token and prefix cost substantially, whereas a short, one-off prompt gains little.
When should I not rely on prompt caching?
When prompts are short, unique, or highly variable, or when the shared prefix changes on every request. In those cases there is little or nothing to reuse, so caching provides little benefit.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


