


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is pipeline-parallelisme en waarom is het belangrijk?

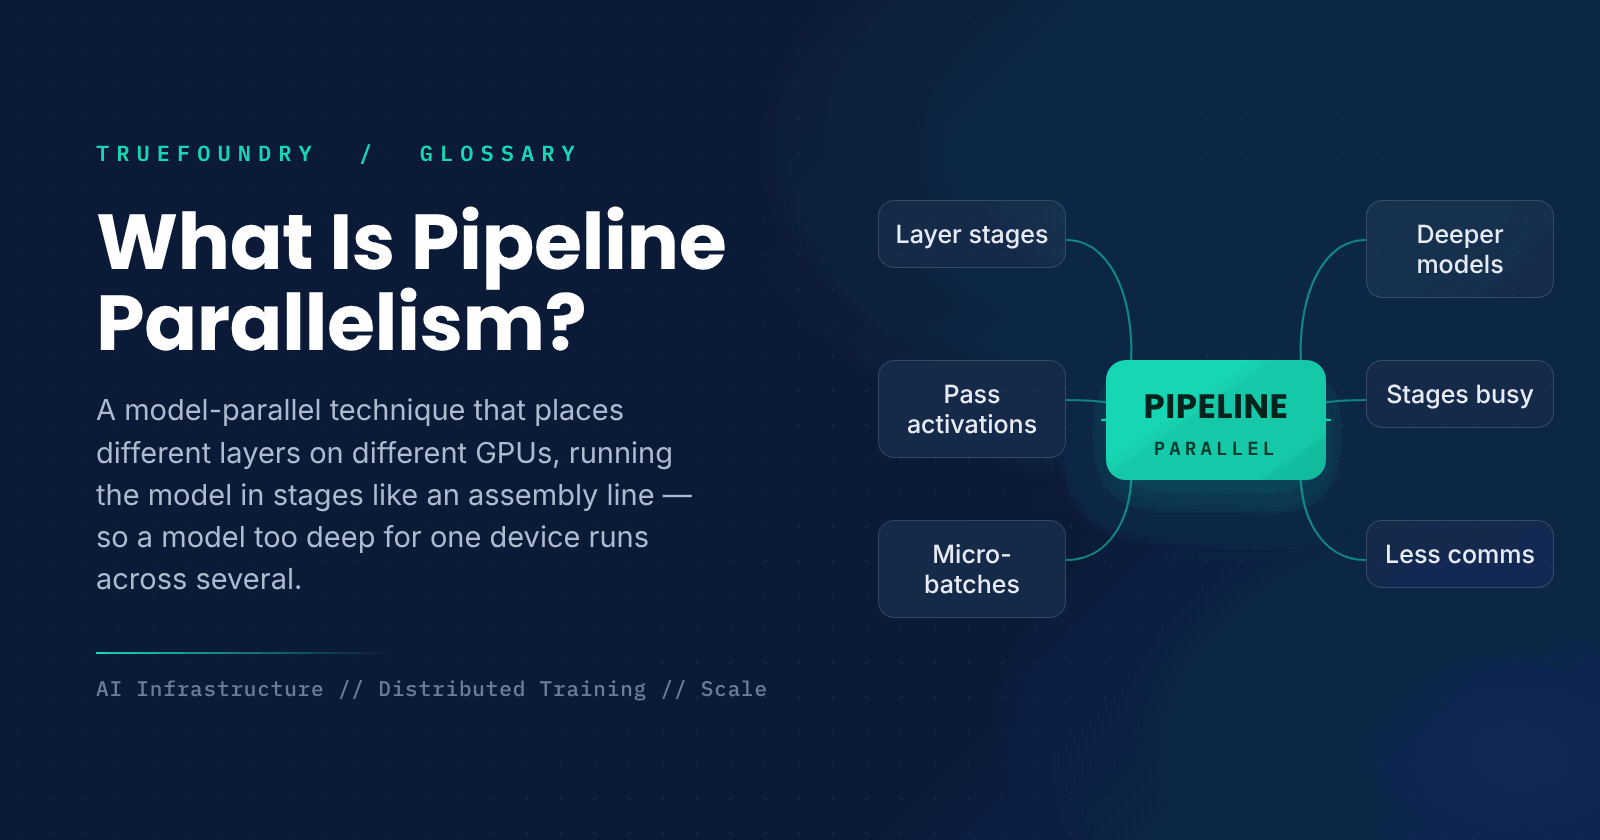
Wanneer een model te veel lagen heeft om op één GPU te passen, is een manier om het werk te verdelen om verschillende lagen op verschillende apparaten te zetten. Pipeline-parallelisme doet precies dit: het verandert het model in een lopende band waarbij elke GPU een opeenvolgend blok lagen beheert en zijn output doorgeeft aan de volgende. Het is een van de belangrijkste strategieën voor het draaien van modellen die te groot zijn voor één apparaat.
De uitdaging is om alle GPU's aan het werk te houden, omdat een eenvoudige splitsing de meeste GPU's inactief laat terwijl er slechts één werkt. Pipeline-parallelisme lost dit op door meerdere kleine batches tegelijk door de lijn te voeren, zodat elke fase aan een andere batch werkt. Deze gids legt uit wat het is, hoe het werkt en hoe het zich verhoudt tot andere parallellisatiestrategieën.
We behandelen de definitie, de werking, hoe het zich verhoudt tot tensor- en dataparallelisme, en wanneer je het moet gebruiken.
Wat is pipeline-parallelisme?
Pipeline-parallelisme is een techniek voor modelparallelisme die een model per laag over meerdere GPU's splitst, zodat elk apparaat een opeenvolgende fase van het model bevat en uitvoert. Data stroomt in volgorde door de fasen: de eerste GPU berekent de vroege lagen en geeft zijn activaties door aan de volgende, enzovoort, totdat de laatste GPU de output produceert.
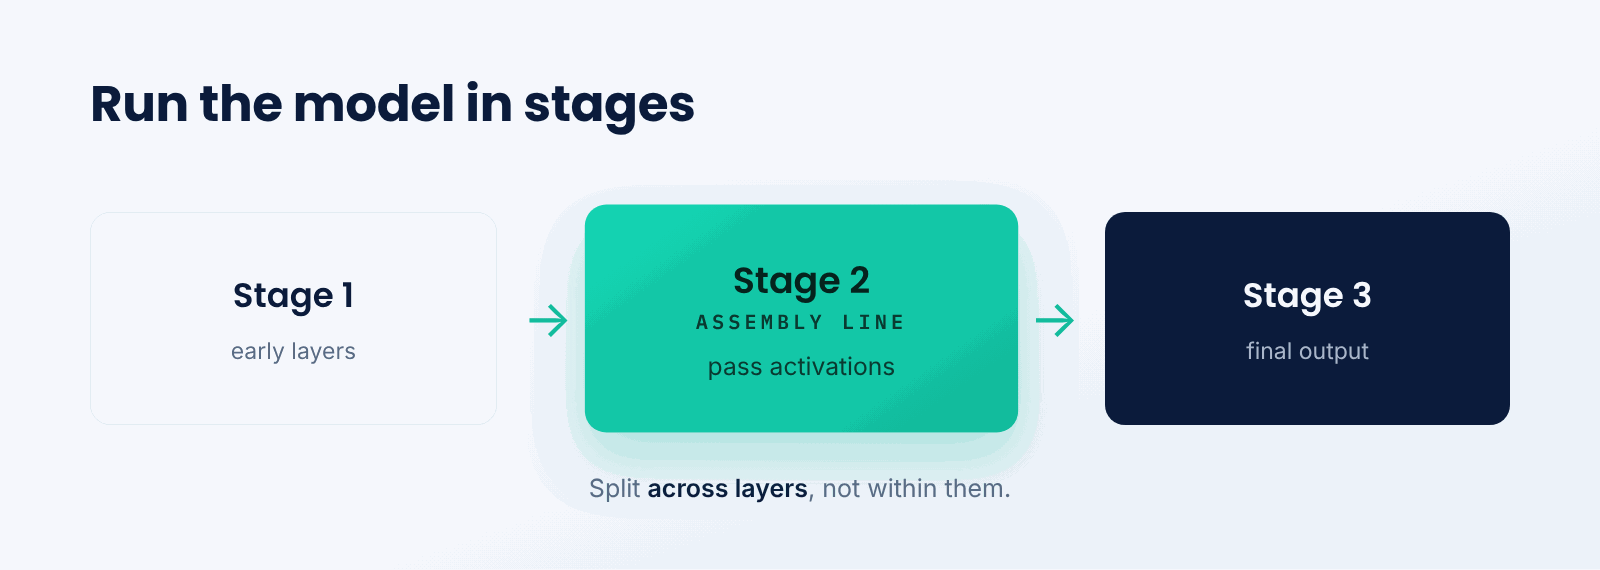
Zie het als een lopende band in een fabriek. Elke werknemer voert een reeks stappen uit en geeft het product door aan het volgende station. Geen enkele werknemer bouwt het hele product, net zoals geen enkele GPU het hele model bevat, maar samen levert de lijn eindresultaten op.
Het kernidee is splitsen over lagen, niet binnen lagen. Hierdoor kan een model dat te diep is voor één GPU toch draaien door de lagen te verdelen, waarbij elke GPU verantwoordelijk is voor slechts een deel van de diepte.
Hoe werkt pipeline-parallelisme?
Pipeline-parallelisme wijst laagfasen toe aan GPU's en streamt micro-batches door hen heen.
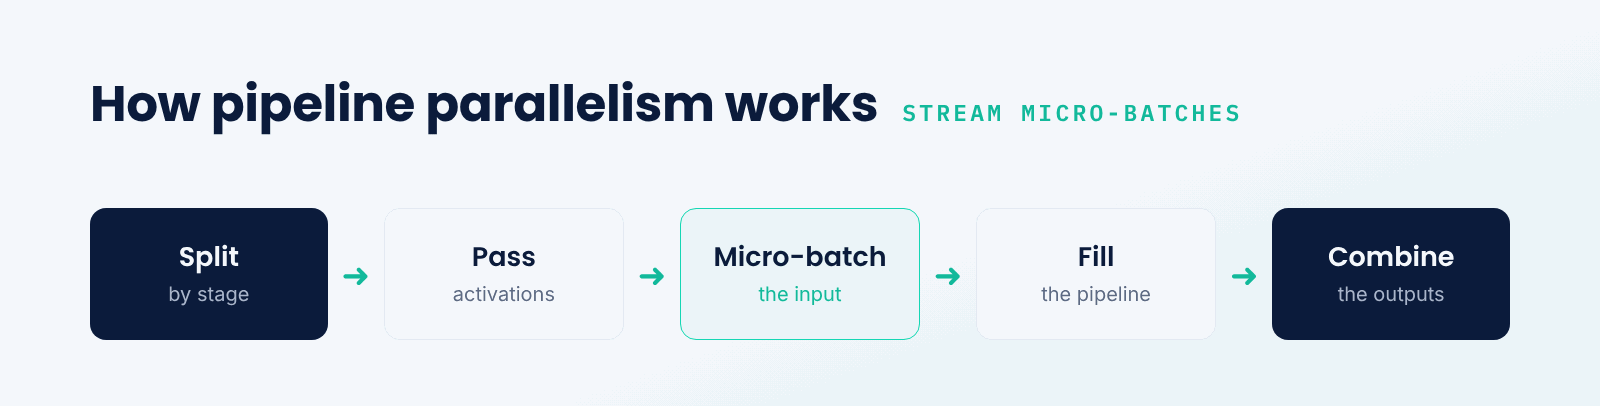
- Splitsen per fase. Wijs elke GPU een opeenvolgend blok lagen toe.
- Activaties doorgeven. Elke fase stuurt zijn output naar de volgende GPU.
- De batch splitsen. Breek elke batch op in kleinere micro-batches.
- De pipeline vullen. Voer micro-batches in zodat elke fase bezig blijft.
- Combineer.Verzamel de outputs zodra ze uit de laatste fase komen.
Zonder micro-batches werkt er telkens maar één GPU terwijl de andere wachten, wat inefficiënt is. Door veel micro-batches door de pipeline te streamen, verwerkt elke fase tegelijkertijd een andere batch, waardoor de GPU's aan het werk blijven. Er is nog steeds wat inactieve tijd aan het begin en einde van de pipeline, bekend als de 'bubble', die door kleinere micro-batches kan worden verminderd.
Pipeline- vs. tensor- vs. dataparallelisme
Dataparallelisme repliceert het volledige model op elke GPU en splitst de data; hiervoor moet het volledige model op één apparaat passen. Tensorparallelisme splitst de berekeningen binnen elke laag over GPU's, wat de oplossing is wanneer een laag te groot is voor één apparaat. Pipeline-parallelisme splitst over lagen, wat de oplossing is wanneer een model te diep is voor één apparaat.
De drie zijn complementair en worden vaak gecombineerd voor de grootste modellen: tensorparallelisme binnen een server, pipeline-parallelisme over servers heen, en dataparallelisme over replica's. Pipeline-parallelisme pakt specifiek de modeldiepte aan, met minder communicatie dan tensorparallelisme, maar met de extra complexiteit van het beheren van de pipeline en de bijbehorende 'bubble'.
Waarom is pipeline-parallelisme belangrijk?
- Diepte. Het draait modellen die te diep zijn voor een enkele GPU.
- Efficiëntie. Micro-batches houden alle fasen bezet.
- Lichtere communicatie. Het verstuurt alleen activaties tussen fasen.
- Composability.Het combineert met tensor- en dataparallelisme.
- Schaal.Het helpt bij het trainen en serveren van de grootste modellen.
Wat zijn de uitdagingen?
- De 'bubble'. Fasen staan stil aan het begin en einde van de pipeline.
- Balans. Fasen moeten gelijkmatig worden verdeeld om knelpunten te voorkomen.
- Complexiteit.Het beheren van micro-batches en fasen is complex.
- Latentie. Een enkel verzoek doorloopt nog steeds elke fase op volgorde.
Wanneer moet je pipeline-parallelisme gebruiken?
Gebruik pipeline-parallelisme wanneer een model te diep is om op één GPU te passen en je de lagen over verschillende apparaten wilt verdelen. Het is vooral nuttig bij GPU's die niet nauw met elkaar verbonden zijn, omdat er minder communicatie nodig is dan bij tensor-parallelisme; er worden alleen activaties tussen de fasen doorgegeven in plaats van resultaten uit te wisselen binnen elke laag.
Als je model op één GPU past, heb je dit niet nodig. Als een individuele laag het probleem is in plaats van de algehele diepte, is tensor-parallelisme wellicht een betere keuze. Voor grote, diepe modellen is pipeline-parallelisme een van de belangrijkste instrumenten, vaak in combinatie met andere strategieën.
Belangrijke punten over pipeline-parallelisme
- Pipeline-parallelisme verdeelt een model op basis van lagen over verschillende GPU's.
- Het model draait in fasen, vergelijkbaar met een lopende band.
- Micro-batches zorgen ervoor dat elke fase tegelijkertijd actief blijft.
- Een pipeline-bubble veroorzaakt enige inactiviteit die moet worden beheerd.
- Er is minder communicatie nodig dan bij tensor-parallelisme.
- Het kan worden gecombineerd met tensor- en data-parallelisme voor grote modellen.
Conclusie
Pipeline-parallelisme draait een model dat te diep is voor één GPU door de lagen over apparaten te verdelen, waardoor het model als een lopende band werkt waarbij elke GPU een fase voor zijn rekening neemt. Door micro-batches door de pipeline te streamen, blijven alle fasen bezet. Omdat er alleen activaties tussen de fasen worden doorgegeven, is er minder communicatie nodig dan bij tensor-parallelisme. Het is een kernstrategie voor het trainen en serveren van grote, diepe modellen.
TrueFoundry helpt teams om efficiënt grote modellen te trainen en te serveren op hun eigen infrastructuur, inclusief de parallelle strategieën die een model over vele GPU's verspreiden. Wanneer een model te diep is voor één apparaat, is pipeline-parallelisme een van de belangrijkste technieken om het draaiende te houden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is pipeline parallelism in simple terms?
It is a method of running a large model across multiple GPUs, where each one gets a block of the model's layers, so they become individual stations on an assembly line. The data passes through each stage in order, allowing a model too deep for a single GPU to run across several together.
How is pipeline parallelism different from tensor parallelism?
Pipeline parallelism applies parallelism between layers, with each stage allocated to a different GPU. Tensor parallelism applies parallelism within a layer, so several GPUs process one layer that a single GPU cannot. Pipeline parallelism handles model depth; tensor parallelism handles a layer too big for one GPU.
What is the pipeline bubble?
It refers to the idle time at both ends of the pipeline, where some stages have no batch to process yet or have already finished. By feeding many small micro-batches through the pipeline, the bubble is minimized and more stages stay busy more of the time.
Why use micro-batches in pipeline parallelism?
Because without them only one stage operates at a time while the others wait. By breaking the batch into smaller micro-batches and passing them through the pipeline, every stage works on a different micro-batch at once, keeping all the GPUs busy and improving efficiency.
When should I use pipeline parallelism?
When the model is too deep to fit on one GPU and you need to distribute its layers across several devices. It is especially useful when the GPUs are loosely connected, because it communicates less than tensor parallelism. In the biggest models it is usually combined with tensor and data parallelism.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


