


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Parameter-Efficient Fine-Tuning en hoe werkt het?

Het volledig finetunen van een groot taalmodel betekent dat elk van de miljarden gewichten moet worden bijgewerkt, wat enorm veel geheugen vereist en voor elke taak een volledige kopie van het model oplevert. Voor de meeste teams is dat onpraktisch. Parameter-efficient fine-tuning is de verzameling technieken die het aanpassen van grote modellen betaalbaar heeft gemaakt door veel minder parameters te wijzigen.
Het gedeelde idee is simpel: bevries het voorgetrainde model en train alleen een kleine set extra of geselecteerde parameters die het gedrag ervan sturen. Je krijgt een model dat is aangepast aan jouw taak zonder de volledige kosten van hertraining te betalen.
Deze gids legt uit wat parameter-efficient fine-tuning is, hoe het werkt, wat de belangrijkste methoden zijn en wanneer je het moet gebruiken.
Wat is parameter-efficient fine-tuning?
Parameter-efficient fine-tuning, of PEFT, is een reeks methoden die een voorgetraind model aanpassen door slechts een kleine fractie van de parameters te trainen. Het grootste deel van het model blijft bevroren en het leerproces concentreert zich op enkele nieuwe of geselecteerde gewichten, waardoor het aantal trainbare parameters wordt teruggebracht van miljarden naar enkele miljoenen of minder.
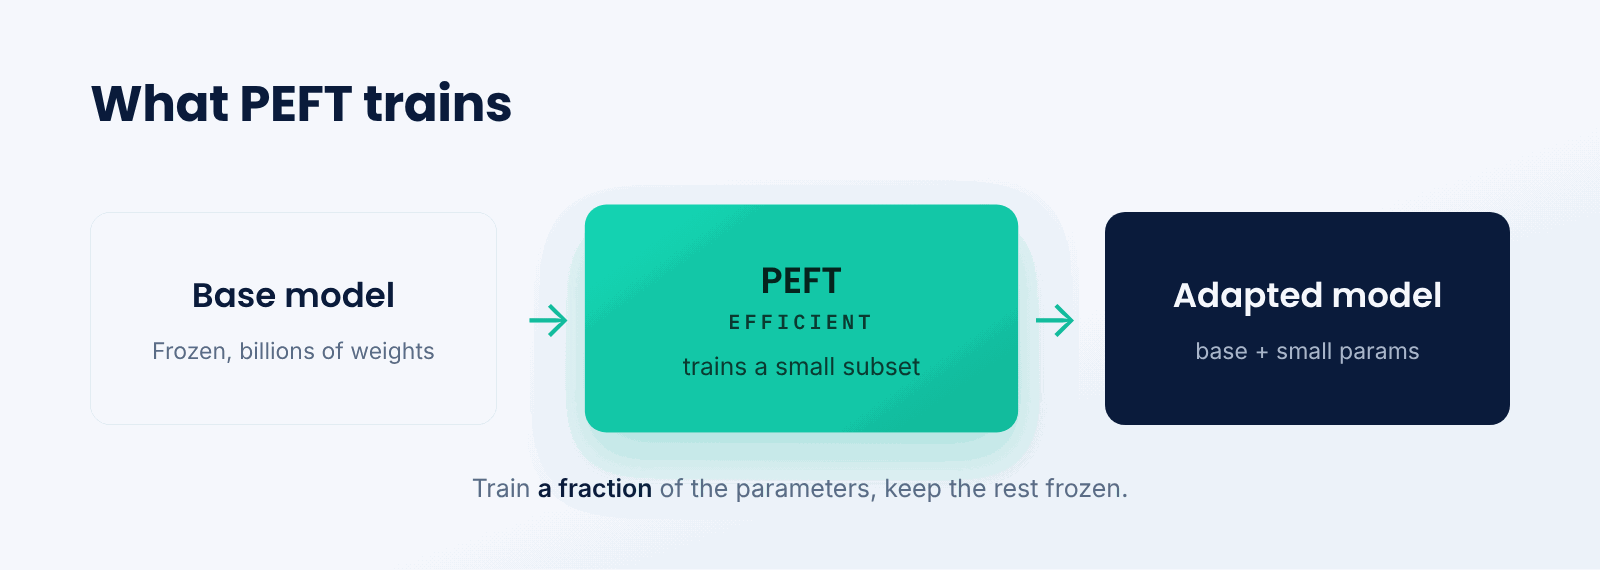
Denk aan het vermaken van een confectiepak in plaats van een nieuw pak te weven. Het pak past al grotendeels goed; een kleermaker past de zoom en mouwen met een paar kleine wijzigingen aan in plaats van het hele kledingstuk opnieuw te maken. PEFT voert die kleine, gerichte aanpassingen uit aan een model dat al capabel is, in plaats van het opnieuw op te bouwen.
Het belangrijkste inzicht is dat het aanpassen van een model aan een nieuwe taak meestal slechts een kleine wijziging vereist, dus je hoeft de meeste gewichten niet aan te raken om het gewenste gedrag te krijgen.
Hoe werkt parameter-efficient fine-tuning?
PEFT voegt een kleine set trainbare parameters toe aan een bevroren model en stemt alleen die af.
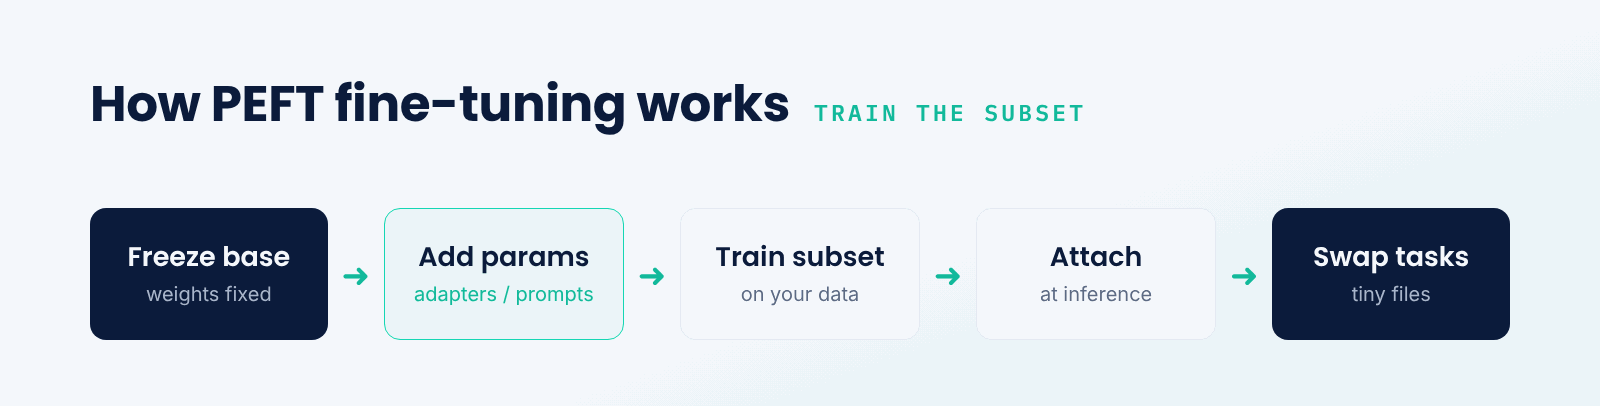
- Bevries het basismodel. De voorgetrainde gewichten worden vastgehouden en niet bijgewerkt tijdens de training.
- Voeg kleine trainbare parameters toe. Een methode voegt adapters, low-rank matrices of soft prompts in die vervolgens worden getraind.
- Train alleen de subset. Het leerproces werkt alleen die paar parameters bij op basis van de data van je taak, wat snel en goedkoop is.
- Koppel tijdens inferentie. De kleine parameters worden toegepast naast het bevroren model om het aangepaste gedrag te produceren.
- Wissel per taak. Omdat de afgestemde parameters minuscuul zijn, kun je van taak wisselen door een andere set te laden.
Omdat slechts een klein deel wordt getraind, daalt het geheugengebruik aanzienlijk en is elk resultaat slechts enkele megabytes groot in plaats van een volledige kopie van het model. Dat maakt het trainen en opslaan van vele gespecialiseerde varianten praktisch.
LoRA vs. adapters vs. prompt tuning
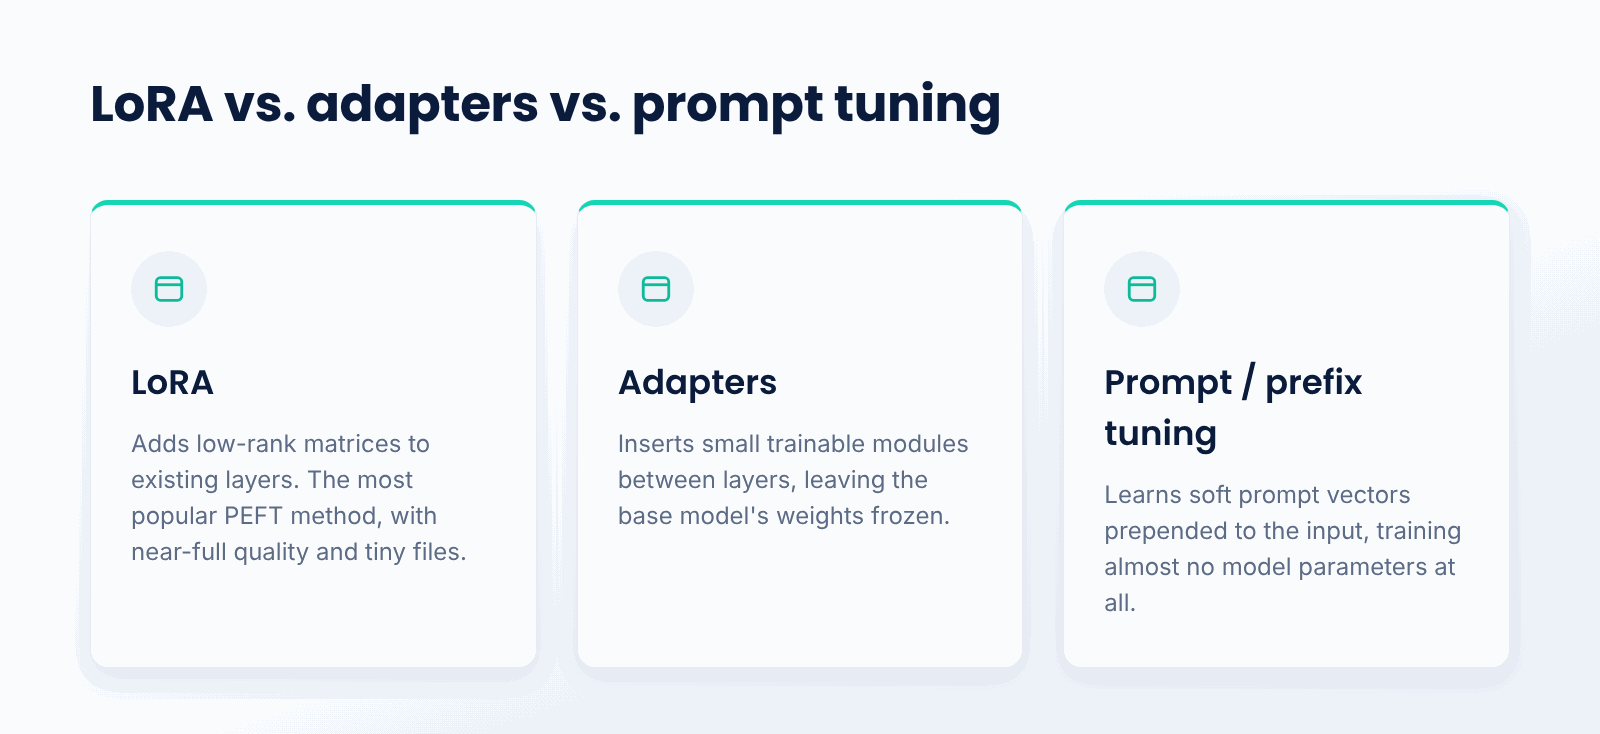
PEFT is een familie van methoden, geen enkele methode. LoRA voegt kleine low-rank matrices toe aan bestaande lagen en is de meest gebruikte methode; het biedt bijna volledige kwaliteit met piepkleine adapters. Adapter-modules voegen kleine trainbare lagen toe tussen de bestaande lagen van het model, terwijl de basis bevroren blijft. Prompt- en prefix-tuning gaan nog een stap verder door zachte prompt-vectoren te leren die aan de invoer worden toegevoegd, waarbij vrijwel geen modelparameters worden getraind.
Deze methoden maken een afweging tussen het aantal parameters dat wordt getraind en de mate waarin het model kan worden aangepast. LoRA is de standaardkeuze omdat het een ideale balans biedt tussen sterke kwaliteit en zeer lage kosten, maar de andere methoden zijn geschikt voor situaties waarin je nog minder wilt trainen.
Wat zijn de voordelen van PEFT?
- Minder geheugengebruik. Door de basis te bevriezen en slechts een klein deel te trainen, is fine-tuning mogelijk op veel lichtere hardware.
- Kleine bestanden. Een getraind resultaat is slechts enkele megabytes groot, in tegenstelling tot een volledige kopie van het model van meerdere gigabytes per taak.
- Sneller en goedkoper. Het trainen van veel minder parameters betekent snellere runs en lagere kosten.
- Vele varianten. Je kunt veel taakspecifieke adapters op één gedeeld basismodel bewaren.
- Bijna volledige kwaliteit. Bij de meeste taken komt PEFT dicht in de buurt van volledige fine-tuning, ondanks dat slechts een fractie van de gewichten wordt getraind.
Wat zijn de beperkingen van PEFT?
- Niet altijd gelijk aan volledige tuning. Voor taken die een ingrijpende gedragsverandering vereisen, kan volledige fine-tuning nog steeds de voorkeur hebben.
- Keuzes in methode en instellingen. De keuze voor een methode, rang of plaatsing beïnvloedt de kwaliteit en vereist afstemming.
- Het aanbieden van veel adapters zorgt voor complexiteit. Het tijdens runtime wisselen van getrainde parameters per verzoek vereist ondersteuning in de runtime.
- Data blijft belangrijk. PEFT maakt trainen goedkoop, maar een slechte dataset levert hoe dan ook een slecht resultaat op.
Wanneer moet je PEFT gebruiken?
PEFT is de juiste standaardkeuze wanneer je een groot model wilt aanpassen aan jouw data zonder de kosten van volledige fine-tuning. Het specialiseren van een model voor een specifiek domein, een bepaalde toon of een taak, zeker wanneer je meerdere varianten nodig hebt, is precies waar PEFT uitblinkt.
Reserveer volledige fine-tuning voor gevallen die een ingrijpende gedragsverandering vereisen en waarvoor je over de hardware en het budget beschikt. Voor de meeste teams en taken levert PEFT het grootste deel van het resultaat tegen een fractie van de kosten.
Best practices voor PEFT
- Begin met LoRA, de meest beproefde en best ondersteunde PEFT-methode.
- Gebruik in eerste instantie een bescheiden adaptergrootte of rang en verhoog deze alleen als de taak meer capaciteit vereist.
- Stel een schone, representatieve dataset samen, aangezien datakwaliteit nog steeds bepalend is voor het resultaat.
- Houd getrainde parameters gescheiden van het basismodel, zodat je van taak kunt wisselen zonder het model te hoeven dupliceren.
- Combineer dit met een gekwantiseerd basismodel, zoals bij QLoRA, om zeer grote modellen te fine-tunen op beperkte hardware.
- Serveer adapters via een engine en gateway die ze efficiënt kan laden en routeren.
Conclusie
Parameter-efficient fine-tuning maakt het aanpassen van grote modellen praktisch door het basismodel te bevriezen en slechts een kleine set parameters te trainen. Het vermindert het geheugen-, reken- en opslaggebruik van fine-tuning aanzienlijk, terwijl het voor de meeste taken bijna net zo goed presteert als volledige fine-tuning. Bovendien levert het kleine, uitwisselbare bestanden op in plaats van volledige kopieën van het model. Methoden zoals LoRA hebben dit de standaardmanier gemaakt om een LLM aan te passen.
TrueFoundry ondersteunt efficiënte fine-tuning met PEFT-methoden zoals LoRA en het serveren van de resultaten op je eigen infrastructuur, waarbij basismodellen en adapters worden beheerd achter één gateway, inclusief autoscaling en observability. Voor teams die open-weight modellen aanpassen, is PEFT meestal de meest praktische weg van een basismodel naar een model dat is afgestemd op hun behoeften.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is parameter-efficient fine-tuning in simple terms?
This technique saves on cost because it trains just a fraction of the model. It gives you a customized model for your needs without the memory cost of training all the weights.
How is PEFT different from full fine-tuning?
Full fine-tuning involves updating all the weights and requires a complete copy of the model per task. In PEFT, the base is frozen and only a few parameters are trained, which results in massive reductions in memory and storage compared with full fine-tuning.
Is LoRA the same as PEFT?
LoRA is an example of PEFT, and perhaps the most used one. PEFT is the more general family that also covers adapter modules and prompt or prefix tuning, where only a limited number of parameters are trained.
Does PEFT reduce model quality?
Rarely more than slightly. For most tasks PEFT approximates full fine-tuning rather accurately. For tasks where the model needs to change fundamentally, full fine-tuning can still have an edge.
What is QLoRA?
QLoRA is a combination of LoRA and a quantized base model, so the frozen weights require far less memory. QLoRA lets us fine-tune very large models even on limited hardware, while keeping LoRA's efficiency.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


