


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is PagedAttention en waarom is het belangrijk?

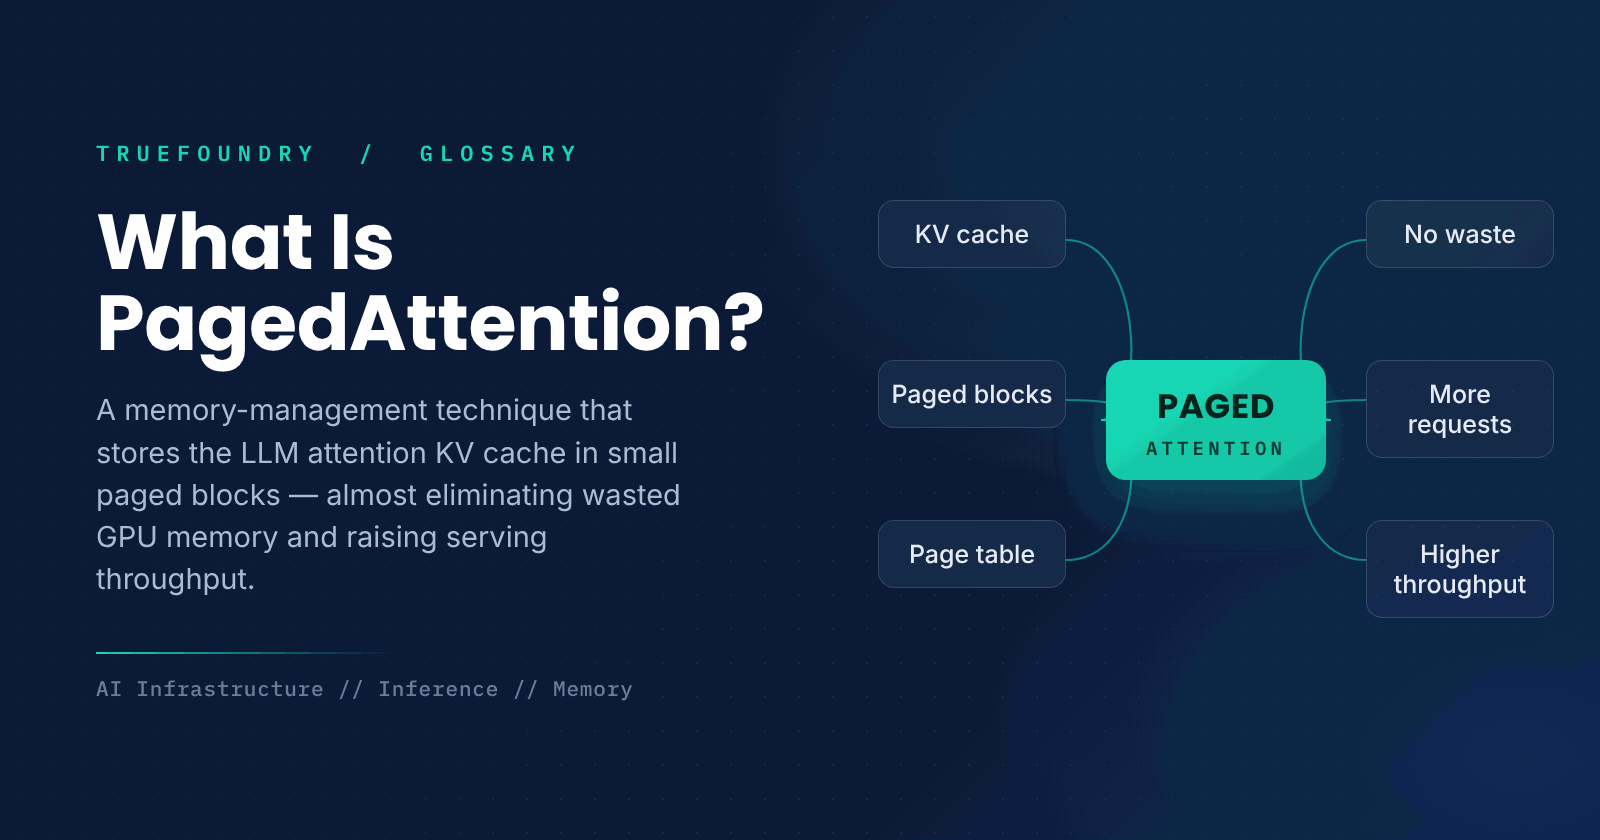
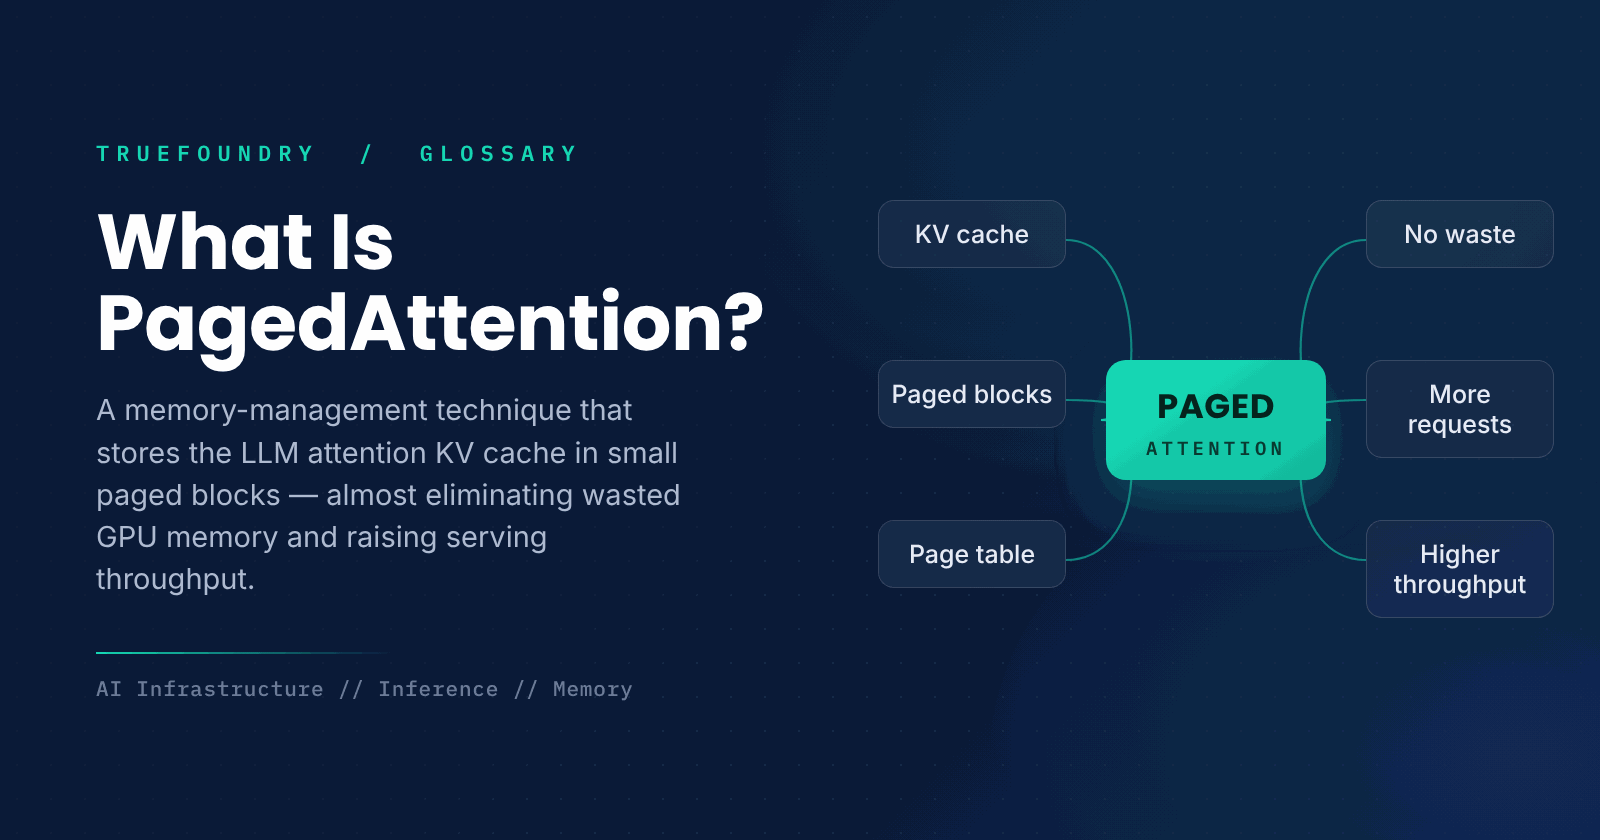
Wanneer een groot taalmodel tekst genereert, houdt het een groeiende cache bij van attention-keys en -values voor elk token tot nu toe, bekend als de KV-cache. Op een drukke inferentieserver met veel gelijktijdige verzoeken domineert deze cache het GPU-geheugen, en de manier waarop dit wordt beheerd bepaalt hoeveel verzoeken de server tegelijkertijd kan afhandelen. Traditionele benaderingen verspillen veel van dat geheugen, wat de doorvoer beperkt.
PagedAttention lost dit op door een decennia oud idee uit besturingssystemen te lenen: paging. In plaats van per verzoek één groot aaneengesloten stuk geheugen te reserveren, slaat het de KV-cache op in kleine blokken met een vaste grootte die overal in het geheugen kunnen staan. Het resultaat is vrijwel geen verspild geheugen en een veel hogere doorvoer. Deze gids legt uit hoe het werkt en waarom het belangrijk is.
We behandelen het geheugenprobleem dat het oplost, hoe paging wordt toegepast op de KV-cache, hoe het zich verhoudt tot traditionele methoden en wanneer het relevant is.
Wat is PagedAttention?
PagedAttention is een techniek voor het beheren van de attention key-value cache tijdens LLM-inferentie door deze op te splitsen in kleine blokken met een vaste grootte die niet aaneengesloten in het GPU-geheugen hoeven te worden opgeslagen. Een opzoektabel koppelt de reeks tokens van elk verzoek aan de verspreide blokken die de cache bevatten, precies zoals de paginatabel van een besturingssysteem het geheugen van een programma koppelt aan fysieke pagina's.
Zie het GPU-geheugen als een parkeerplaats. Bij traditionele methoden wordt voor elke auto een lange, aaneengesloten rij gereserveerd voor het geval de auto groter wordt, waardoor plekken die leeg blijven verloren gaan. PagedAttention parkeert elke auto daarentegen op willekeurige vrije plekken en houdt een kaart bij van waar elke auto staat, zodat er vrijwel geen ruimte wordt verspild.
Het kernidee is het ontkoppelen van de logische reeks van de fysieke opslag. Omdat blokken overal kunnen staan, hoeft er geen geheugen vooraf te worden gereserveerd voor de langst mogelijke output, wat de plek is waar traditionele methoden de meeste capaciteit verspillen.
Hoe werkt PagedAttention?
PagedAttention slaat de KV-cache op in blokken en koppelt logische posities daaraan.
- Splits de cache. Verdeel de KV-cache in kleine blokken met een vaste grootte.
- Wijs toe op aanvraag. Geef een verzoek pas nieuwe blokken wanneer er tokens worden gegenereerd.
- Koppel met een tabel. Houd een paginatabel bij van logische posities naar fysieke blokken.
- Pas attention toe over blokken heen. Bereken attention door de benodigde blokken te verzamelen.
- Vrijgeven en hergebruiken. Geef blokken vrij wanneer een verzoek is voltooid, zodat ze beschikbaar zijn voor het volgende verzoek.
Omdat blokken alleen worden toegewezen wanneer dat nodig is en overal kunnen worden geplaatst, is er vrijwel geen gereserveerd maar ongebruikt geheugen. Blokken kunnen zelfs worden gedeeld tussen verzoeken die met dezelfde prompt beginnen, wat nog meer geheugen bespaart. Door de vrijgekomen capaciteit kan de server veel meer sequenties tegelijkertijd verwerken.
PagedAttention versus traditionele KV-cache-serving
Bij traditionele serving wordt per verzoek één aaneengesloten blok geheugen gereserveerd, ter grootte van de langst mogelijke output. De meeste verzoeken bereiken die lengte nooit, waardoor een groot deel van het gereserveerde geheugen onbenut blijft en fragmentatie nog meer verspilling veroorzaakt. Dit beperkt het aantal verzoeken dat op een GPU past aanzienlijk.
PagedAttention wijst op aanvraag kleine blokken toe en plaatst deze overal, waardoor er vrijwel geen geheugen verloren gaat of gefragmenteerd raakt. Dezelfde GPU kan de caches voor veel meer gelijktijdige verzoeken bevatten, wat de doorvoer aanzienlijk verhoogt. Het nadeel is een bescheiden administratieve overhead voor de paginatabel, die in verhouding tot het bespaarde geheugen verwaarloosbaar is.
Waarom is PagedAttention belangrijk?
- Geheugenefficiëntie. Het elimineert vrijwel alle verspilde KV-cachegeheugen.
- Hogere doorvoer. Er passen meer gelijktijdige verzoeken op elke GPU.
- Lagere kosten.Meer verzoeken per GPU betekent minder hardware per verzoek.
- Prompt-sharing. Gemeenschappelijke voorvoegsels kunnen gecachte blokken delen.
- Schaalbaarheid. Het vormt de basis voor moderne serving-engines met een hoge doorvoer.
Wat zijn de afwegingen?
- Administratie. De paginatabel zorgt voor een kleine hoeveelheid overhead.
- Complexiteit. De serving-engine is complexer om te implementeren.
- Kernel-ondersteuning. Attention-kernels moeten overweg kunnen met niet-aaneengesloten blokken.
- Optimalisatie. De blokgrootte moet een balans vinden tussen overhead en granulariteit.
Wanneer is PagedAttention van belang?
PagedAttention is vooral belangrijk bij het aanbieden van grote taalmodellen aan veel gebruikers tegelijk, waarbij het GPU-geheugen voor de KV-cache de beperkende factor is voor het aantal verzoeken dat je kunt verwerken. Als je een inferentie-service draait en je geeft om doorvoersnelheid en kosten per verzoek, dan is dit een van de meest impactvolle optimalisaties die beschikbaar zijn; daarom is het ingebouwd in toonaangevende serving-engines.
Voor één verzoek tegelijk, of een zeer kleine werklast, zijn de geheugenbesparingen minder relevant. Maar op elke serieuze schaal is PagedAttention vrijwel essentieel om het maximale uit elke GPU te halen.
Kernpunten over PagedAttention
- PagedAttention slaat de KV-cache op in kleine gepagineerde blokken.
- Het past paging uit besturingssystemen toe op GPU-geheugen.
- Het elimineert vrijwel alle verspilling en fragmentatie van geheugen.
- Het stelt een GPU in staat om veel meer gelijktijdige verzoeken te verwerken.
- Veelvoorkomende prompt-prefixen kunnen blokken delen.
- Het is het kernidee achter serving-engines met een hoge doorvoersnelheid.
Conclusie
PagedAttention brengt het concept van paging uit besturingssystemen naar LLM-serving door de attention key-value cache op te slaan in kleine, niet-aaneengesloten blokken in plaats van in één gereserveerd blok per verzoek. Dit elimineert vrijwel alle verspilling van GPU-geheugen, waardoor een server veel meer gelijktijdige verzoeken kan afhandelen en de doorvoersnelheid toeneemt. Het is de doorbraak in geheugenbeheer achter de huidige serving-engines met hoge doorvoersnelheid.
TrueFoundry helpt teams om modellen efficiënt te serveren op hun eigen infrastructuur, inclusief engines met een hoge doorvoersnelheid die PagedAttention gebruiken om meer verzoeken op elke GPU te verwerken. Wanneer inferentiekosten en doorvoersnelheid belangrijk zijn, is efficiënt KV-cachebeheer de bron van de winst.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is PagedAttention in simple terms?
It is a better way of handling GPU memory when serving a language model. Rather than reserving one large chunk of memory for each request, the attention cache is divided into tiny blocks that can be stored anywhere, just like pages in a computer's memory, so very little memory is wasted and more requests fit at once.
What problem does PagedAttention solve?
In traditional serving, memory is allocated per request for the maximum possible output size, so most of it goes to waste, and fragmentation wastes more. That restricts the number of requests a GPU can serve. PagedAttention allocates memory in smaller blocks only as needed, saving that overhead and freeing it for more concurrent requests.
How is PagedAttention like operating-system paging?
Both decouple the logical sequence from its physical storage. An operating system maps a program's memory to scattered physical pages using a page table; similarly, PagedAttention maps a request's token positions to scattered KV cache blocks the same way, so storage need not be contiguous.
Does PagedAttention change the model's output?
No. It only affects the way the key-value cache is stored and retrieved in memory, not how attention is computed mathematically. The output remains the same; the difference lies in how effectively memory is used and how many requests the server can handle.
When should I care about PagedAttention?
When you run a model for many users concurrently and GPU memory becomes your bottleneck. At real serving scale it is one of the highest-impact optimizations and is built into leading engines. For a single request or a small workload, it is much less relevant.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


