


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is modeldistillatie en waarom is het belangrijk?

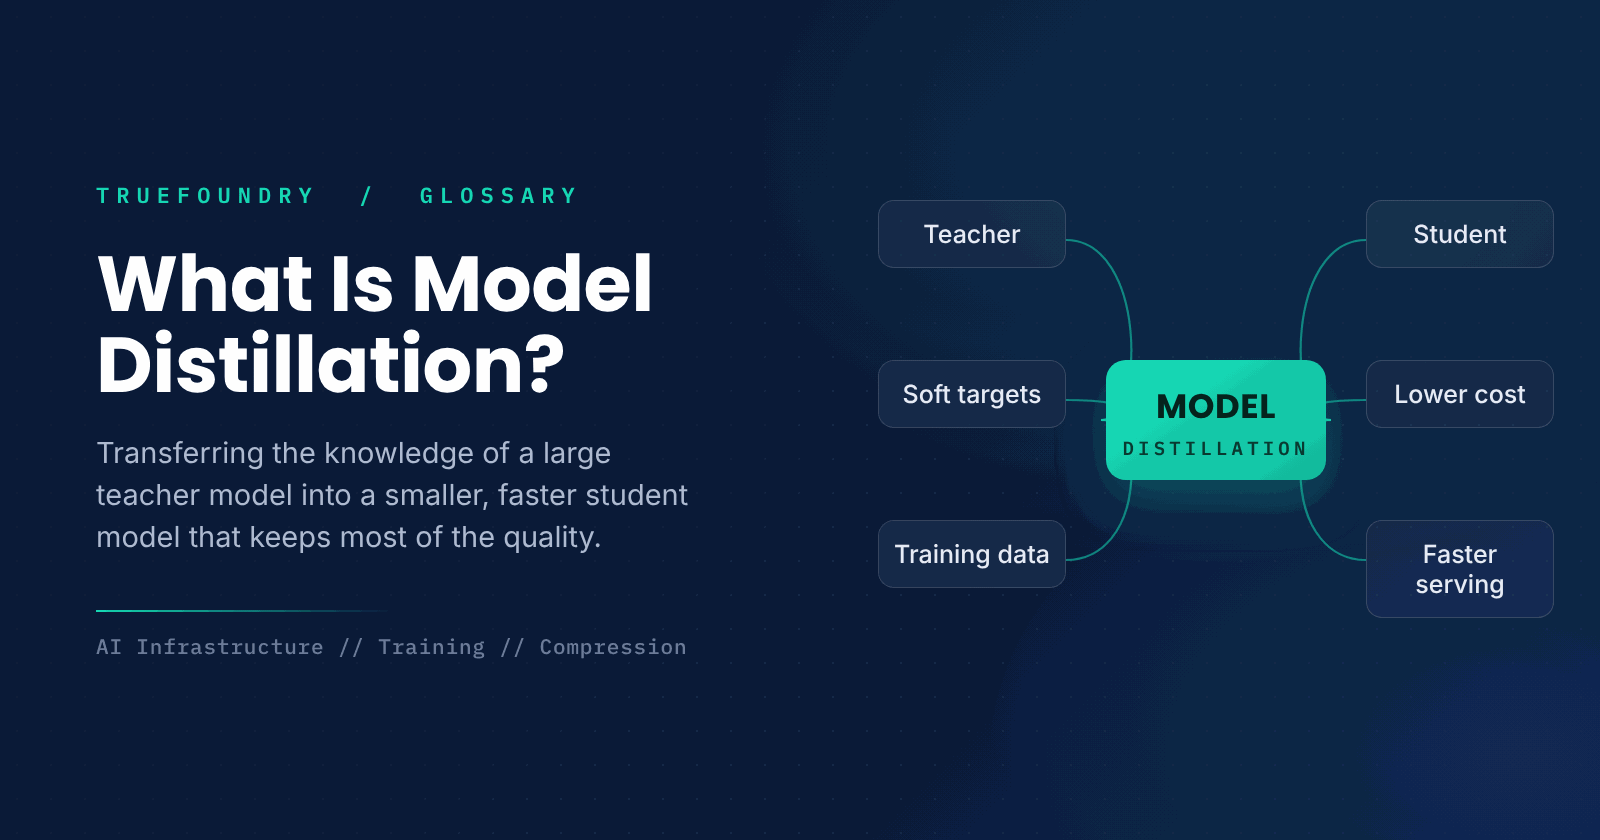
De meest capabele taalmodellen zijn vaak enorm, wat ze duur en traag in het gebruik maakt. Voor veel productietoepassingen is die kostprijs moeilijk te rechtvaardigen, zeker wanneer een kleiner model zou volstaan als het maar iets slimmer was. Modeldistillatie is de techniek die dat gat dicht door een klein model te leren zich als een groot model te gedragen.
Het idee is om een groot, goed getraind model als docent te behandelen en dit te gebruiken om een kleinere student te trainen. In plaats van alleen van de oorspronkelijke dataset te leren, leert de student van het gedrag van de docent, waarbij patronen worden opgenomen die lastig te achterhalen zouden zijn op basis van alleen ruwe labels. Het resultaat is een compact model dat veel beter presteert dan zijn omvang doet vermoeden.
Deze gids legt uit wat modeldistillatie is, hoe het werkt, hoe het zich verhoudt tot andere compressiemethoden en wanneer het de juiste tool is.
Wat is modeldistillatie?
Modeldistillatie is een trainingsmethode waarbij een kleiner studentmodel wordt getraind om de output van een groter docentmodel te reproduceren. In plaats van alleen te leren van de harde labels in een dataset, leert de student ook van de volledige outputdistributie van de docent: de zachte kansberekeningen die de docent toekent aan mogelijke antwoorden, die rijkere informatie bevatten over hoe de docent generaliseert.
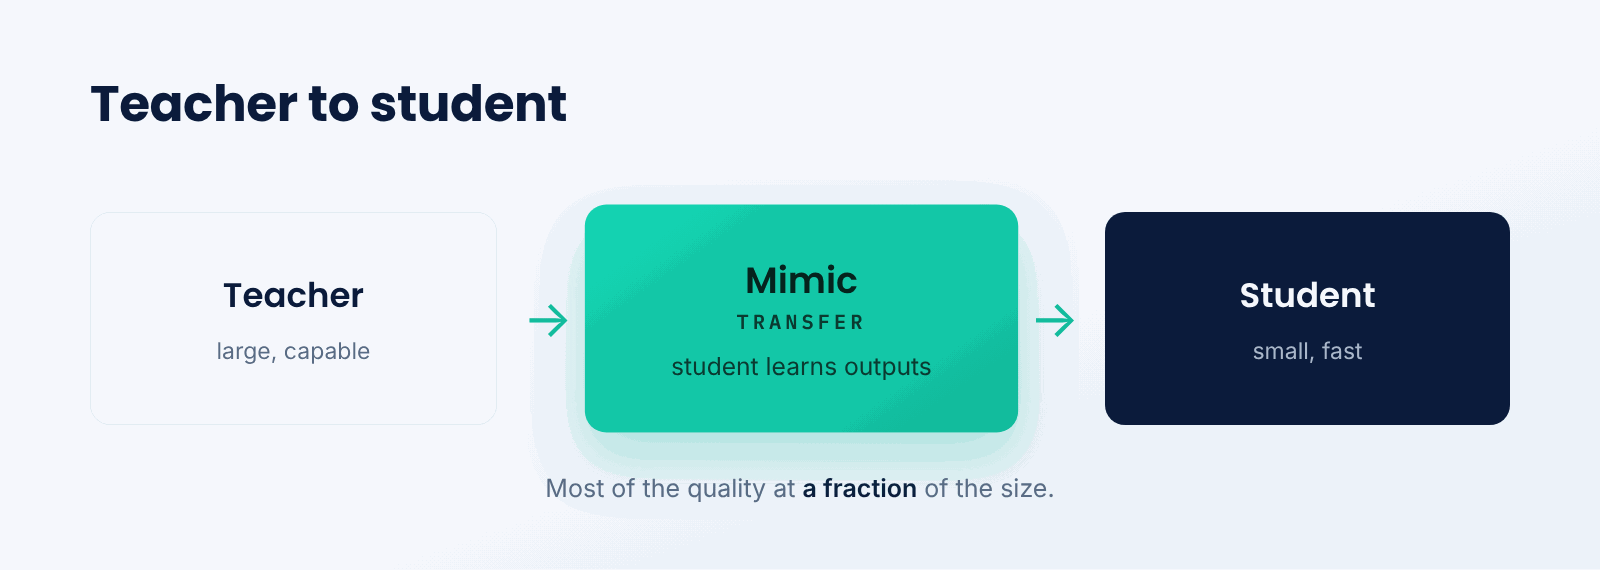
Zie het als een leerling die van een meester leert. De leerling zou alleen het ruwe materiaal kunnen bestuderen, maar leren door naar een expert te kijken – waarbij niet alleen het eindantwoord wordt gezien, maar ook de relatieve zekerheid achter elke keuze – draagt vaardigheden veel sneller over. Het studentmodel neemt het oordeelsvermogen van de docent over, gecomprimeerd in een kleinere vorm.
Het kernidee is dat de zachte outputs van de docent een veel rijker trainingssignaal zijn dan eenvoudige labels. Ze vertellen de student welke antwoorden dicht bij het juiste zitten en welke duidelijk fout zijn, waardoor een klein model genuanceerd gedrag kan aanleren dat het niet gemakkelijk zelf zou kunnen ontdekken.
Hoe werkt modeldistillatie?
Het proces voert de docent uit over trainingsdata en gebruikt de outputs daarvan om de student te begeleiden.
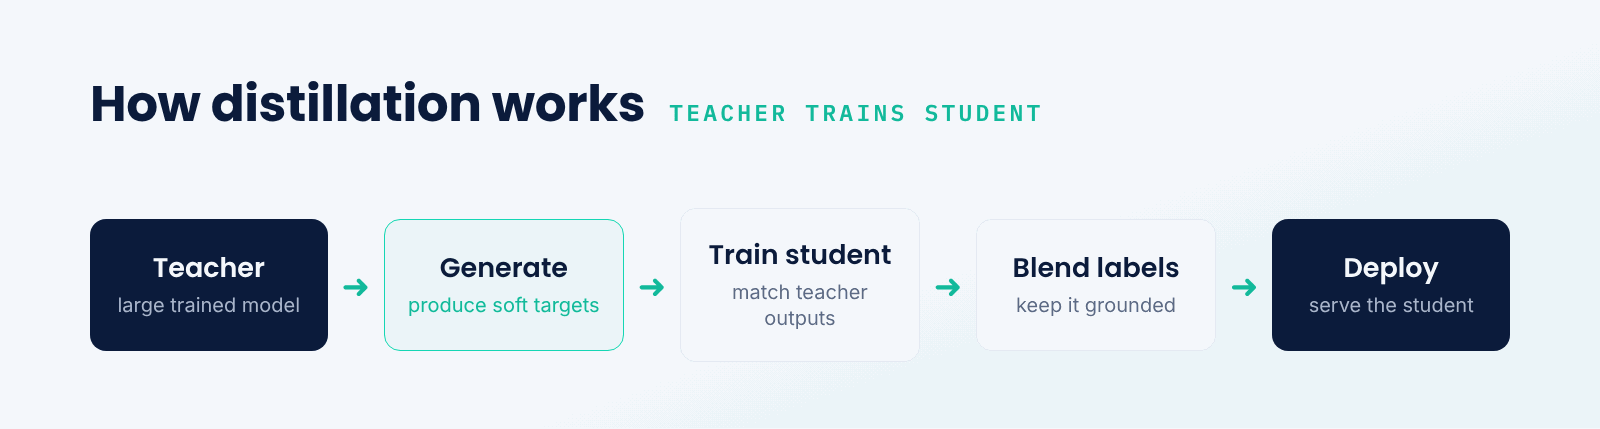
- Train de docent. Begin met een groot model van hoge kwaliteit, of gebruik een bestaand model.
- Genereer doelen. Voer de docent uit over invoerdata om zachte outputs of gegenereerde antwoorden te produceren.
- Train de student. Train het kleinere model om overeen te komen met de outputs van de docent op die data.
- Combineer signalen. Combineer vaak de outputs van de docent met de ware labels om de nauwkeurigheid gegrond te houden.
- Evalueer en implementeer. Controleer of de student voldoende kwaliteit behoudt en zet deze vervolgens in ter vervanging van de docent.
Bij taalmodellen neemt distillatie vaak de vorm aan van het genereren van een grote set antwoorden door een 'teacher'-model, waarna een 'student'-model hierop wordt getraind. Hiermee wordt een groot deel van de capaciteiten van het teacher-model overgedragen op de relevante taken, wat resulteert in een model dat veel goedkoper is in gebruik, terwijl de kwaliteit nagenoeg gelijk blijft.
Distillatie versus andere compressiemethoden
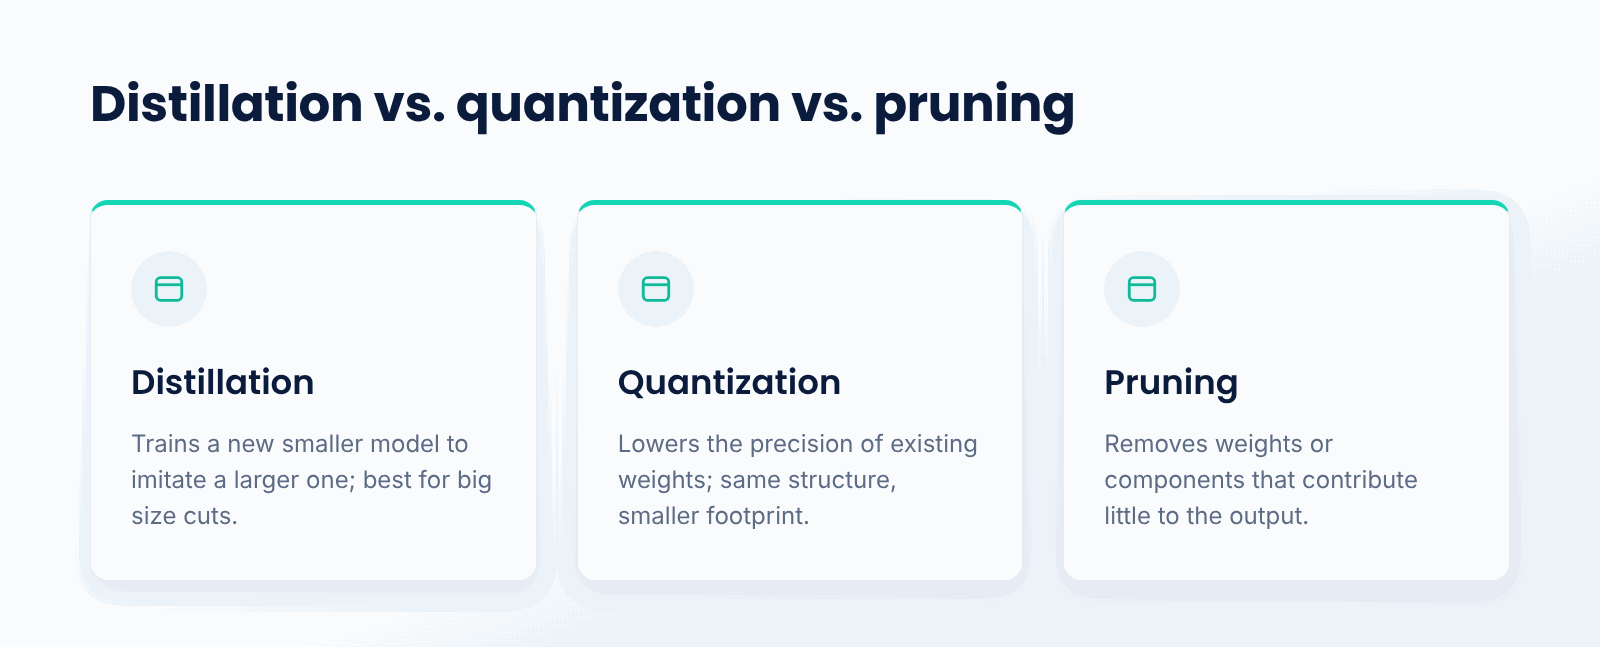
Distillatie is een van de manieren om modellen kleiner te maken. Kwantisatie vermindert de numerieke precisie van de gewichten van een model, waardoor het kleiner wordt zonder de structuur te veranderen. Pruning verwijdert gewichten of volledige onderdelen die nauwelijks bijdragen. Distillatie werkt anders: hierbij wordt vanaf nul een nieuw, kleiner model getraind om een groter model na te bootsen, waardoor het student-model een volledig andere architectuur kan hebben.
Deze methoden zijn complementair. Een model kan worden gedistilleerd tot een kleinere student en vervolgens worden gekwantiseerd voor verdere besparingen. Distillatie behoudt de kwaliteit doorgaans het best wanneer een aanzienlijke verkleining nodig is, omdat de student specifiek wordt getraind om het gedrag van de teacher te reproduceren in plaats van dat het model mechanisch wordt gecomprimeerd.
Waarom is modeldistillatie belangrijk?
- Lagere kosten.Kleinere student-modellen verbruiken minder rekenkracht en geheugen tijdens het draaien.
- Snellere inferentie. Compacte modellen genereren antwoorden met een lagere latentie.
- Edge-implementatie. Gedistilleerde modellen kunnen draaien op hardware met beperkte capaciteit of direct op het apparaat zelf.
- Overdracht van capaciteiten. Een klein model erft een groot deel van de vaardigheden van een groter model.
- Schaalbaarheid.Goedkopere modellen maken toepassingen met grote volumes economisch rendabel.
Wat zijn de afwegingen?
- Kwaliteitsverschil. De student evenaart de teacher zelden volledig, zeker niet bij randgevallen.
- Trainingsinspanning. Distillatie vereist dat het teacher-model wordt gedraaid en het student-model wordt getraind.
- Taakbereik. Een student die is afgestemd op het gedrag van de teacher voor bepaalde taken, generaliseert mogelijk niet naar andere taken.
- Afhankelijkheid van de teacher. Een student kan niet beter zijn dan de leraar van wie hij leert.
Wanneer moet je distillatie gebruiken?
Kies voor distillatie wanneer je een capabel model hebt dat te duur of te traag is voor de schaal die je nodig hebt, en een kleiner model op zichzelf niet de gewenste kwaliteit levert. Het is vooral waardevol voor productietoepassingen met veel verkeer, waar inferentiekosten de boventoon voeren en latentie van belang is.
Als een klein model al aan je kwaliteitseisen voldoet, is distillatie overbodig. En als je de allerhoogste kwaliteit nodig hebt, ongeacht de kosten, dan is het volledige leraarmodel wellicht de juiste keuze. Distillatie blinkt uit in het veelvoorkomende middenveld, waar je de kwaliteit van een groot model wilt benaderen tegen de kosten van een klein model.
Best practices voor modeldistillatie
- Gebruik een sterk en goed afgestemd leraarmodel, aangezien de student het gedrag ervan overneemt.
- Distilleer op basis van data die overeenkomt met je productietaken en distributie.
- Combineer de output van de leraar met ground-truth labels om de student gefundeerd te houden.
- Evalueer de student op basis van echte taken, niet alleen op geaggregeerde benchmarks.
- Overweeg om distillatie te combineren met kwantisatie voor extra besparingen.
- Distilleer opnieuw wanneer het leraarmodel wordt bijgewerkt om de student actueel te houden.
Conclusie
Modeldistillatie draagt de kennis van een groot leraarmodel over naar een kleiner studentmodel, dat leert door de output van de leraar te evenaren. Het resultaat is een compact model dat grotendeels de kwaliteit van de leraar behoudt, terwijl het goedkoper en sneller is in het gebruik. Het is een van de meest effectieve manieren om capabele modellen in te zetten onder reële kosten- en latentiebeperkingen.
TrueFoundry helpt teams om modellen efficiënt te finetunen, distilleren en serveren op hun eigen infrastructuur, zodat een gedistilleerde student op één plek van training naar productie kan gaan. Wanneer kosten en snelheid net zo belangrijk zijn als kwaliteit, is distillatie een essentiële techniek om dat te bereiken.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is model distillation in simple terms?
It means training a small model to mimic a larger one. The larger model becomes the teacher, while the small model is the student that learns from it, retaining much of the quality while saving money and time.
How is distillation different from quantization?
Quantization reduces the numerical precision of an already-built model's weights to shrink it. Distillation involves training a new, smaller model to mimic a larger one. They can be combined: start by distilling the model, then quantize the student for further savings.
Does a distilled model match the teacher's quality?
Generally similar, but not quite. A good student retains the bulk of the teacher's ability on the tasks it was distilled for, while remaining significantly more compact. The difference generally arises on exceptional cases the student has trouble with.
What are soft targets in distillation?
These are the teacher's full probability distribution over possible answers, not just the single correct label. They help the student realize what is a good guess and what is a bad one, a more informative signal that allows the model to learn more subtle behavior.
When should I distill a model instead of using a small one directly?
In cases where the small model falls short of the required level of quality while using the large model would be too expensive or slow, distillation helps transfer the capabilities of the large model into the small one, enabling the attainment of most of the quality at a much lower serving cost.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


