


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Load Balancing en hoe werkt het?

Wanneer veel gebruikers tegelijkertijd een applicatie bezoeken, raakt een server snel overbelast als alle verzoeken naar één punt worden gestuurd: de responstijden worden trager en als die server uitvalt, ligt alles plat. Load balancing lost dit op door een laag voor de servers te plaatsen die verzoeken verdeelt over verschillende identieke backends. Zo wordt het werk gedeeld en vormt geen enkele server een knelpunt.
Voor LLM-applicaties, waarbij elk verzoek kostbaar is en backends vaak schaarse GPU-replica's zijn, is dit nog belangrijker. Een load balancer houdt het verkeer soepel verdeeld over replica's en kan zelfs verder gaan door te routeren tussen verschillende modellen en providers om snelheid, kosten en betrouwbaarheid in balans te houden.
Deze gids legt uit wat load balancing is, hoe het werkt, wat de belangrijkste strategieën zijn en waarom het essentieel is voor het schaalbaar aanbieden van AI.
Wat is load balancing?
Load balancing is het verdelen van inkomende netwerkverzoeken over een groep backend-servers of modelreplica's, zodat de belasting gelijkmatig wordt verdeeld. Een load balancer staat tussen de clients en de backends, ontvangt elk verzoek en stuurt het door naar een backend die is gekozen om het algehele systeem snel en beschikbaar te houden.
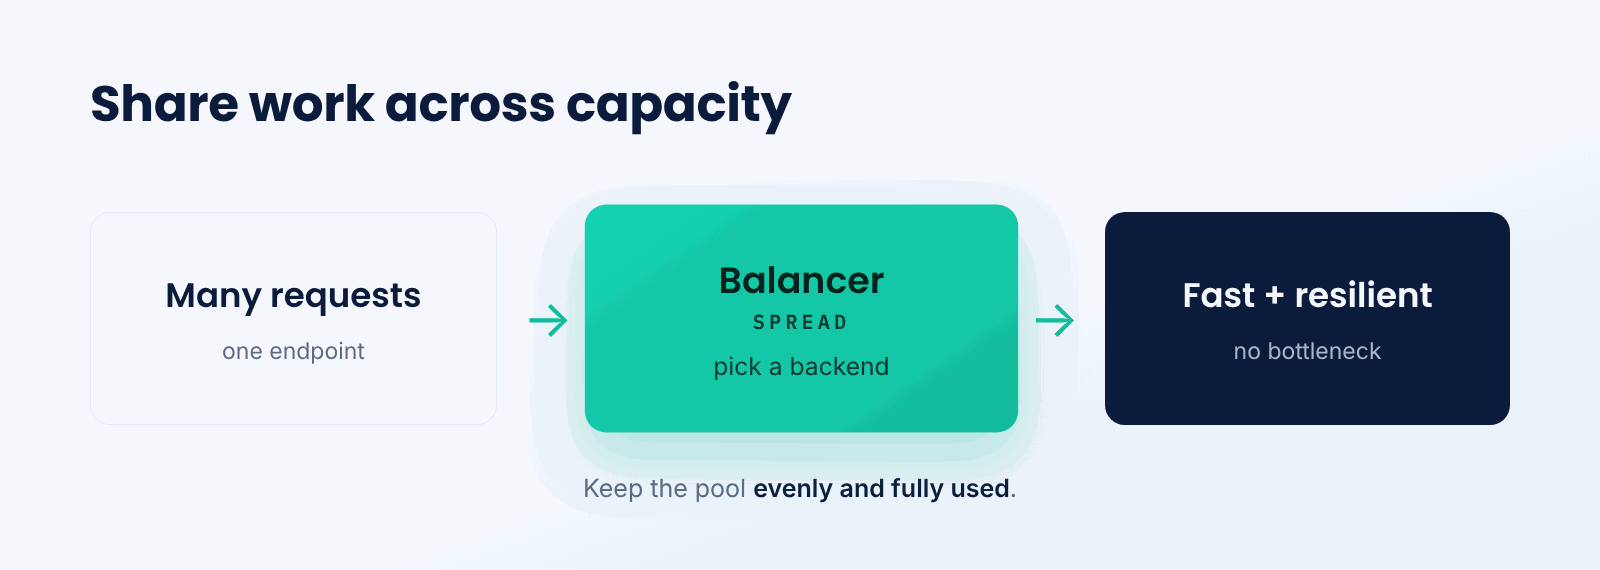
Zie het als een gastheer in een druk restaurant die gasten over veel obers verdeelt in plaats van iedereen naar één tafel te sturen. Elke ober krijgt een eerlijk deel van het werk, gasten worden sneller bediend en als een ober het te druk heeft, stuurt de gastheer mensen ergens anders heen. Een load balancer doet hetzelfde voor verzoeken.
Het kernidee is om werk te verdelen op basis van capaciteit. In plaats van dat één backend zwaar belast wordt terwijl andere niets doen, zorgt de balancer ervoor dat de hele groep gelijkmatig wordt benut, wat zowel de snelheid als de veerkracht verbetert.
Hoe werkt load balancing?
Een balancer ontvangt elk verzoek, kiest een gezonde backend op basis van een bepaalde strategie en stuurt het verzoek door.
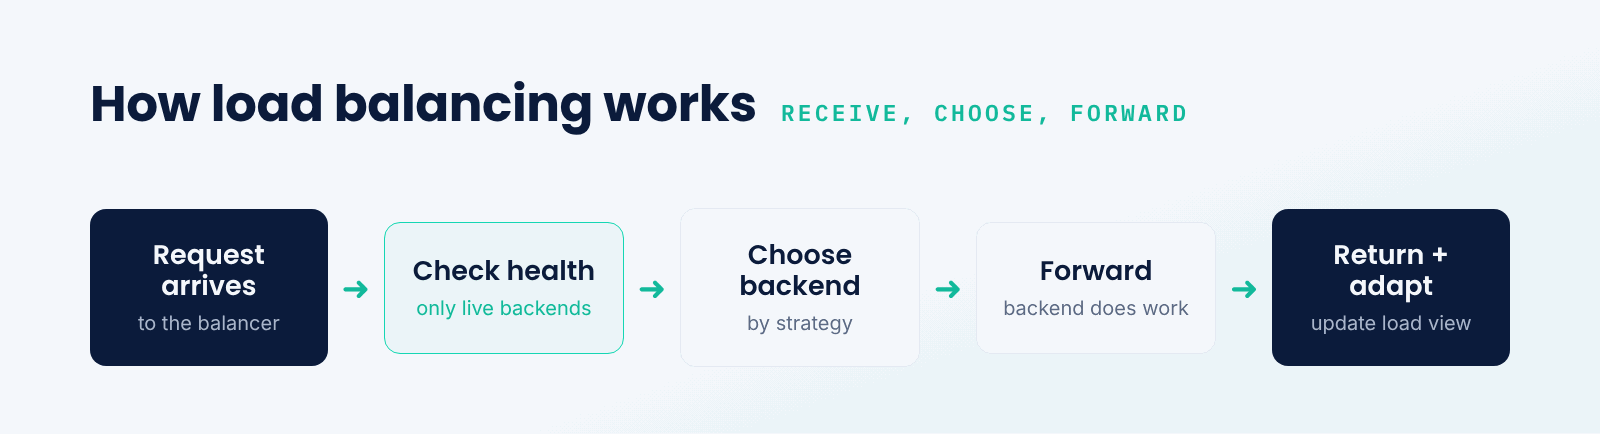
- Verzoek komt binnen. Een client stuurt een verzoek naar de load balancer, niet rechtstreeks naar een backend.
- Status controleren. De balancer kijkt alleen naar backends die actief en responsief zijn.
- Kies een backend. Een strategie kiest er een, op basis van rotatie, belasting of latentie.
- Doorsturen. Het verzoek gaat naar de gekozen backend, die het werk uitvoert.
- Resultaat en aanpassing. Het antwoord wordt teruggestuurd en de balancer werkt zijn beeld van de belasting bij.
Health checks zijn essentieel: door verkeer om te leiden rond backends die traag zijn of offline, houdt de balancer de applicatie beschikbaar, zelfs als individuele servers uitvallen. Dit is net zo belangrijk als het spreiden van de belasting.
Veelvoorkomende strategieën voor load balancing
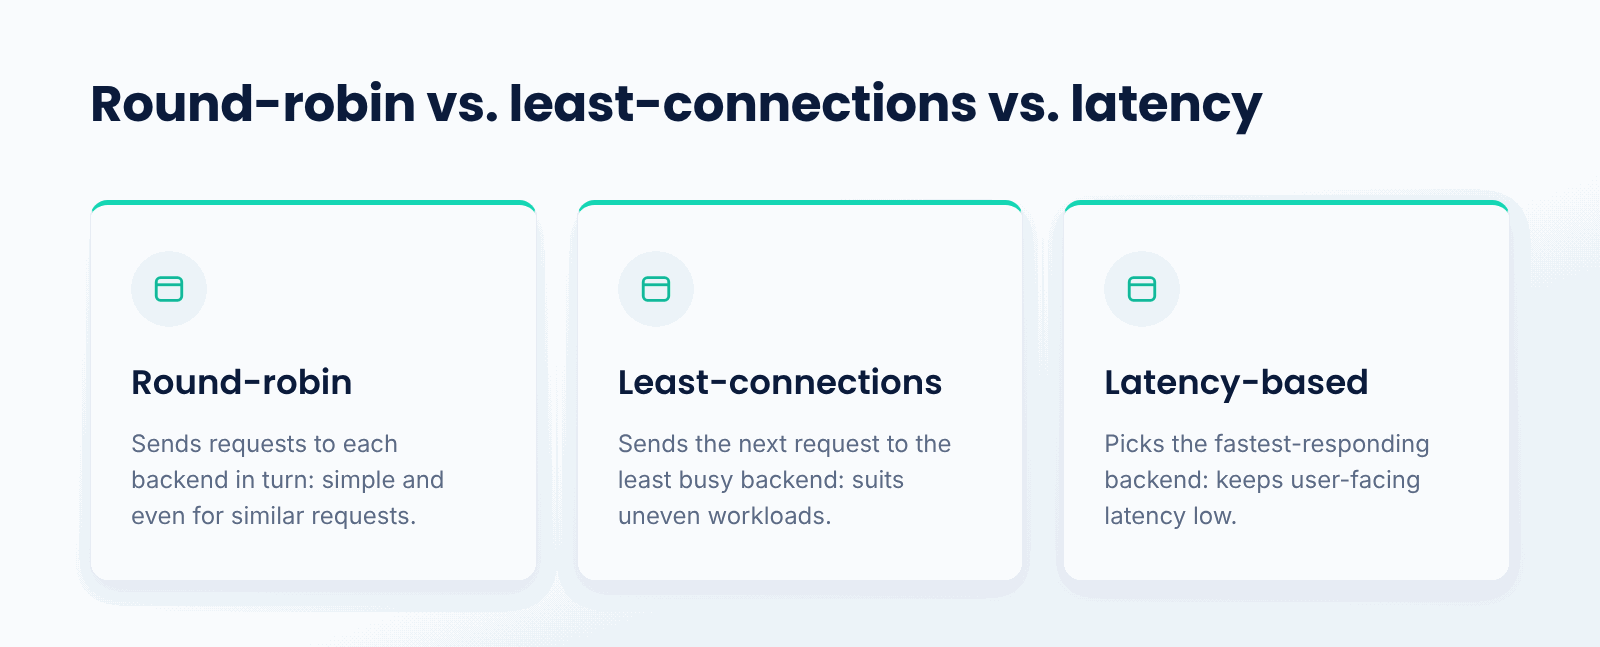
Balancers kiezen op een paar gangbare manieren backends. Round-robin stuurt verzoeken om de beurt naar elke backend; dit is eenvoudig en effectief wanneer verzoeken vergelijkbaar zijn. Least-connections stuurt het volgende verzoek naar de backend met de minste actieve verzoeken, wat goed werkt bij ongelijkmatige werklasten. Latency-based routing kiest de backend die het snelst reageert, wat de latentie voor de gebruiker laag houdt.
Welke methode geschikt is, hangt af van de werklast. Voor LLM-serving, waarbij verzoeken sterk variëren in omvang en kosten, zijn load- en latency-bewuste strategieën meestal beter dan standaard round-robin, omdat ze rekening houden met hoe druk elke replica daadwerkelijk is.
Waarom is load balancing belangrijk?
- Lagere latentie. Door de belasting te spreiden, voorkom je dat een individuele backend vertraagt.
- Hogere beschikbaarheid. Door verkeer om storingen heen te leiden, blijft de applicatie in de lucht.
- Betere doorvoer. De volledige capaciteit van de pool wordt benut, niet slechts die van één server.
- Schaalbaarheid.Het toevoegen van backends achter de balancer verhoogt de capaciteit op soepele wijze.
- Efficiënt GPU-gebruik. Voor LLM's zorgt het ervoor dat schaarse replica's gelijkmatig en volledig worden benut.
Wat zijn de uitdagingen?
- Ongelijke verzoeken. LLM-verzoeken variëren in kosten, waardoor eenvoudige balancing alsnog tot een scheve verdeling kan leiden.
- Gezondheidsdetectie. Het snel detecteren van een trage of falende backend is niet eenvoudig.
- Status. Sticky sessions of gedeelde status maken het ingewikkelder om te bepalen waar een verzoek naartoe kan.
- De balancer zelf. Deze moet hoog beschikbaar zijn, zodat het geen single point of failure vormt.
Wanneer heb je load balancing nodig?
Je hebt het nodig zodra één backend je verkeer niet betrouwbaar kan verwerken, wat geldt voor vrijwel elke productieservice met echte gebruikers. Voor LLM-applicaties die veel verzoeken afhandelen via meerdere replica's of modellen, is load balancing essentieel om de latentie en beschikbaarheid acceptabel te houden.
Een enkele service met weinig verkeer op één machine heeft het wellicht niet nodig. Maar zodra je meerdere backends draait voor capaciteit of betrouwbaarheid, is een load balancer wat ze samenvoegt tot één betrouwbaar eindpunt.
Best practices voor load balancing
- Gebruik health checks zodat verkeer trage of falende backends vermijdt.
- Kies een strategie die past bij je workload; load-aware voor variabele LLM-verzoeken.
- Maak de balancer zelf redundant zodat het geen single point of failure vormt.
- Houd bij het balanceren van LLM-verkeer rekening met de kosten van een verzoek, niet alleen het aantal.
- Combineer dit met autoscaling zodat de capaciteit meegroeit en -krimpt met de vraag.
- Balanceer voor LLM's over modellen en providers heen via een gateway.
Conclusie
Load balancing verdeelt verzoeken over meerdere backends zodat geen enkele backend overbelast raakt, wat de latentie laag en de beschikbaarheid hoog houdt. Door elk verzoek naar een gezonde, geschikte backend te routeren en fouten te vermijden, verandert het een groep servers of replica's in één snel, veerkrachtig eindpunt. Voor LLM-serving, waar verzoeken kostbaar zijn en replica's schaars, is slimme load balancing de sleutel tot betrouwbare dienstverlening op schaal.
De AI Gateway van TrueFoundry balanceert LLM-verkeer over replica's, modellen en providers, met ingebouwde health-bewaking en failover. Naarmate AI-applicaties groeien, is load balancing de manier waarop teams ze responsief en beschikbaar houden onder reëel verkeer.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is load balancing in simple terms?
It is distributing incoming requests among a number of servers to prevent any one of them from being overwhelmed. A load balancer sits at the front, selects a healthy backend for every request, and keeps the application fast and available.
What are the main load balancing strategies?
Round-robin distributes requests equally among all backends, least-connections directs traffic to the least busy backend, and latency-based routing chooses the quickest-responding one. Load-aware strategies are best for variable workloads like LLM requests.
How does load balancing improve availability?
By running health checks and passing requests only to backends that are up and responsive. If one fails, the balancer sends traffic to the others, so the application keeps working instead of going down with a single server.
Why does load balancing matter for LLMs?
Because LLM replicas are expensive and scarce, and requests vary in cost. Balancing keeps replicas evenly and fully used, avoids overloading any one, and can route across models and providers to balance speed, cost, and reliability.
How is load balancing related to autoscaling?
Load balancing distributes traffic among the backends you have; autoscaling changes how many backends there are. In combination they let an application both use its current capacity well and add or remove capacity as demand changes.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


