


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is een KV-cache en hoe werkt het?

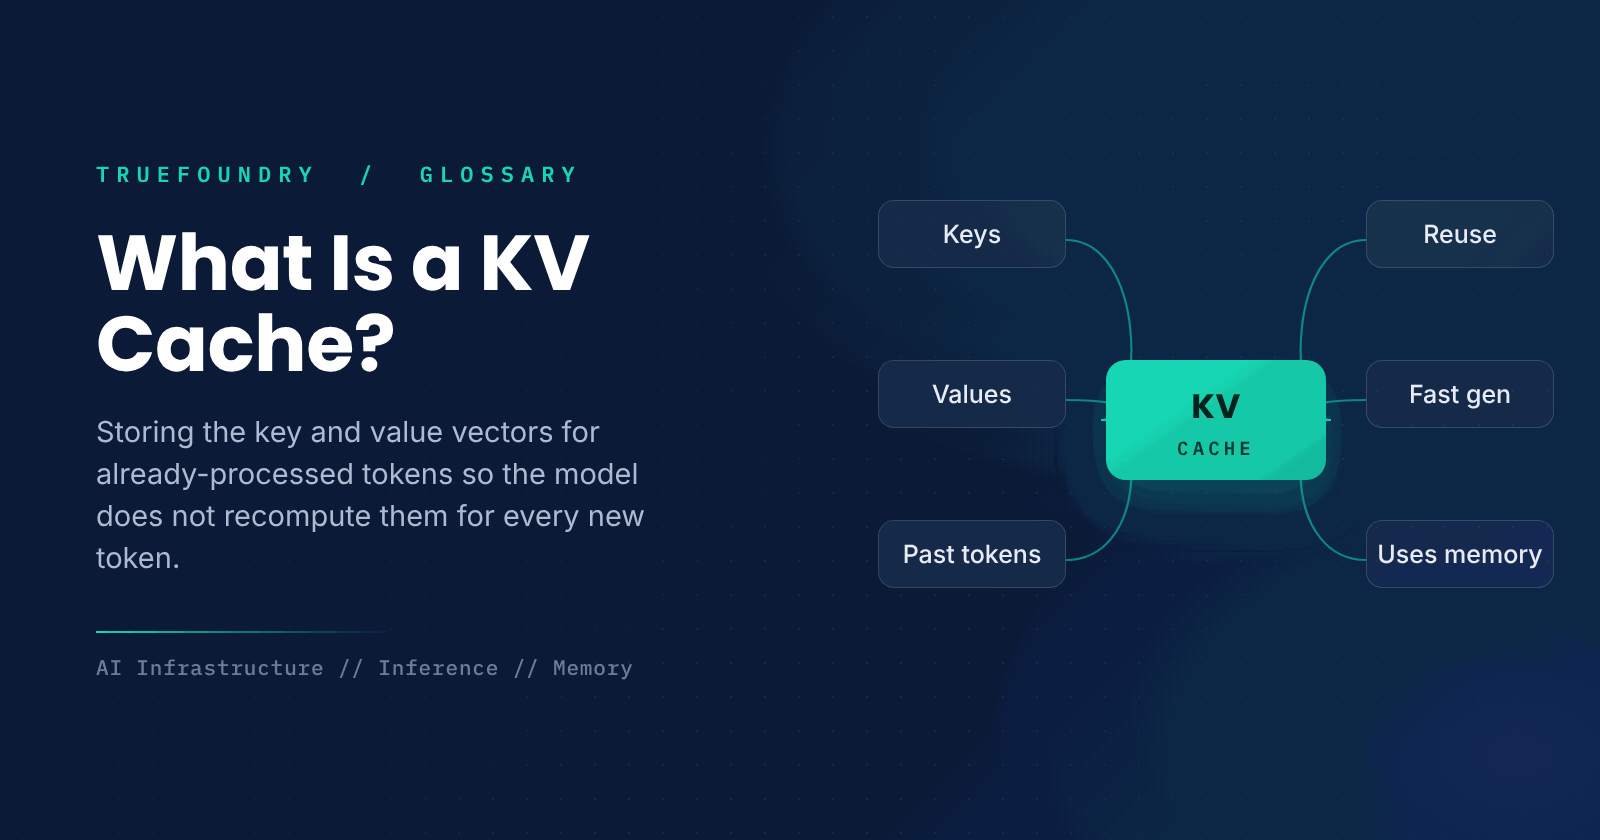
Wanneer een LLM tekst genereert, produceert het één token per keer, waarbij elk nieuw token aandacht besteedt aan alle voorgaande tokens. Als je dit naïef aanpakt, betekent dit dat de attention-keys en -values voor de gehele reeks bij elke stap opnieuw moeten worden berekend, wat al snel erg kostbaar wordt. De KV-cache voorkomt dit door de keys en values die al zijn berekend, te onthouden.
Door die vectoren op te slaan en te hergebruiken, hoeft het model bij elke stap alleen de key en value voor het nieuwste token te berekenen. Deze optimalisatie is precies wat interactieve LLM-generatie snel genoeg maakt voor praktisch gebruik, ten koste van het opslaan van de cache in het GPU-geheugen.
Deze gids legt uit wat een KV-cache is, hoe deze werkt, wat de kosten zijn en waarom het belangrijk is voor LLM-inferentie.
Wat is een KV-cache?
Een KV-cache, kort voor key-value cache, is een opslagplaats voor de key- en value-vectoren die de attention-layers van een transformer berekenen voor elk token in een reeks. Tijdens de generatie worden deze vectoren in het GPU-geheugen bewaard, zodat het model bij het produceren van het volgende token aandacht kan besteden aan alle voorgaande tokens zonder hun keys en values vanaf nul opnieuw te berekenen.
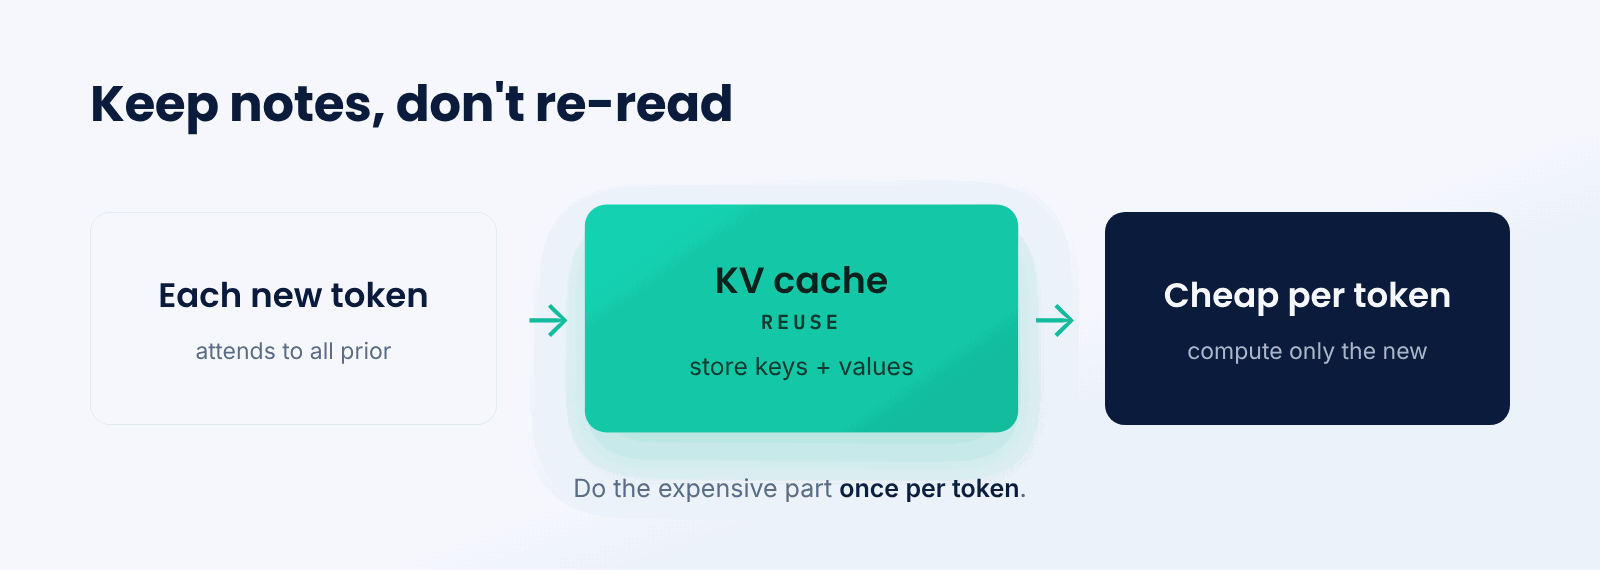
Zie het als het bijhouden van aantekeningen terwijl je een lang document leest. In plaats van alles opnieuw te lezen telkens wanneer je een zin toevoegt, kijk je even naar je aantekeningen en voeg je alleen het nieuwe deel toe. De KV-cache is het notitieblok van het model met wat het al heeft verwerkt, waardoor elk nieuw token goedkoop te genereren is.
Het kernidee is het hergebruik van de attention-status. Het dure gedeelte, het verwerken van de volledige voorgaande reeks, wordt één keer per token gedaan en opgeslagen, waardoor generatie veel beter schaalt dan alles bij elke stap opnieuw te berekenen.
Hoe werkt een KV-cache?
Voor elk nieuw token berekent het model alleen de bijbehorende key en value, voegt deze toe aan de cache en past attention toe over de cache.
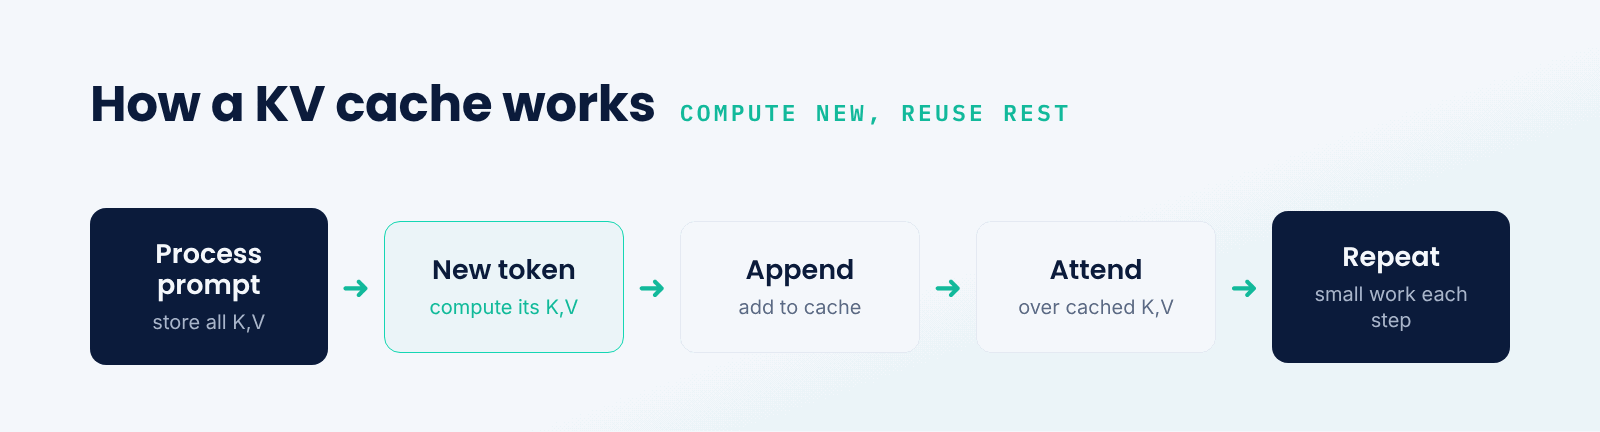
- Verwerk de prompt. Het model berekent keys en values voor alle prompt-tokens en slaat deze op.
- Genereer een token. Voor het nieuwe token berekent het alleen de key en value van dat specifieke token.
- Toevoegen aan cache. De nieuwe key en value worden toegevoegd aan de opgeslagen cache.
- Attention toepassen. Het token past attention toe over alle gecachte keys en values om output te genereren.
- Herhalen. Elke stap voegt één item toe en hergebruikt de rest, waardoor het werk per token beperkt blijft.
Omdat per stap alleen de key en value van één token worden berekend, blijven de kosten per gegenereerd token ongeveer constant in plaats van dat ze bij elke stap meegroeien met de volledige sequentie. Het nadeel is dat de cache geheugen in beslag neemt dat groeit naarmate de sequentie langer wordt.
Wat kost een KV-cache?
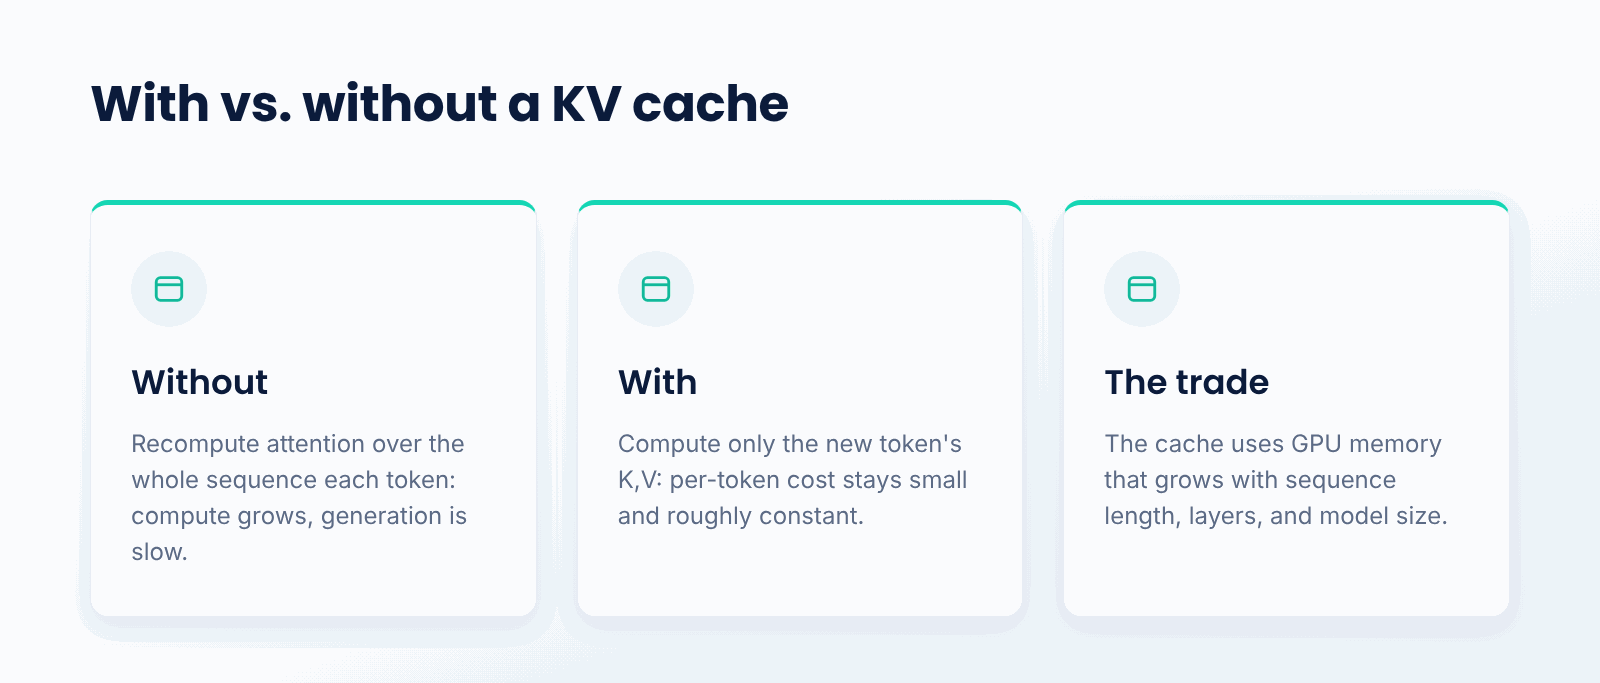
De KV-cache is een klassieke afweging tussen geheugen en rekenkracht. Zonder cache moet voor elk token de aandacht over de gehele sequentie opnieuw worden berekend, waardoor de rekenkracht per token toeneemt met de lengte en de generatie traag verloopt. Met cache blijft de rekenkracht per token laag, maar verbruikt de cache GPU-geheugen dat evenredig is aan de sequentielengte, het aantal lagen en de modelgrootte. Het beheer van dat geheugen is een centraal punt bij efficiënte serverimplementaties.
Dit is waarom lange contexten duur zijn: de KV-cache voor een zeer lange sequentie kan aanzienlijk GPU-geheugen in beslag nemen, wat beperkt hoeveel verzoeken er tegelijkertijd kunnen worden verwerkt. Technieken om de cache te comprimeren of te pagineren bestaan juist om deze druk te verlichten.
Waarom is de KV-cache belangrijk?
- Snelle generatie. Het zorgt ervoor dat de kosten per token ongeveer constant blijven in plaats van dat ze toenemen.
- Praktische interactiviteit. Zonder cache zouden streaming-antwoorden veel te traag zijn.
- Geheugendruk. De omvang ervan is een belangrijke beperkende factor voor de contextlengte en gelijktijdigheid.
- Ontwerp van serverinfrastructuur. Goed beheer hiervan is essentieel voor inferentie met een hoge doorvoer.
- Maakt batching mogelijk. Efficiënte cache-afhandeling vormt de basis voor continue batching.
Wat zijn de uitdagingen?
- Geheugengroei. Lange sequenties produceren grote caches die het GPU-geheugen zwaar belasten.
- Beperkingen in gelijktijdigheid. Veel gelijktijdige verzoeken vermenigvuldigen de totale cachegrootte.
- Fragmentatie. Naïeve toewijzing verspilt geheugen; paging-schema's helpen.
- Kosten van lange context. Zeer lange contexten kunnen de cache tot een knelpunt maken.
Wanneer is de KV-cache voor jou van belang?
Het is van belang zodra je autoregressieve LLM-generatie aanbiedt of uitvoert, wat in feite alle tekstgeneratie omvat. Iedereen die de inferentiesnelheid, contextlengte of het GPU-geheugengebruik optimaliseert, werkt direct of indirect met de KV-cache.
Bij een enkele korte generatie is het onzichtbaar en zorgt het simpelweg voor snelheid. Maar op schaal, met lange contexten en veel gelijktijdige verzoeken, wordt de KV-cache een primaire factor in kosten, doorvoer en de hoeveelheid context die je je kunt veroorloven.
Best practices voor de KV-cache
- Gebruik serving-engines met efficiënt KV-cachebeheer, zoals paging.
- Stem de contextlengte goed af om een balans te vinden tussen mogelijkheden en cachegeheugen.
- Monitor het GPU-geheugen om te zien hoeveel de cache verbruikt onder belasting.
- Geef de voorkeur aan engines die KV-caching combineren met continue batchverwerking.
- Overweeg cache-compressietechnieken voor zeer lange contexten.
- Plan limieten voor gelijktijdigheid met het totale cachegeheugen in gedachten.
Conclusie
Een KV-cache slaat de key- en value-vectoren op voor tokens die al zijn verwerkt, zodat het model niet bij elke stap de aandacht over de hele reeks opnieuw hoeft te berekenen. Het maakt autoregressieve generatie snel door de kosten per token ongeveer constant te houden, in ruil voor GPU-geheugen dat meegroeit met de lengte van de reeks. Dat geheugen is een centrale beperking voor contextlengte en gelijktijdigheid, en daarom is het goed beheren van de KV-cache essentieel voor efficiënte LLM-serving.
TrueFoundry helpt teams bij het aanbieden van modellen met engines die de KV-cache efficiënt beheren op hun eigen infrastructuur, waarbij GPU-geheugen en doorvoer op één plek inzichtelijk zijn. Naarmate contexten langer worden, is het goed omgaan met de KV-cache de sleutel om ze betaalbaar te houden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is a KV cache in simple terms?
It is the model's memory of the key and value vectors it already computed for earlier tokens. By reusing them, the model computes only the newest token's vectors each step, which makes generating text one token at a time fast.
Why does a KV cache speed up generation?
Because without it, the model would recompute attention over the entire sequence for every new token, and that cost grows with length. The cache keeps those vectors, so per-token work stays small and roughly constant instead.
What does the KV cache cost?
GPU memory. The cache holds key and value vectors for every token and every layer, so its size grows with sequence length and model size. That memory limits how long a context can be and how many requests can run at once.
Why are long contexts expensive?
Largely because of the KV cache. A long sequence produces a large cache that consumes significant GPU memory, which limits concurrency and can become the bottleneck, so very long contexts cost more to serve.
How is the KV cache related to continuous batching?
Continuous batching serves many requests at once, and each needs its own KV cache. Efficient cache management, including paging to avoid waste, is what lets a serving engine fit many concurrent requests and keep the GPU busy.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


