


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Instruction Tuning en waarom is het belangrijk?

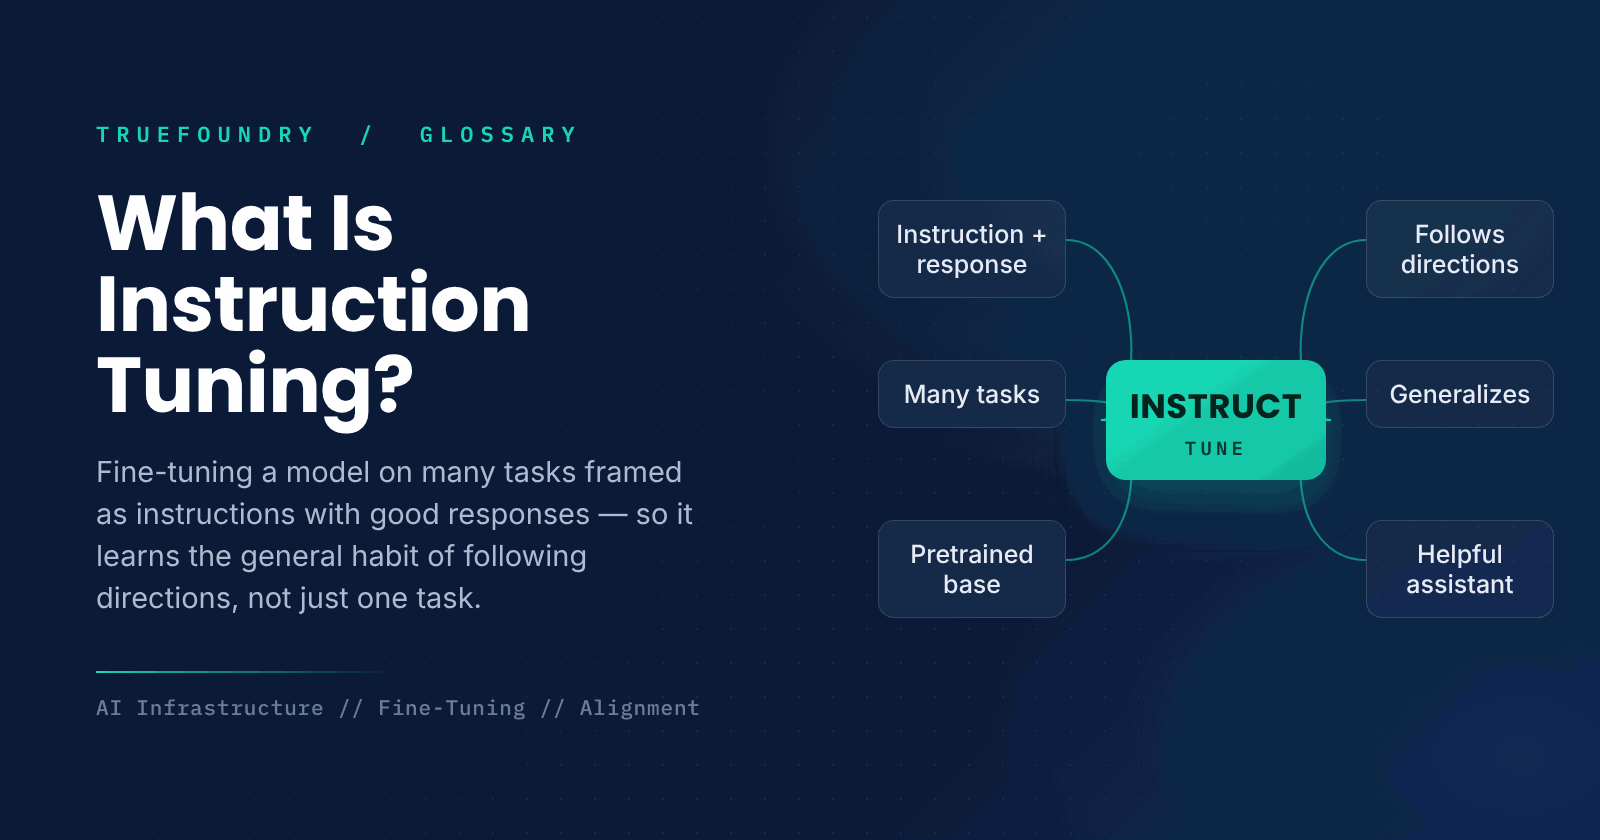
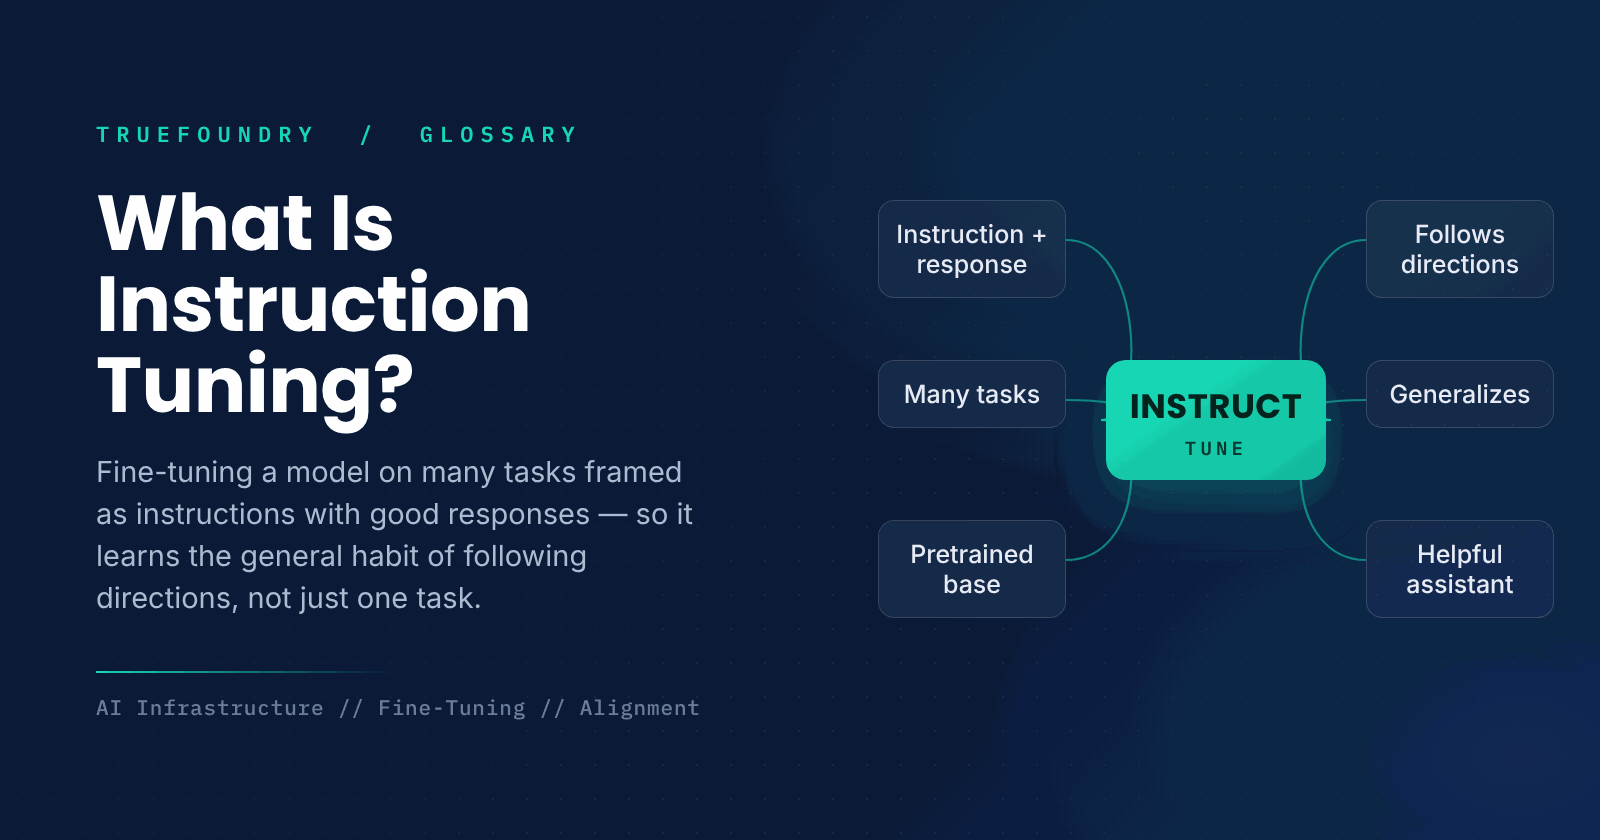
Een voorgetraind taalmodel kan tekst aanvullen, maar doet niet uit zichzelf wat je vraagt. Als je het een instructie geeft, kan het antwoorden, maar het kan de instructie ook simpelweg voortzetten alsof het onderdeel is van een document. Instruction tuning lost dit op door het model aan de hand van vele voorbeelden te leren dat een instructie iets is wat moet worden uitgevoerd.
Het verschil met reguliere fine-tuning is de breedte. In plaats van te trainen op één taak, gebruikt instruction tuning een diverse mix van taken die allemaal zijn geformuleerd als instructies met goede antwoorden, zodat het model de algemene gewoonte aanleert om aanwijzingen op te volgen. Dit is een cruciale stap in het transformeren van een ruw model naar een behulpzame assistent. Deze gids legt uit wat het is en hoe het werkt.
We behandelen de definitie, het proces, de relatie tot fine-tuning en preference tuning, en wanneer je het moet gebruiken.
Wat is instruction tuning?
Instruction tuning is een vorm van supervised fine-tuning waarbij een taalmodel wordt getraind op een brede verzameling voorbeelden, die elk bestaan uit een instructie en een kwalitatief hoogwaardig antwoord. Door te leren van veel verschillende instructies voor uiteenlopende taken, leert het model om in het algemeen instructies op te volgen, in plaats van één specifieke taak in isolatie te beheersen.
Zie het als het trainen van een nieuwe medewerker om aanwijzingen op te volgen in plaats van één specifieke taak uit te voeren. Als je hen slechts één taak zou laten zien, zouden ze alleen die taak leren. Door hen door vele soorten verzoeken te leiden, leren ze de algemene vaardigheid om instructies te begrijpen en ernaar te handelen, wat ook toepasbaar is op verzoeken die ze nog nooit eerder hebben gezien.
Het kernidee is generalisatie door diversiteit. Omdat de training vele taken omvat die als instructies zijn geformuleerd, leert het model het onderliggende patroon van instructie-opvolging en past dit toe op nieuwe instructies tijdens de inferentiefase.
Hoe werkt instruction tuning?
Instruction tuning verfijnt het model op een diverse set van instructie-antwoordparen.
- Verzamel taken. Verzamel veel taken die zijn geformuleerd als instructies met goede antwoorden.
- Mix breed. Combineer diverse instructies zodat geen enkele taak de overhand krijgt.
- Begin bij de basis.Start met een vooraf getraind model.
- Fine-tune. Train het model om het antwoord te genereren voor elke instructie.
- Generaliseer. Het model leert nieuwe instructies op te volgen die het nog niet eerder heeft gezien.
Technisch gezien is dit supervised fine-tuning, maar de dataset is bewust breed en instructiegericht. De diversiteit is wat telt: door vele soorten instructies te zien, leert het model het algemene gedrag van het opvolgen van aanwijzingen. Daarom kunnen modellen die met instruction tuning zijn getraind, verzoeken afhandelen die ver buiten hun trainingsvoorbeelden vallen.
Instruction tuning versus fine-tuning versus preference tuning
Taakspecifieke fine-tuning traint een model om één taak goed uit te voeren, met behulp van voorbeelden van die specifieke taak. Instruction tuning is een brede vorm van fine-tuning die gebruikmaakt van vele taken die als instructies zijn geformuleerd, zodat het model leert om in het algemeen instructies op te volgen in plaats van zich in één taak te specialiseren. Dit is de stap die een model breed inzetbaar en behulpzaam maakt.
Preference tuning, zoals RLHF of DPO, komt meestal na instruction tuning. Het verfijnt het model op basis van de antwoorden die mensen verkiezen, waardoor de toon, behulpzaamheid en veiligheid worden verbeterd. Instruction tuning leert het model om aanwijzingen op te volgen; preference tuning polijst hoe goed het dit doet in lijn met menselijke voorkeuren.
Waarom is instruction tuning belangrijk?
- Bruikbaarheid. Het verandert een ruw model in een model dat instructies opvolgt.
- Generalisatie. Het helpt het model om instructies te verwerken die het nog niet eerder heeft gezien.
- Breedte. Eén getuned model kan vele soorten taken aan.
- Basis.Het vormt de basis voor latere preference tuning.
- Behulpzaamheid. Het zorgt ervoor dat modellen zich gedragen als nuttige assistenten.
Wat zijn de uitdagingen?
- Datadiversiteit. Het vereist een brede, kwalitatief hoogwaardige mix van instructies.
- Kwaliteit.Slechte antwoorden leiden tot slecht instructie-opvolgend gedrag.
- Balans.Het oververtegenwoordigen van bepaalde taken vertekent het model.
- Geen alignment. Het leert op zichzelf het opvolgen van instructies, niet het volgen van menselijke voorkeuren.
Wanneer moet je instruction tuning gebruiken?
Gebruik instruction tuning wanneer je een model wilt dat instructies voor uiteenlopende taken opvolgt, in plaats van een model dat slechts één taak uitvoert. Dit is de standaardstap voor het bouwen van een algemene assistent op basis van een voorgetraind model, en het is wat modellen die instructies opvolgen hun brede inzetbaarheid geeft.
Als je een model slechts voor één specifieke taak nodig hebt, kan taakspecifieke fine-tuning eenvoudiger en effectiever zijn. Maar voor breed inzetbaar gedrag waarbij instructies worden opgevolgd, is instruction tuning de methode die je nodig hebt, vaak gevolgd door preference tuning voor verdere verfijning.
Belangrijke punten over instruction tuning
- Instruction tuning traint een model om in het algemeen instructies op te volgen.
- Het model wordt gefinetuned op vele diverse paren van instructies en antwoorden.
- Diversiteit is de drijvende kracht achter het generaliseren naar nieuwe instructies.
- Het verandert een ruw model in een behulpzame assistent.
- Het gaat meestal vooraf aan preference tuning zoals RLHF of DPO.
- Het is ideaal voor het bouwen van een algemene assistent die instructies opvolgt.
Conclusie
Instruction tuning finetunet een taalmodel op vele taken die zijn geformuleerd als instructies met goede antwoorden, waardoor het model de algemene gewoonte aanleert om aanwijzingen op te volgen in plaats van slechts één specifieke taak uit te voeren. De diversiteit van de training zorgt ervoor dat het model kan generaliseren naar nieuwe instructies, en dit is de stap die een ruw model verandert in een behulpzame assistent die instructies opvolgt. Het gaat meestal vooraf aan preference tuning voor verdere verfijning.
TrueFoundry helpt teams bij het finetunen en serveren van modellen op hun eigen infrastructuur, inclusief instruction tuning die basismodellen breed inzetbaar maakt. Wanneer je een model nodig hebt dat betrouwbaar aanwijzingen opvolgt voor vele taken, is instruction tuning de bron van dat gedrag.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is instruction tuning in simple terms?
It entails training a language model on many examples of instructions and their good responses, so it learns to follow instructions in general. Rather than training it to perform any particular task, it teaches the habit of following directions, which turns a raw model into a helpful assistant.
How is instruction tuning different from regular fine-tuning?
In regular fine-tuning, the model is trained on one particular task. Instruction tuning, on the other hand, is a more generalized method of fine-tuning that uses numerous tasks framed as instructions, so the model learns to follow instructions in general rather than specialize in a single task.
How is instruction tuning different from RLHF?
Instruction tuning trains the model to follow directions using examples of instructions and their good responses. RLHF and other preference tuning come later, refining the model toward which answers people prefer. One teaches following; the other polishes how well it is done.
Why does diversity matter in instruction tuning?
Because the model generalizes from the diversity it observes. Training on many kinds of instructions teaches the underlying skill of following directions, so the model can handle instructions it was never shown. A narrow dataset would only teach a narrow set of behaviors.
When should I use instruction tuning?
When you want a model that follows instructions across a wide range of tasks, like a general-purpose assistant. If you only need one narrow task, task-specific fine-tuning may be simpler. For broad instruction-following, instruction tuning is the standard approach.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


