


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is GraphRAG en waarom is het belangrijk?

Standaard retrieval-augmented generation werkt door documenten op te splitsen in fragmenten, deze te embedden en de fragmenten op te halen die het meest lijken op een zoekopdracht. Dat werkt goed voor vragen die met één passage beantwoord kunnen worden, maar het schiet tekort wanneer een antwoord vereist dat feiten uit verschillende documenten met elkaar worden verbonden. GraphRAG is ontwikkeld om dat gat te dichten.
In plaats van kennis te behandelen als een verzameling onafhankelijke fragmenten, structureert GraphRAG deze als een graaf: entiteiten zoals personen, producten of concepten, verbonden door de relaties tussen hen. Door over deze structuur te zoeken, kan het systeem verbindingen volgen, waardoor het veel beter is in het beantwoorden van vragen die meerdere feiten beslaan of een breed overzicht van een corpus vereisen.
Deze gids legt uit wat GraphRAG is, hoe het werkt, hoe het zich verhoudt tot standaard RAG en wanneer de toegevoegde structuur de moeite waard is.
Wat is GraphRAG?
GraphRAG is retrieval-augmented generation gebouwd op een kennisgraaf. In plaats van geïsoleerde tekstfragmenten op te halen, haalt het entiteiten en relaties op uit een graaf die is opgebouwd uit de brongegevens. Het taalmodel genereert vervolgens een antwoord met behulp van deze verbonden, gestructureerde context, die vastlegt hoe stukjes informatie zich tot elkaar verhouden.
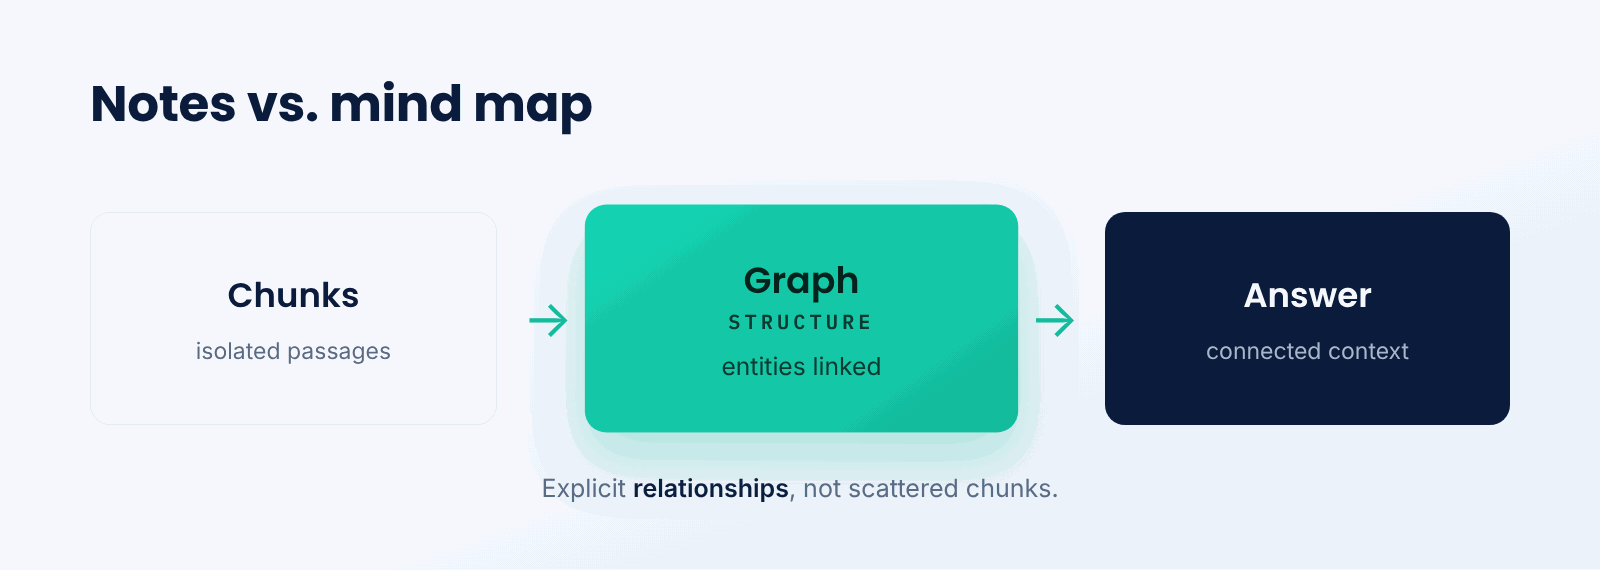
Denk aan het verschil tussen een stapel losse notities en een mindmap. Met losse notities kun je snel één relevante notitie vinden, maar voor het beantwoorden van een vraag die over meerdere notities gaat, moet je door de hele stapel spitten. Een mindmap laat zien hoe ideeën met elkaar verbonden zijn, zodat je relaties direct kunt volgen. GraphRAG geeft het model die mindmap.
Het kernidee is gestructureerde, verbonden context. Door relaties expliciet te coderen, stelt GraphRAG het ophaalproces in staat om links tussen feiten te volgen, wat antwoorden mogelijk maakt waarvoor informatie uit vele bronnen moet worden gecombineerd.
Hoe werkt GraphRAG?
GraphRAG bouwt eerst een kennisgraaf op basis van de gegevens en voert vervolgens op het moment van de zoekopdracht een zoekactie uit over die graaf.
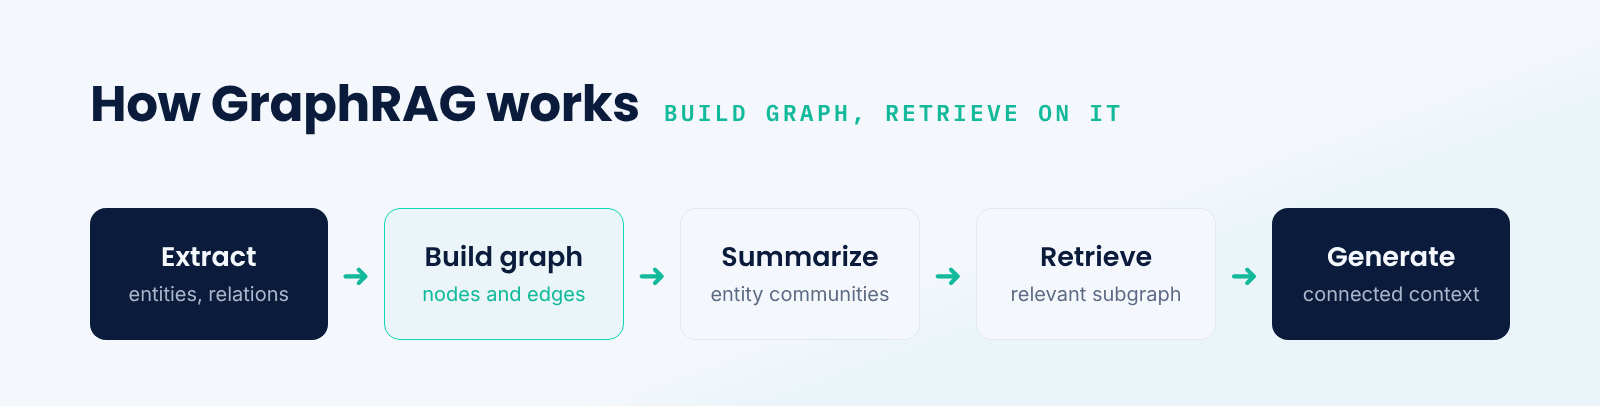
- Entiteiten extraheren. Een model identificeert entiteiten en relaties in de brondocumenten.
- De graaf opbouwen. Die entiteiten en relaties worden knooppunten en verbindingen.
- Gemeenschappen samenvatten. Clusters van gerelateerde entiteiten kunnen worden samengevat voor brede vragen.
- Zoeken bij een query. Relevante entiteiten, relaties of samenvattingen worden opgehaald voor de zoekopdracht.
- Genereren.Het model beantwoordt de vraag met behulp van de verbonden graafcontext.
Het bouwen van de graaf is extra werk vooraf, meestal uitgevoerd met een taalmodel om structuur uit tekst te extraheren. Maar eenmaal gebouwd, ondersteunt de graaf zowel specifieke multi-hop zoekopdrachten, door relaties te doorlopen, als brede globale zoekopdrachten, door gebruik te maken van samenvattingen van gemeenschappen die grote delen van het corpus beschrijven.
GraphRAG versus standaard RAG
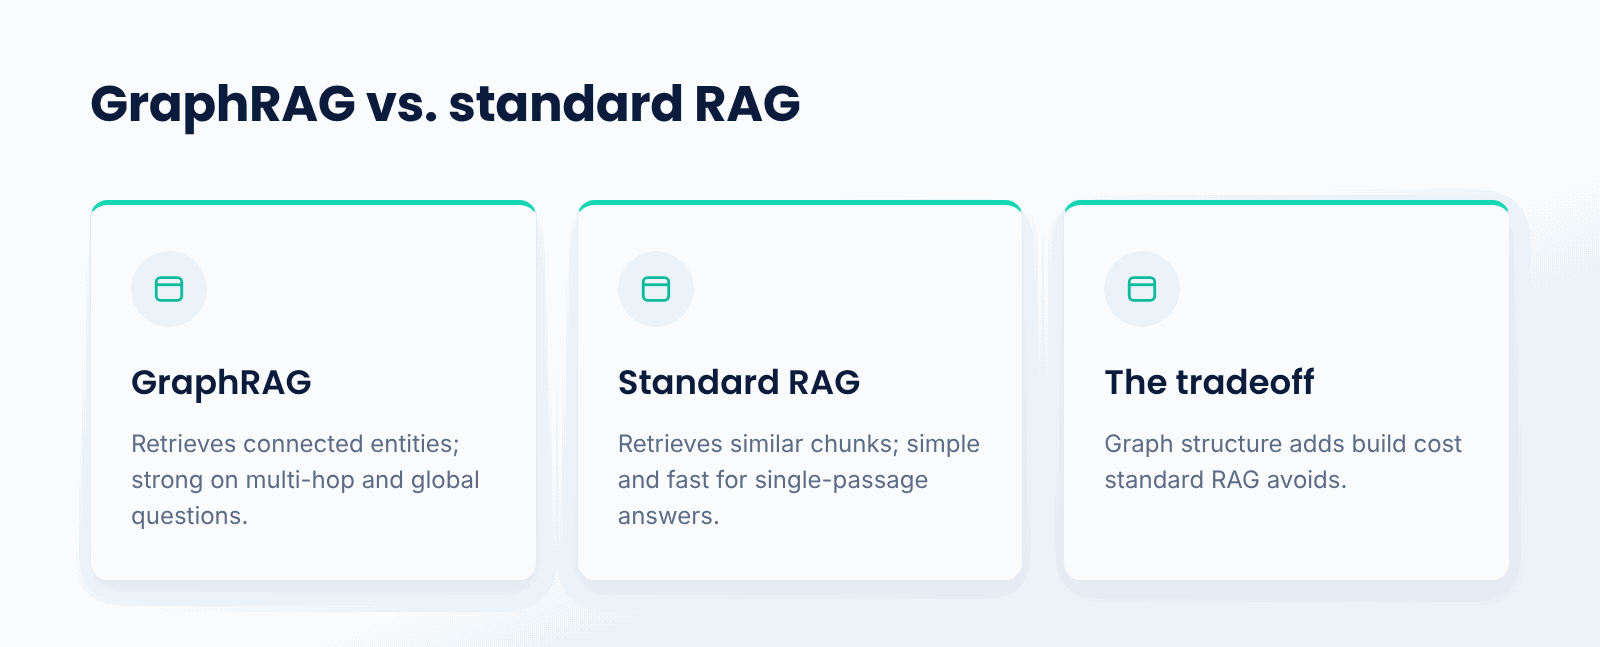
Standaard RAG haalt tekstfragmenten op basis van gelijkenis op; dit is eenvoudig, snel en effectief voor vragen die met één passage beantwoord kunnen worden. Het heeft echter moeite met vragen waarvoor veel feiten met elkaar verbonden moeten worden of waarbij een hele dataset samengevat moet worden, omdat zoekopdrachten op basis van gelijkenis alleen geïsoleerde stukjes informatie opleveren. GraphRAG voegt structuur toe die deze verbanden expliciet maakt.
De keerzijde is de kosten en complexiteit. GraphRAG vereist een stap voor het opbouwen van een graaf en meer infrastructuur, wat bij standaard RAG niet nodig is. Daarom blijft standaard RAG de juiste keuze voor eenvoudige zoekopdrachten, terwijl GraphRAG zijn waarde bewijst bij complexe redeneringen en algemene vragen over een grote hoeveelheid kennis.
Waarom is GraphRAG belangrijk?
- Antwoorden met meerdere stappen. Het verbindt feiten uit talloze documenten met elkaar.
- Algemene vragen. Samenvattingen van groepen informatie beantwoorden vragen over de gehele dataset.
- Structuur.Expliciete relaties leggen vast hoe informatie met elkaar samenhangt.
- Minder hiaten. Het vermindert de beperking van geïsoleerde tekstfragmenten bij standaard RAG.
- Rijkere context. Het model redeneert op basis van verbonden informatie in plaats van versnipperde gegevens.
Wat zijn de afwegingen?
- Opbouwkosten. Het construeren van de graaf vereist extra rekenkracht en verwerkingstijd.
- Complexiteit.Het voegt graaf-infrastructuur toe aan de pipeline.
- Onderhoud.De graaf moet worden bijgewerkt wanneer de brongegevens veranderen.
- Overbodig voor eenvoudige gevallen. Vragen die met één passage beantwoord kunnen worden, hebben dit niet nodig.
Wanneer moet je GraphRAG gebruiken?
Kies voor GraphRAG wanneer antwoorden informatie uit vele documenten moeten combineren, wanneer je antwoorden op corpusniveau of samenvattende antwoorden nodig hebt, of wanneer de relaties tussen entiteiten centraal staan in de gestelde vragen. Dit zijn precies de gevallen waarin RAG op basis van tekstfragmenten vaak tekortschiet.
Voor eenvoudige vraag-antwoordscenario's waarbij elk antwoord in één passage te vinden is, is standaard RAG eenvoudiger en meestal voldoende. De structuur van GraphRAG werpt zijn vruchten af wanneer het redeneren meerdere feiten omvat, dus stem de aanpak af op het soort vragen dat je verwacht.
Belangrijke punten over GraphRAG
- Het is RAG gebouwd op een kennisgraaf.
- Het representeert data als entiteiten en relaties.
- Het beantwoordt multi-hop en globale vragen uitstekend.
- Het vereist vooraf een stap voor het opbouwen van de graaf.
- Standaard RAG blijft beter voor eenvoudige opzoekacties in losse passages.
- Stem het af op vragen die vele onderling verbonden feiten beslaan.
Conclusie
GraphRAG verrijkt retrieval-augmented generation met een kennisgraaf, waarbij informatie wordt weergegeven als verbonden entiteiten en relaties in plaats van als geïsoleerde fragmenten. Hierdoor kan het multi-hop en corpusbrede vragen beantwoorden waar standaard RAG moeite mee heeft, ten koste van het opbouwen en onderhouden van de graaf. Wanneer vragen het verbinden van feiten uit vele bronnen vereisen, is de structuur van GraphRAG een krachtig voordeel.
TrueFoundry helpt teams bij het bouwen en aanbieden van geavanceerde RAG-pipelines op hun eigen infrastructuur, inclusief graafgebaseerde retrieval wanneer vragen daarom vragen. Voor kennis die diep met elkaar verweven is, kan GraphRAG antwoorden ontsluiten die met retrieval op basis van tekstfragmenten niet bereikbaar zijn.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is GraphRAG in simple terms?
This is retrieval-augmented generation in which a knowledge graph containing information about entities and the relationships among them is used rather than isolated text snippets. This enables the system to connect information across facts and answer queries that span many documents.
How is GraphRAG different from standard RAG?
Standard RAG retrieves text snippets by similarity, which works well for single-passage answers, while GraphRAG retrieves entities and relationships from a graph, making links explicit and handling multi-hop and corpus-wide questions that chunk-based retrieval often misses.
What kinds of questions does GraphRAG handle better?
Multi-hop questions that involve integrating facts from multiple documents, and global questions that need summaries of an entire collection. Since the graph captures the links between entities, the system can traverse and summarize connections rather than relying on isolated fragments.
What is the main cost of GraphRAG?
Creation and management of the knowledge graph. Creating the entities and their relations requires additional computing resources that typically use language models, and the graph must be adjusted in line with data changes, which regular chunk-based RAG does not require.
When should I just use standard RAG?
Where your queries can be answered by a single passage and you don't have to connect lots of facts together. Normal RAG is less complex, easier to set up, and generally good enough for straightforward lookup, so GraphRAG's extra structure is not needed there.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


