


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is een GPU-cluster en hoe werkt het?

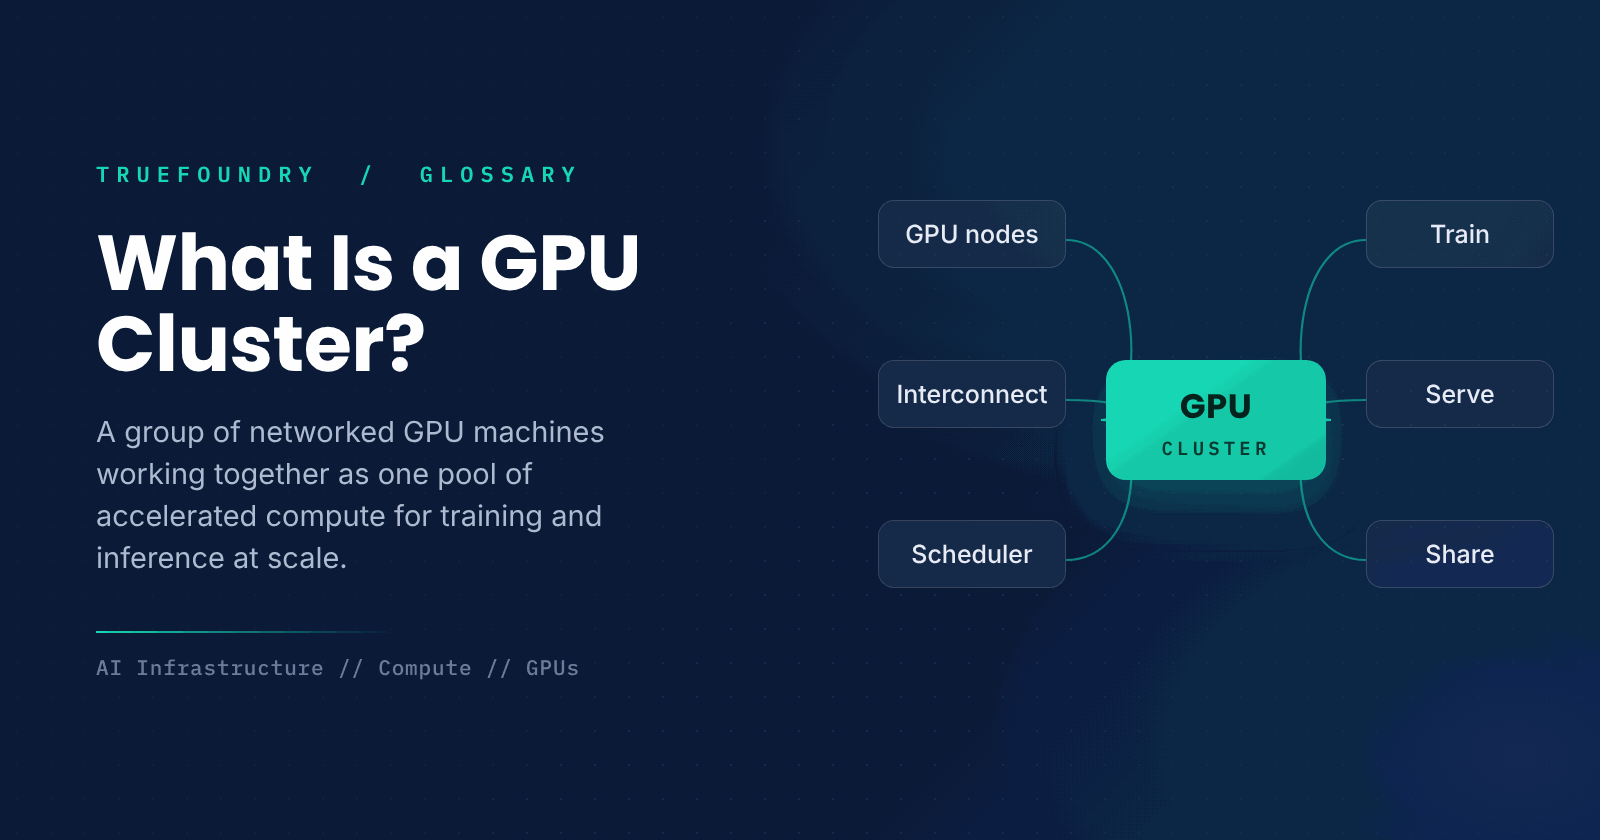
Het trainen van een groot model of het aanbieden van AI aan veel gebruikers vereist veel meer rekenkracht dan één GPU kan leveren. Een GPU-cluster voorziet in die behoefte door vele GPU's over talloze machines te bundelen tot één systeem waar taken gebruik van kunnen maken. Het is de machinekamer van moderne AI, waar het zware rekenwerk daadwerkelijk plaatsvindt.
Maar een cluster is meer dan een verzameling GPU's. Wat het laat werken is het netwerk dat GPU's in staat stelt samen te werken aan één taak, en de planning die de pool eerlijk verdeelt over vele taken en gebruikers. Doe je dit goed, dan is het cluster krachtig en efficiënt; doe je dit fout, dan blijven dure GPU's onbenut.
Deze gids legt uit wat een GPU-cluster is, hoe het werkt, waarvoor het wordt gebruikt en waarom efficiënt gebruik belangrijk is.
Wat is een GPU-cluster?
Een GPU-cluster is een verzameling onderling verbonden computers, nodes genoemd, die elk zijn uitgerust met een of meer grafische verwerkingseenheden en samen worden beheerd als een uniforme pool voor versnelde rekenkracht. De nodes zijn gekoppeld via een hogesnelheidsnetwerk en worden aangestuurd door een scheduler, zodat grote workloads over vele GPU's tegelijk kunnen draaien.
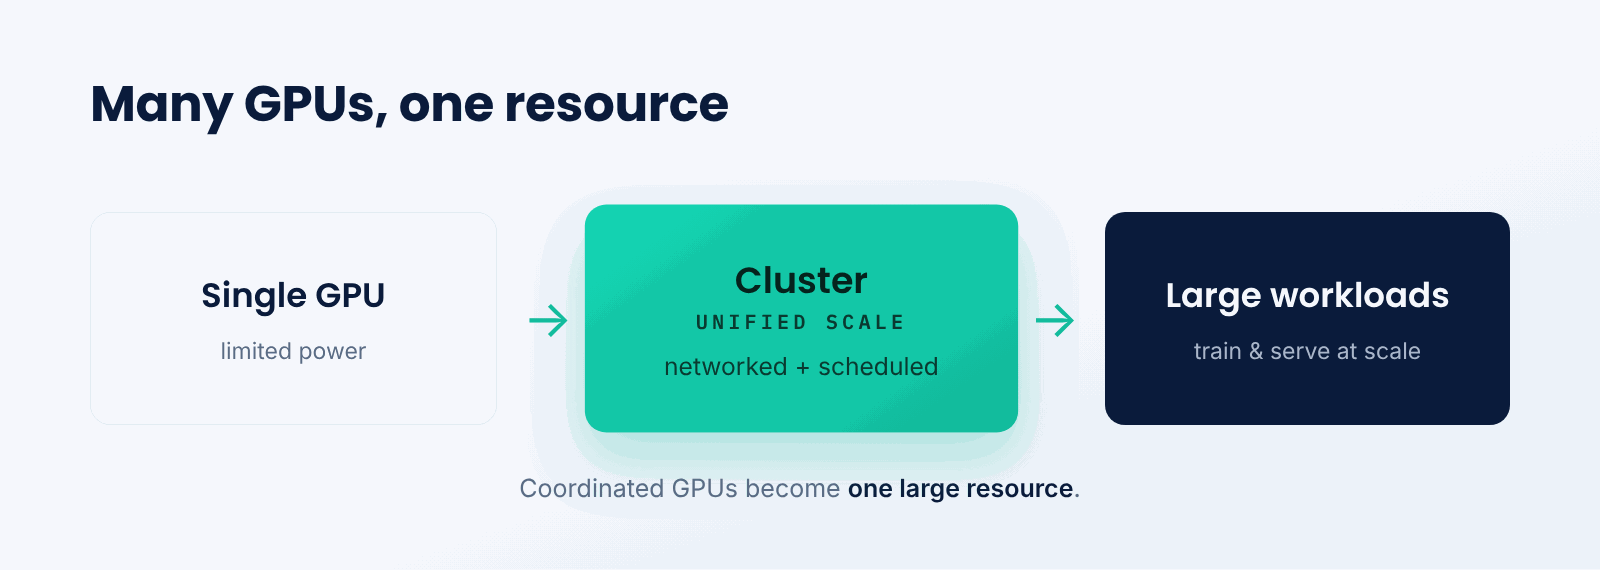
Zie het als een grote keuken met veel koks. Eén kok kan één gerecht bereiden; een gecoördineerd team kan een banket produceren, zolang ze ingrediënten en ruimte goed delen. Een GPU-cluster is dat team voor rekenwerk, met vele GPU's die samenwerken onder een systeem dat hen gecoördineerd houdt.
Het kernidee is uniforme schaalbaarheid. Individueel zijn GPU's krachtig; verbonden en gecoördineerd worden ze één enkele bron die groot genoeg is om enorme modellen te trainen en AI op grote schaal aan te bieden.
Hoe werkt een GPU-cluster?
Een cluster combineert GPU-nodes, snel netwerkverkeer en een scheduler om taken over de pool uit te voeren.
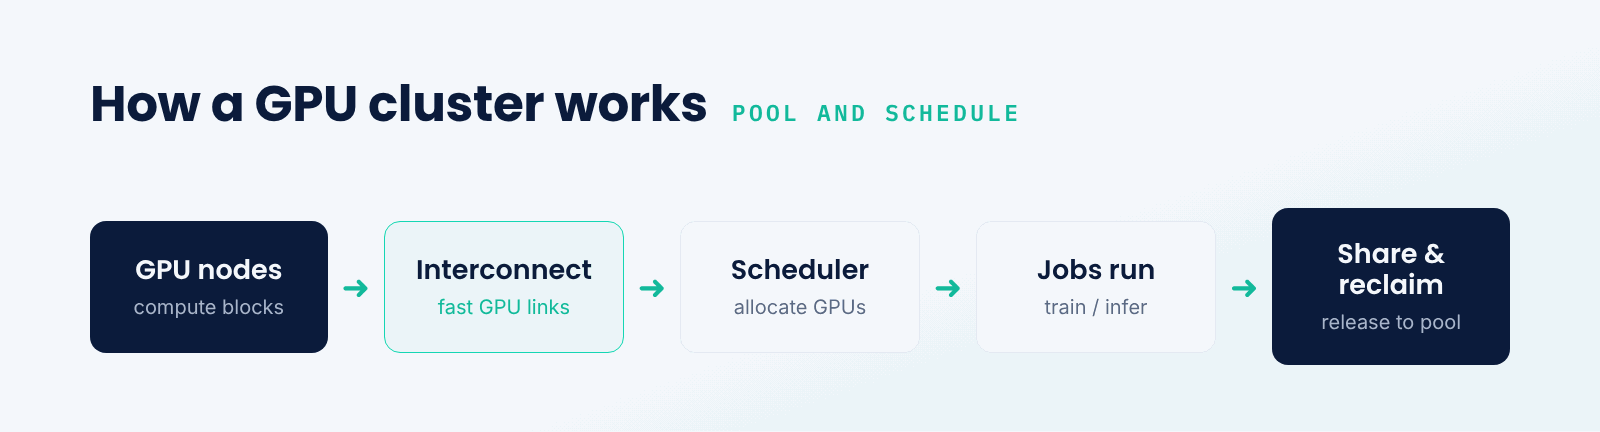
- Nodes met GPU's. Elke machine bevat een of meer GPU's, de bouwstenen voor rekenkracht.
- Snelle interconnect. Hogesnelheidsnetwerken verbinden GPU's zodat ze werk en data kunnen delen.
- Scheduler. Een systeem zoals Kubernetes of Slurm wijst GPU's toe aan taken en gebruikers.
- Taken uitvoeren. Workloads voor training of inferentie worden op beschikbare GPU's geplaatst.
- Delen en vrijgeven. Voltooide taken geven GPU's weer vrij aan de pool voor anderen.
De interconnect is wat een echt cluster onderscheidt van losse machines. Voor grote trainingsopdrachten moeten GPU's constant gegevens uitwisselen, dus snelle verbindingen zoals NVLink of InfiniBand zijn essentieel om te voorkomen dat ze op elkaar moeten wachten.
Waar wordt een GPU-cluster voor gebruikt?
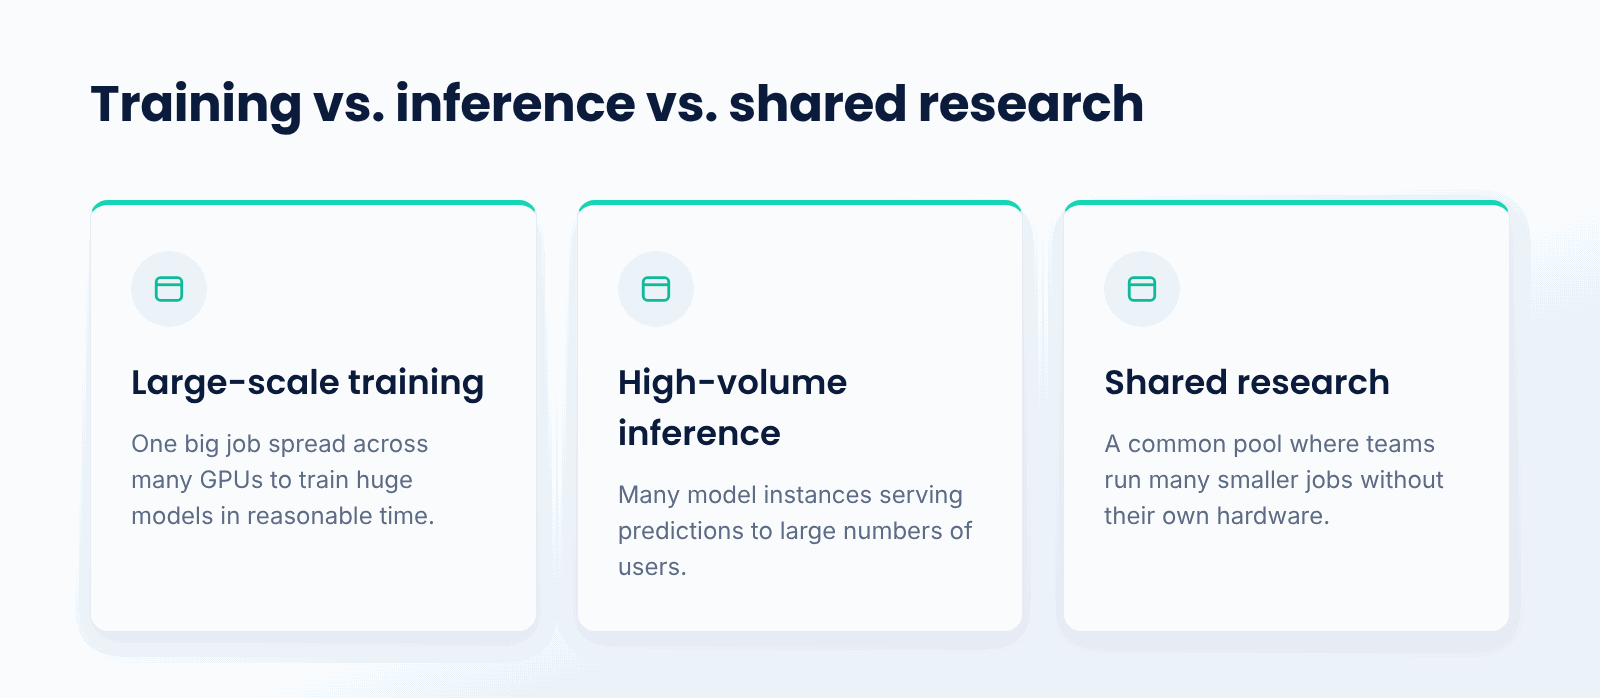
Clusters worden ingezet voor een aantal belangrijke workloads. Grootschalige training verdeelt één grote trainingsopdracht over vele GPU's, zodat enorme modellen binnen een redelijke tijd getraind kunnen worden. High-volume inference voert veel modelinstanties uit om voorspellingen te leveren aan grote aantallen gebruikers. Gedeeld onderzoek en experimenten bieden teams een gemeenschappelijke pool om veel kleinere taken uit te voeren zonder dat iedereen eigen hardware hoeft aan te schaffen.
Wat deze toepassingen gemeen hebben, is de behoefte aan meer GPU-kracht dan één machine kan bieden, toegepast op ofwel één enorme taak of op vele taken tegelijk. Het cluster en de bijbehorende scheduler maken beide mogelijk vanuit dezelfde pool.
Waarom is efficiënt gebruik van een GPU-cluster belangrijk?
- Hoge kosten. GPU's zijn duur, dus inactieve GPU's kosten veel geld.
- Schaarste. Het aanbod van GPU's is beperkt, waardoor efficiënt delen belangrijk is.
- Doorvoer. Goede planning betekent meer werk per GPU.
- Eerlijkheid.Het goed delen van de pool houdt veel teams productief.
- Schaalbaarheid.Een efficiënt cluster kan meer werk aan zonder extra hardware.
Wat zijn de uitdagingen?
- Benutting. GPU's bezet houden in plaats van inactief laten is verrassend lastig.
- Planning. Het eerlijk en efficiënt toewijzen van GPU's aan taken is complex.
- Netwerken. Knelpunten in de interconnect kunnen grote gedistribueerde taken beperken.
- Kostenbeheer. Zonder controle lopen de kosten voor clusters snel op.
Wanneer heb je een GPU-cluster nodig?
Je hebt er een nodig wanneer je AI-werkzaamheden de capaciteit van een enkele GPU of machine overstijgen, of het nu gaat om het trainen van grote modellen, het verwerken van een hoog volume aan inferentie, of het ondersteunen van veel gebruikers die elk GPU's nodig hebben. Hoe groter en gelijktijdiger de workloads, hoe noodzakelijker een cluster wordt.
Een enkel experiment of lichte inferentie kan op één GPU draaien. Maar voor het schalen van training of serving, of het delen van GPU's binnen een team, is een cluster met bijbehorende netwerken en scheduling essentieel.
Best practices voor GPU-clusters
- Gebruik een scheduler om GPU's te delen tussen taken en teams in plaats van ze vast toe te wijzen.
- Monitor het gebruik zodat je inactieve GPU's kunt opsporen en vrijmaken.
- Stem de interconnect af op de workload, zodat grote gedistribueerde taken niet worden beperkt door het netwerk.
- Stem de omvang van taken af op de benodigde GPU's in plaats van overmatig capaciteit te reserveren.
- Houd de kosten per team en taak bij om inzicht te houden in de uitgaven.
- Automatiseer het schalen zodat de capaciteit de vraag volgt in plaats van onbenut te blijven.
Conclusie
Een GPU-cluster is een verzameling netwerkgekoppelde GPU-machines die samen fungeren als één grote bron voor versnelde berekeningen, waardoor grootschalige training en inferentie met een hoog volume mogelijk worden. De kracht komt niet alleen van de GPU's zelf, maar ook van de snelle interconnect die samenwerking mogelijk maakt en de scheduler die ze verdeelt. Omdat GPU's kostbaar en schaars zijn, is efficiënt gebruik van een cluster net zo belangrijk als het bezit ervan.
TrueFoundry helpt teams bij het draaien van AI-workloads op hun eigen GPU-clusters, met scheduling, gebruiksmonitoring en autoscaling, zodat dure GPU's efficiënt worden gedeeld. Naarmate de behoefte aan AI-rekenkracht groeit, is het optimaal benutten van een GPU-cluster cruciaal om AI betaalbaar op schaal te kunnen draaien.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is a GPU cluster in simple terms?
It is many computers, each with GPUs, networked and coordinated to work as a single large pool of computing power. It lets you train large models or serve AI at scale beyond what a single GPU could handle.
Why connect GPUs into a cluster instead of using them separately?
Because large jobs need more GPU power than one machine holds, and the GPUs must share data quickly to work on one job together. Fast interconnects and a scheduler turn separate GPUs into a single coordinated resource.
What is a GPU cluster used for?
Large-scale model training spread across many GPUs, high-volume inference serving many users, and shared pools where teams run many smaller jobs. All need more GPU power than a single machine provides.
Why does GPU cluster efficiency matter so much?
Because GPUs are expensive and in short supply, so idle GPUs waste significant money. Good scheduling and high utilization mean more work per GPU, which directly controls the cost of running AI at scale.
What makes a GPU cluster different from just many servers?
The high-speed interconnect and the scheduler. The interconnect lets GPUs exchange data fast enough to cooperate on a single job, and the scheduler shares the pool across many jobs and users, which plain separate servers cannot do.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


