


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is een golden dataset en waarom is het belangrijk?


Je kunt niet bepalen of een model werkt zonder iets betrouwbaars om de output mee te vergelijken. Een golden dataset is die referentie: een gecureerde verzameling voorbeelden, elk gekoppeld aan een geverifieerd correct antwoord, die je gebruikt als standaard voor evaluatie. Het is de meetlat waaraan de kwaliteit van een model wordt afgemeten.
Omdat elke wijziging aan een model of systeem de vraag oproept of het een verbetering is, is een betrouwbare golden dataset essentieel. Hiermee kunnen teams de nauwkeurigheid meten, versies vergelijken en regressies opsporen voordat ze de gebruiker bereiken. Deze gids legt uit wat een golden dataset is, hoe deze wordt opgebouwd en waarom de kwaliteit ervan zo belangrijk is.
We behandelen de definitie, hoe golden datasets worden gemaakt en gebruikt, hoe ze zich verhouden tot trainingsdata en wanneer je ze moet inzetten.
Wat is een golden dataset?
Een golden dataset is een hoogwaardige, zorgvuldig samengestelde verzameling voorbeelden waarbij elke input is gekoppeld aan een vertrouwd, geverifieerd correct antwoord. Het wordt beschouwd als de 'ground truth' voor evaluatie: wanneer je een model hierop loslaat, vergelijk je de output van het model met de golden answers om de prestaties te meten. De nadruk ligt op correctheid en betrouwbaarheid, niet op omvang.
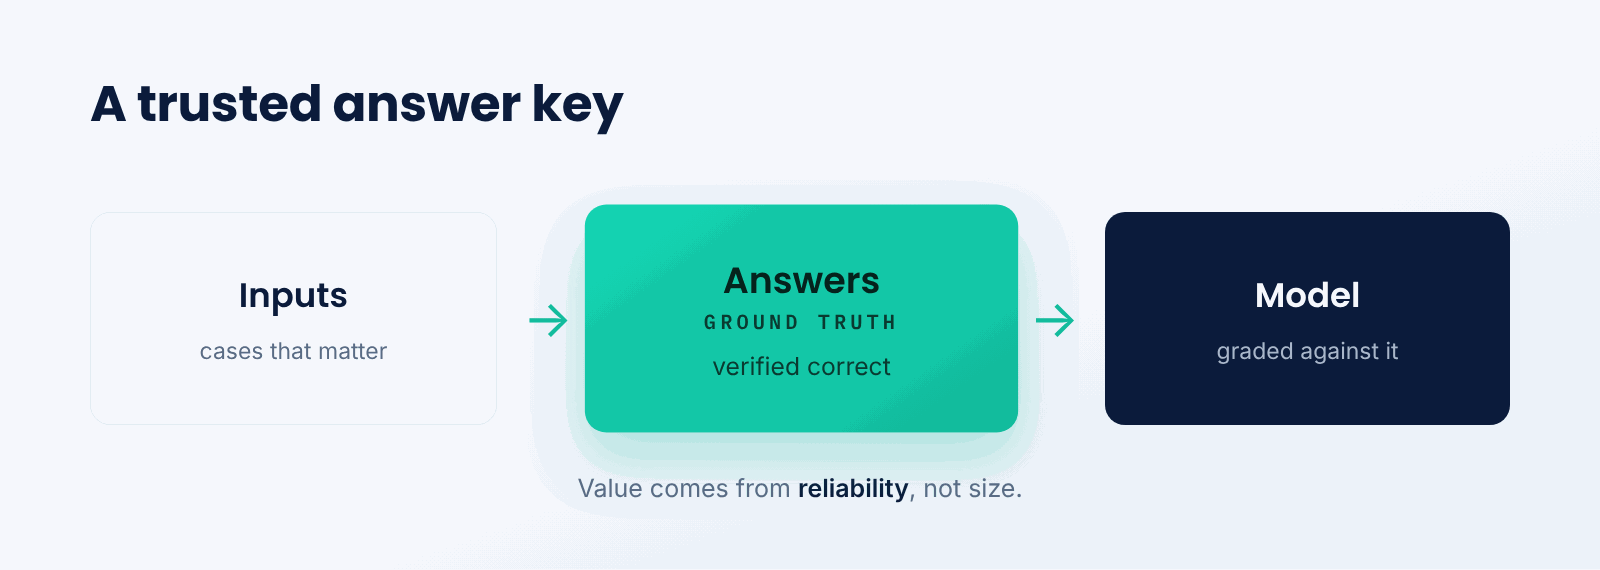
Zie het als een antwoordsleutel voor een examen. De waarde van de antwoordsleutel is dat de antwoorden gegarandeerd juist zijn, waardoor je de prestaties van elke student met vertrouwen kunt beoordelen. Een golden dataset is de antwoordsleutel voor een model, waarmee je de output kunt beoordelen aan de hand van antwoorden die je vertrouwt.
Het kernidee is een vertrouwde 'ground truth'. Wat een dataset 'golden' maakt, is niet de omvang, maar de betrouwbaarheid van de antwoorden, omdat elk evaluatieresultaat afhangt van de correctheid van die antwoorden.
Hoe wordt een golden dataset opgebouwd en gebruikt?
Een golden dataset wordt zorgvuldig samengesteld en vervolgens gebruikt als referentie voor evaluatie.
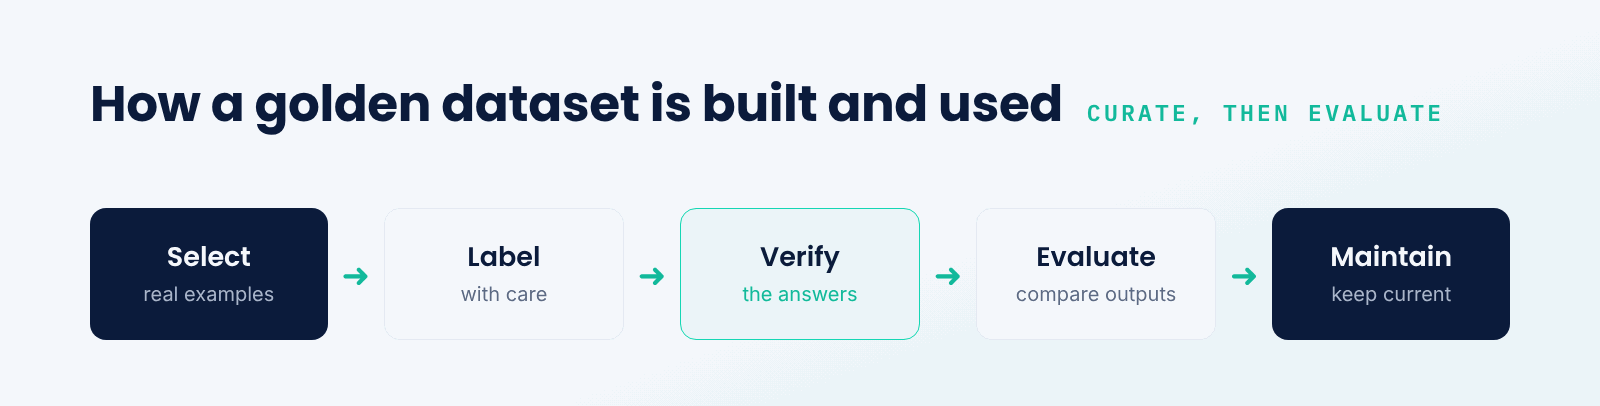
- Selecteer voorbeelden. Kies inputs die representatief zijn voor de relevante praktijksituaties.
- Label zorgvuldig. Wijs correcte antwoorden toe, vaak na beoordeling door experts.
- Verifieer. Controleer de antwoorden zodat ze als betrouwbare 'ground truth' kunnen dienen.
- Evalueer. Draai het model en vergelijk de output met de golden answers.
- Onderhoud. Update de set naarmate de vereisten en praktijkgevallen veranderen.
Omdat het bij een golden dataset volledig draait om vertrouwen, ligt de nadruk op zorgvuldige labeling en verificatie in plaats van op pure omvang. De dataset moet ook de werkelijke verdeling van gevallen weerspiegelen, inclusief complexe en randgevallen, zodat de scores die eruit voortkomen iets zinnigs zeggen over de werkelijke prestaties.
Golden dataset versus trainingsdata
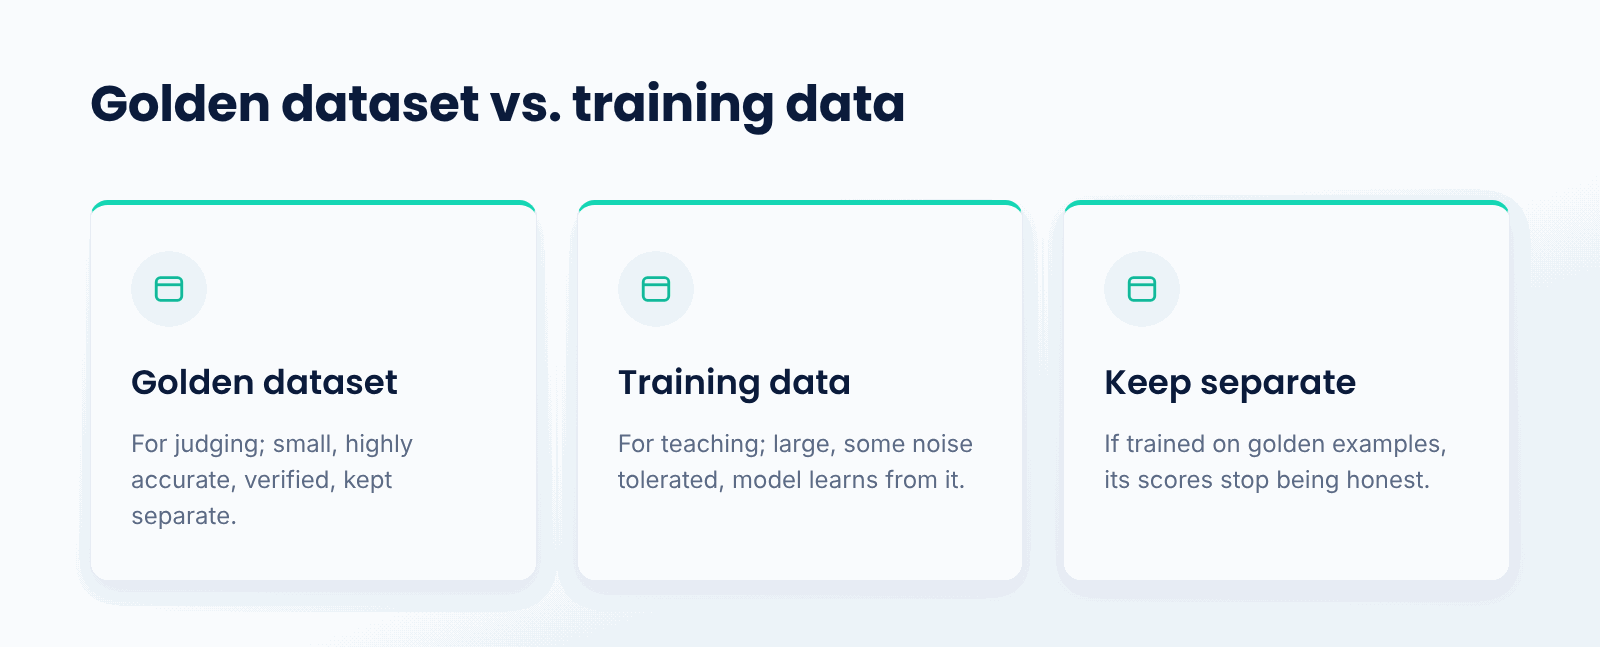
Trainingsdata is de basis waarvan een model leert. Deze is meestal omvangrijk en enige ruis is acceptabel omdat het model generaliseert over vele voorbeelden. De taak van deze data is om het model te onderwijzen, niet om het te beoordelen, en het kan onvolkomenheden bevatten zonder het resultaat te bederven.
Een golden dataset is bedoeld voor beoordeling, niet voor onderwijs. Daarom moet deze strikt gescheiden blijven van de trainingsdata en uiterst nauwkeurig zijn. Als een model getraind zou worden op zijn eigen golden voorbeelden, zou een evaluatie niet langer eerlijk zijn, omdat het model de antwoorden al heeft gezien. Het gescheiden en geverifieerd houden van de golden dataset is wat de scores betrouwbaar maakt.
Waarom is een golden dataset belangrijk?
- Betrouwbare evaluatie. Het biedt geverifieerde antwoorden om prestaties aan af te meten.
- Detectie van regressie. Het signaleert wanneer een wijziging de prestaties verslechtert.
- Vergelijking. Het stelt je in staat om modellen en versies op een eerlijke manier te vergelijken.
- Vertrouwen. Het geeft aan of een model daadwerkelijk goed genoeg is.
- Richting. Het laat zien waar een model zwak is en verbetering behoeft.
Wat zijn de uitdagingen?
- Labelingsinspanning. Geverifieerde antwoorden vereisen expertise en tijd.
- Dekking. Het moet zowel reële situaties als uitzonderingsgevallen bevatten, niet alleen de eenvoudige gevallen.
- Drift. Het moet worden bijgewerkt naarmate de echte wereld en de vereisten veranderen.
- Lekkage. Het moet buiten de trainingsdata blijven om betrouwbaar te blijven.
Wanneer moet je een golden dataset gebruiken?
Gebruik een golden dataset wanneer je een model of systeem betrouwbaar wilt evalueren; dit is altijd het geval wanneer kwaliteit belangrijk is en je wilt weten of wijzigingen verbeteringen opleveren. Het is essentieel voor het vergelijken van modelversies, validatie vóór release en het monitoren van regressies in de loop van de tijd.
Zelfs een kleine golden dataset is waardevol, zolang de antwoorden betrouwbaar zijn en de relevante gevallen worden gedekt. Elk team dat waarde hecht aan de werking van zijn model en wil weten of elke wijziging een verbetering is, heeft baat bij het onderhouden van zo'n dataset.
Kernpunten over golden datasets
- Een golden dataset bestaat uit gecureerde voorbeelden met vertrouwde, geverifieerde antwoorden.
- Het is de 'ground truth' waartegen je een model evalueert.
- De waarde ervan komt voort uit betrouwbaarheid, niet uit omvang.
- Het moet gescheiden blijven van de trainingsdata om eerlijk te blijven.
- Het detecteert regressies en maakt een eerlijke vergelijking mogelijk.
- De kwaliteit ervan bepaalt hoe zinvol de evaluaties zijn.
Conclusie
Een golden dataset is de vertrouwde referentie waartegen een team zijn model meet: een gecureerde set voorbeelden met geverifieerde juiste antwoorden, gebruikt als ground truth voor evaluatie. De waarde ligt in de betrouwbaarheid van de antwoorden, niet in de omvang, en het moet gescheiden blijven van de trainingsdata om betrouwbaar te blijven. Een goede golden dataset is hoe teams weten of een model werkt en of elke wijziging helpt of schaadt.
TrueFoundry helpt teams bij het evalueren en monitoren van modellen op hun eigen infrastructuur, inclusief de golden datasets en evaluatieworkflows die kwaliteit meetbaar houden. Wanneer je moet weten of een model goed genoeg is, is een betrouwbare golden dataset de bron van dat antwoord.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is a golden dataset in simple terms?
It is a thoroughly validated set of examples with correct answers you have confidence in, acting as an answer key to evaluate your model against. You run the model on the inputs and compare its outputs with the golden answers to see how well it performs.
What makes a dataset golden?
Dependable answers, not size. What makes a dataset golden is that its correct answers have been carefully labeled and verified, so you can rely on them as ground truth. It is better to have a small, accurate dataset than a large, noisy one.
How is a golden dataset different from training data?
Training data trains the model, so it can tolerate some noise since the model learns from many examples. A golden dataset evaluates the model, so it must be accurate and kept separate from the training data; otherwise the model would already know the answers and the evaluation would not be honest.
Why must a golden dataset stay separate from training data?
Because if a model is trained on its golden examples, it has already seen the answers, so scoring it on them no longer measures real performance. Keeping the golden dataset out of training is what keeps its evaluation honest and meaningful.
How big should a golden dataset be?
Big enough to cover the cases that matter, including the hard and edge cases, but quality counts more than quantity. Even a small golden dataset can be very valuable, as long as its answers are trustworthy and it represents real usage well.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


