


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is FlashAttention en waarom is het belangrijk?

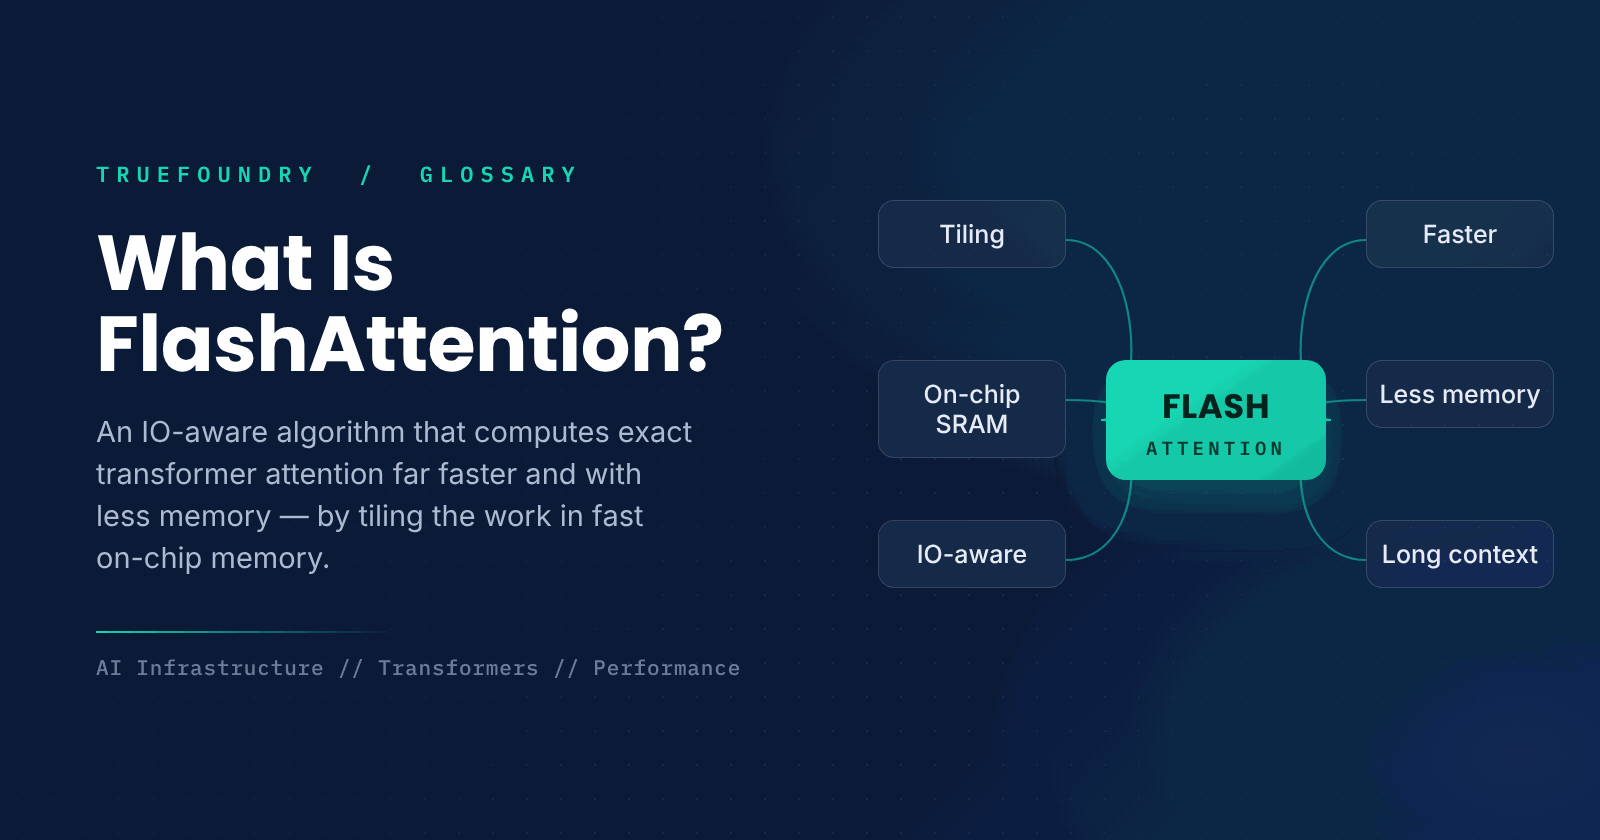
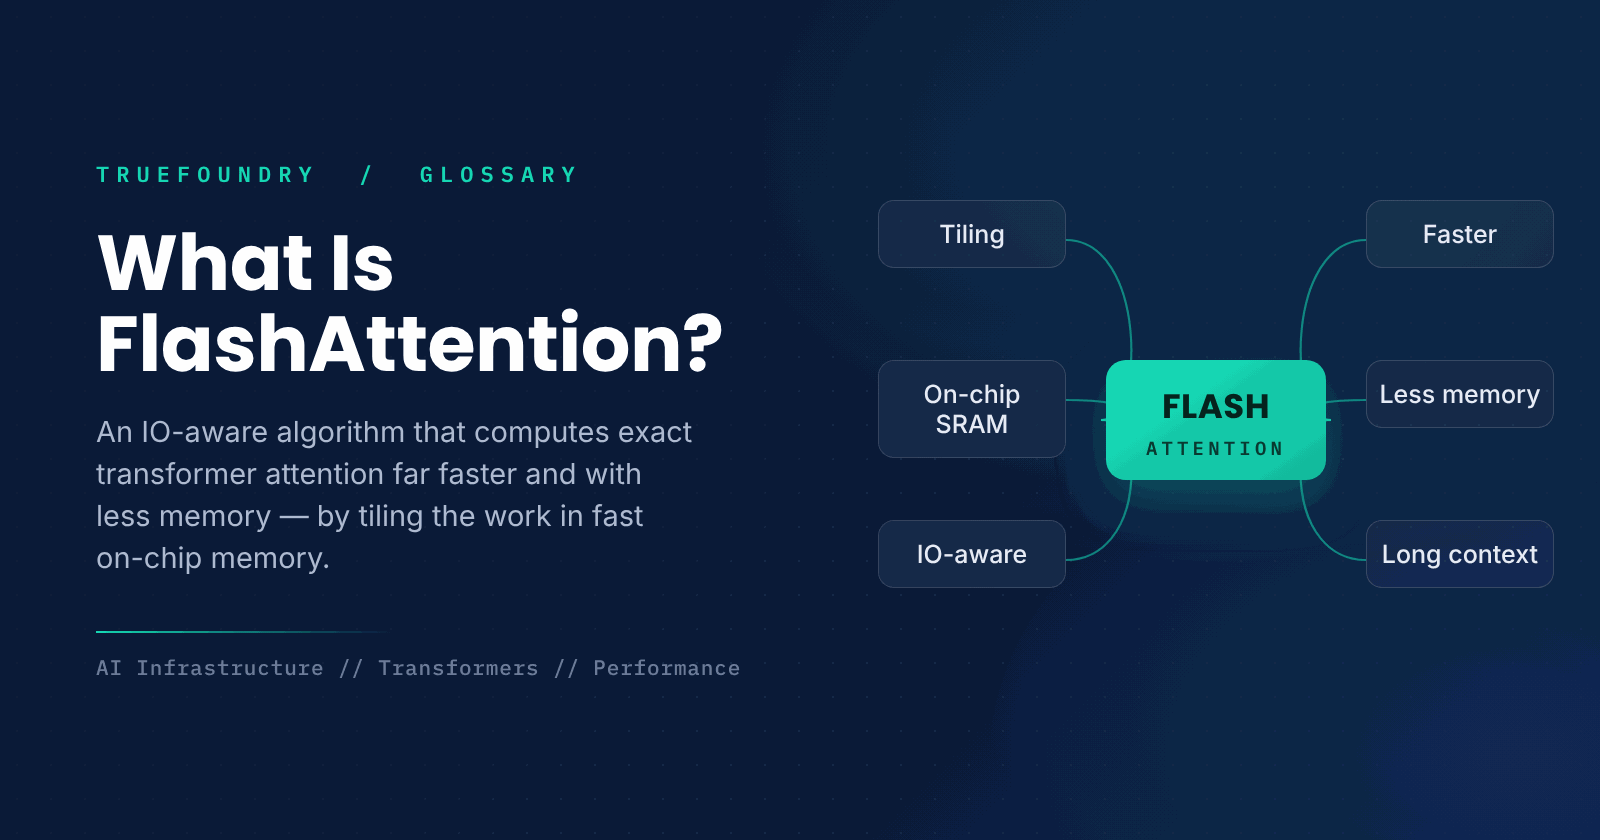
Attention vormt het hart van de transformer, maar de standaardmanier om dit te berekenen is inefficiënt op moderne GPU's. Het bouwt een grote matrix van scores voor elk paar tokens, schrijft deze naar het GPU-geheugen, leest deze weer in en herhaalt dit proces, waardoor de meeste tijd verloren gaat aan het verplaatsen van data in plaats van aan rekenwerk. FlashAttention herschrijft deze berekening zodat de data nauwelijks verplaatst hoeft te worden, wat het aanzienlijk sneller maakt.
Het cruciale inzicht is dat de snelheid van attention niet wordt beperkt door rekenkracht, maar door het dataverkeer tussen het trage high-bandwidth geheugen van de GPU en het snelle on-chip geheugen. Door de berekening zo te herstructureren dat dit verkeer wordt geminimaliseerd, voert FlashAttention exact dezelfde attention veel efficiënter uit. Daarom is het inmiddels een standaardonderdeel geworden bij het trainen en serveren van moderne modellen.
Deze gids legt uit wat FlashAttention is, hoe het werkt, waarin het verschilt van standaard attention en waarom het zo belangrijk is.
Wat is FlashAttention?
FlashAttention is een algoritme voor het berekenen van de attention-operatie van een transformer, geoptimaliseerd voor de manier waarop GPU's daadwerkelijk data verplaatsen. Het levert exact hetzelfde resultaat op als standaard attention, maar reorganiseert het werk zodanig dat de grote tussenliggende attention-matrix nooit volledig naar het hoofdgeheugen van de GPU hoeft te worden geschreven, wat de grootste kostenpost wegneemt.
Zie het als een lange berekening maken op een klein bureau naast een grote archiefkast. De trage methode haalt voor elke stap papieren uit de kast en legt ze weer terug. FlashAttention houdt daarentegen alleen het benodigde deel op het bureau, rondt alles af wat met dat deel mogelijk is en gaat pas daarna verder, waardoor de archiefkast veel minder vaak bezocht hoeft te worden.
Het kernidee is dat het IO-bewust is. Het beschouwt databeweging, niet rekenwerk, als de factor die geminimaliseerd moet worden, omdat op moderne GPU's het in- en uitlezen van de attention-matrix uit het geheugen de grootste tijdvreter is.
Hoe werkt FlashAttention?
FlashAttention berekent attention in tegels (tiles), waarbij tussenresultaten in het snelle geheugen worden bewaard en gaandeweg worden gecombineerd.
- Opsplitsen in tegels. Verdeel de queries, keys en values in kleine blokken.
- Laden naar snel geheugen. Laad één blok tegelijk in het on-chip SRAM van de GPU.
- On-chip berekenen. Bereken de gedeeltelijke attention voor dat blok zonder de volledige matrix uit te schrijven.
- Totaalresultaten combineren. Voeg het resultaat van elk blok samen tot een lopend totaal met behulp van een stabiele online update.
- De grote schrijfactie overslaan. Sla de volledige attention-matrix nooit op in het hoofdgeheugen.
Omdat de volledige scorematrix nooit wordt gematerialiseerd, groeit het geheugengebruik lineair met de sequentielengte in plaats van kwadratisch, en besteedt de berekening zijn tijd aan wiskunde in plaats van aan het verplaatsen van gegevens. Tijdens de training herbereent FlashAttention ook delen van de attention tijdens de backward pass in plaats van ze op te slaan, waarbij een beetje extra rekenwerk wordt ingeruild voor een grote geheugenbesparing.
FlashAttention versus standaard attention
Standaard attention berekent de volledige matrix van scores voor elk paar tokens, schrijft deze naar het GPU-geheugen, past softmax toe en leest deze weer in om de output te produceren. Dat is eenvoudig maar geheugenintensief, en het geheugengebruik groeit met het kwadraat van de sequentielengte. FlashAttention produceert hetzelfde resultaat zonder die volledige matrix ooit op te slaan, waardoor het zowel sneller als veel zuiniger is met geheugen.
Cruciaal is dat FlashAttention exact is, geen benadering. Veel eerdere efficiëntietechnieken versnelden attention door het te benaderen, waarbij kwaliteit werd opgeofferd. FlashAttention geeft dezelfde getallen als standaard attention, en daarom kan het als een snellere vervanging worden ingezet zonder dat het gedrag van het model verandert.
Waarom is FlashAttention belangrijk?
- Snelheid.Het maakt het trainen en de inferentie van transformers aanzienlijk sneller.
- Geheugen.Het verlaagt het geheugengebruik van attention van kwadratisch naar lineair ten opzichte van de sequentielengte.
- Langere context. Het maakt lange contextvensters praktisch om te trainen en te serveren.
- Exactheid. Het is geen benadering, dus de kwaliteit blijft ongewijzigd.
- Alomtegenwoordigheid. Het is een standaardonderdeel geworden in moderne modelstacks.
Wat zijn de afwegingen?
- Hardware-specifiek. De snelheidswinst hangt af van de GPU-architectuur en geoptimaliseerde kernels.
- Complexiteit van de implementatie. Het is afhankelijk van zorgvuldig geschreven low-level kernels.
- Herberekening. Het ruilt wat extra rekenwerk tijdens de backward pass in voor geheugenbesparing.
- Versiegevoeligheid. Voor de beste prestaties moet je de juiste versie afstemmen op je hardware.
Wanneer is FlashAttention relevant voor jou?
Als je transformermodellen traint of inzet, is FlashAttention bijna altijd de moeite waard, omdat het de meest kostbare bewerking versnelt zonder de resultaten te beïnvloeden. Het is vooral belangrijk bij het werken met lange sequenties of grote modellen, waarbij het geheugengebruik van standaard attention de beperkende factor wordt.
Voor de meeste teams is het geen kwestie van zelf implementeren; het zit ingebouwd in moderne frameworks en serving-engines. Het gaat er in de praktijk om dat je zorgt dat het is ingeschakeld en is afgestemd op je hardware, zodat je automatisch profiteert van de snelheid en geheugenvoordelen.
Belangrijke punten over FlashAttention
- Het berekent exacte attention op een IO-bewuste manier.
- Het voorkomt dat de volledige attention-matrix naar het GPU-geheugen wordt geschreven.
- Het verdeelt het werk in tegels (tiling) en houdt dit in het snelle on-chip SRAM.
- Het zorgt ervoor dat het geheugengebruik lineair groeit met de lengte, in plaats van kwadratisch.
- Het versnelt training en inferentie zonder benaderingen.
- Het is een standaardonderdeel van moderne transformer-stacks.
Conclusie
FlashAttention berekent de exacte attention van een transformer op een IO-bewuste manier, waarbij het werk in het snelle on-chip geheugen wordt verdeeld, zodat de grote attention-matrix nooit naar het trage GPU-geheugen hoeft te worden geschreven. Het resultaat is een aanzienlijke versnelling en een verschuiving van kwadratisch naar lineair geheugengebruik, zonder verlies van modelkwaliteit. Daarom is het de standaard geworden in moderne training en serving, en een belangrijke voorwaarde voor lange contextvensters.
TrueFoundry helpt teams om efficiënt transformermodellen te trainen en in te zetten op hun eigen infrastructuur, waar optimalisaties zoals FlashAttention direct leiden tot lagere GPU-kosten en snellere responstijden. Het begrijpen hiervan verklaart grotendeels waarom moderne modellen sneller zijn en langere inputs kunnen verwerken dan voorheen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is FlashAttention in simple terms?
It is a faster, more memory-efficient way to compute a transformer's attention. It gives exactly the same result as the usual method but avoids writing the big attention matrix to GPU memory, so it spends its time on math instead of moving data around.
How does FlashAttention save memory?
By never storing the full matrix of attention scores. It processes attention in small tiles kept in the GPU's fast on-chip memory and combines them with a running update, so memory use grows linearly with sequence length rather than with its square.
Is FlashAttention an approximation?
No. It computes exactly the same attention as the standard method, just far more efficiently. That exactness is why it can replace standard attention with no change to a model's behavior or quality, unlike approximate attention methods.
Why is FlashAttention faster if it does the same math?
Because attention is limited by memory traffic, not arithmetic. Standard attention spends most of its time moving the large score matrix between slow and fast GPU memory. FlashAttention minimizes that movement, so the same math runs much faster.
Do I need to implement FlashAttention myself?
Usually not. It is built into modern training frameworks and serving engines, so the main task is making sure it is enabled and matched to your GPU. When it is, you get the speed and memory benefits automatically.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


