


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is gedistribueerde training en hoe werkt het?

Het trainen van een modern model kan miljarden parameters en biljoenen tokens omvatten. Een enkele GPU kan een groot model niet bevatten of binnen een redelijke tijd door zo'n enorme hoeveelheid data heen werken. Gedistribueerde training is de manier waarop teams beide beperkingen omzeilen door het werk te spreiden over vele apparaten die als één geheel samenwerken.
De uitdaging is coördinatie. De apparaten moeten het werk verdelen, synchroon blijven lopen en hun resultaten combineren, zodat de uitkomst overeenkomt met training op één onmogelijk grote machine. De manier waarop je het werk splitst, bepaalt de belangrijkste vormen van gedistribueerde training.
Deze gids legt uit wat gedistribueerde training is, hoe het werkt, wat de belangrijkste parallellisatiestrategieën zijn en welke afwegingen daarbij komen kijken.
Wat is gedistribueerde training?
Gedistribueerde training is de praktijk waarbij een machine learning-model over meerdere processors, GPU's of machines tegelijk wordt getraind. In plaats van dat één apparaat alle berekeningen uitvoert, wordt het werk verdeeld over vele apparaten die parallel draaien en synchroniseren, zodat het uiteindelijke model hetzelfde is als wanneer een enkel, veel krachtiger apparaat het had getraind.
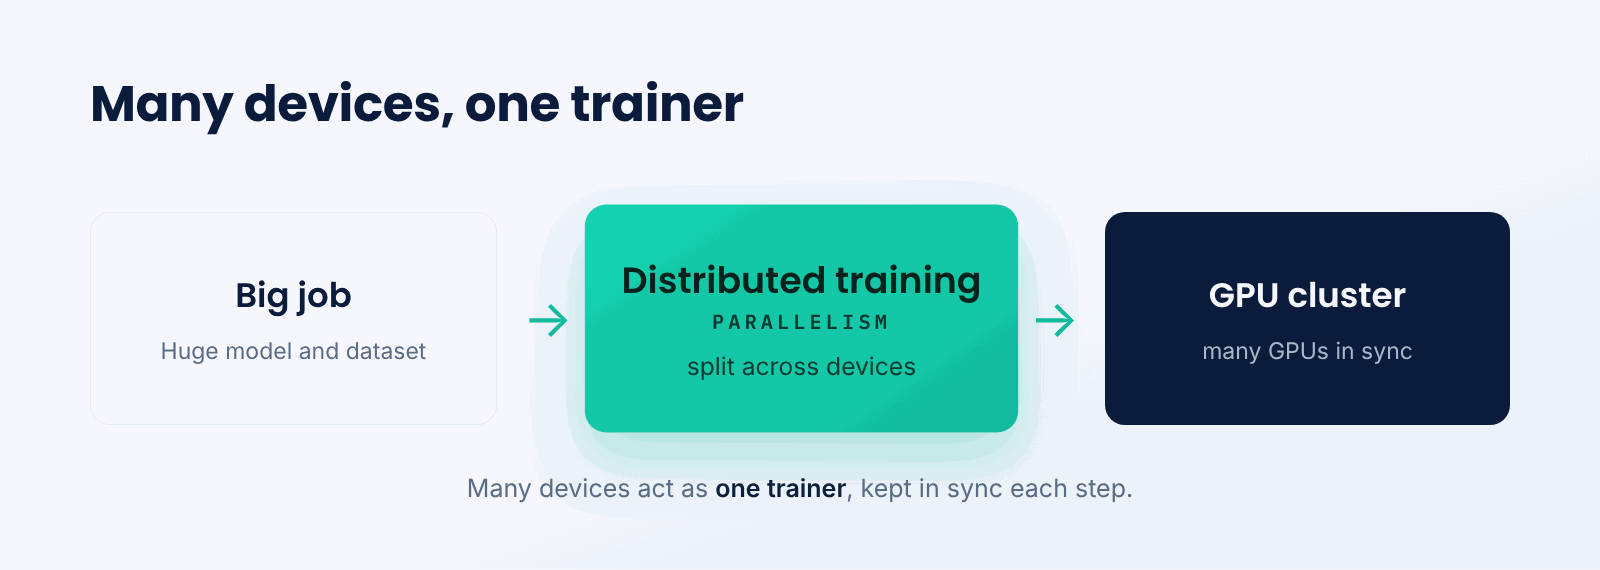
Denk aan een groot bouwproject. Eén arbeider zou er eeuwig over doen, dus haal je een heel team erbij. Ze verdelen de taken, werken tegelijkertijd en coördineren zodat de onderdelen samen één gebouw vormen. Gedistribueerde training is dat team voor een model, waarbij synchronisatie de rol vervult van een uitvoerder die iedereen op één lijn houdt.
Het centrale idee is parallellisme met coördinatie. Veel apparaten voeren tegelijkertijd delen van het werk uit en frequente synchronisatie zorgt ervoor dat ze convergeren naar één gedeeld model.
Hoe werkt gedistribueerde training?
Bij elke trainingsstap berekenen de apparaten de resultaten parallel en vervolgens stemmen ze deze op elkaar af.
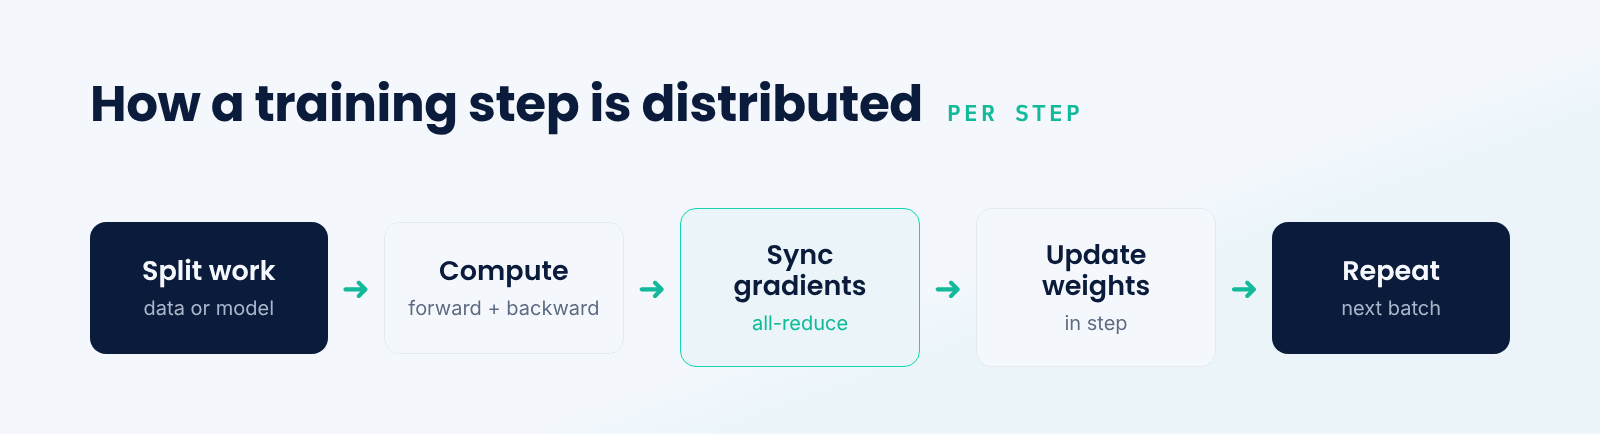
- Verdeel het werk. Het model, de data, of beide worden verdeeld over de beschikbare apparaten.
- Bereken parallel.Elk apparaat voert een forward- en backward-pass uit op zijn deel van de batch.
- Synchroniseer gradiënten. De apparaten wisselen gradiënten uit en combineren deze, vaak met een all-reduce-operatie.
- Update de gewichten. Elk apparaat past dezelfde gecombineerde update toe, zodat ze identiek blijven.
- Herhalen.De cyclus gaat door met de volgende batch totdat de training is voltooid.
De synchronisatiestap is waar gedistribueerde training zijn complexiteit vandaan haalt. Het uitwisselen van gradiënten over vele apparaten vereist snelle verbindingen en zorgvuldige engineering; communicatie kan de flessenhals worden als dit niet goed wordt beheerd.
Data- vs. model- vs. pipeline-parallellisme
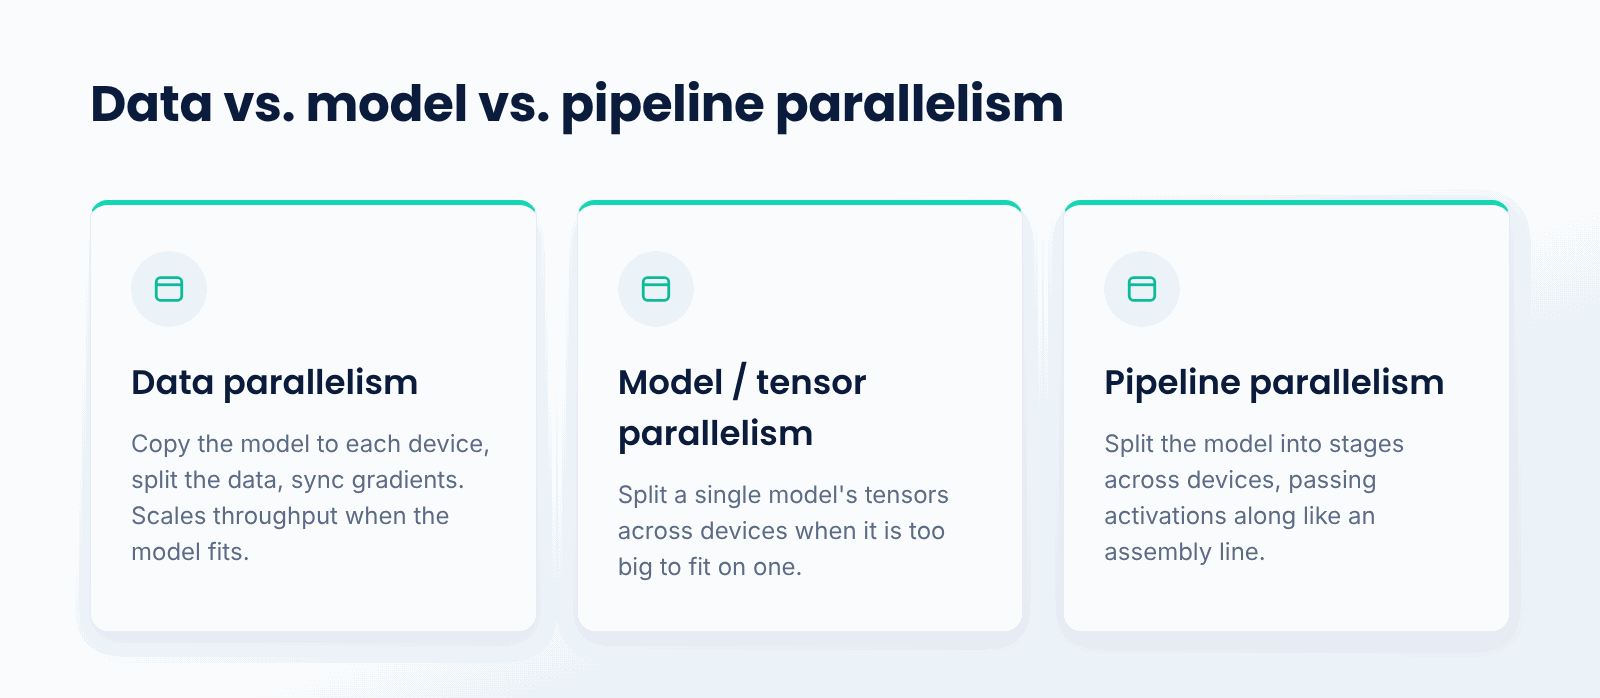
Er zijn drie manieren om het werk te verdelen. Dataparallelisme kopieert het volledige model naar elk apparaat, geeft elk apparaat een ander deel van de data en synchroniseert vervolgens de gradiënten; dit schaalt de doorvoer goed, zolang het model op één apparaat past. Model- of tensorparallelisme splitst de lagen of tensors van een enkel model over meerdere apparaten voor modellen die te groot zijn voor één apparaat. Pipeline-parallelisme verdeelt het model in sequentiële fasen over apparaten, waarbij activaties als aan een lopende band worden doorgegeven.
Bij grootschalige training worden deze methoden meestal gecombineerd. Een grensverleggend model kan tegelijkertijd gebruikmaken van dataparallelisme over groepen machines, tensorparallelisme binnen een machine en pipeline-parallelisme over verschillende fasen, om zo duizenden GPU's efficiënt in te zetten.
Wat zijn de voordelen van gedistribueerde training?
- Grotere modellen trainen. Dankzij model- en pipeline-parallelisme kun je modellen trainen die te groot zijn voor een enkel apparaat.
- Sneller trainen. Door data over apparaten te verspreiden, wordt de werkelijke tijd die nodig is om een dataset te verwerken aanzienlijk verkort.
- Enorme datasets verwerken. Parallelisme maakt het haalbaar om te trainen op biljoenen tokens.
- Schalen met hardware. Het toevoegen van meer apparaten vergroot de capaciteit zonder dat de methode hoeft te veranderen.
- Betere benutting. Wanneer dit goed wordt aangepakt, blijven dure versnellers aan het werk in plaats van dat ze inactief zijn.
Wat zijn de uitdagingen?
- Communicatie-overhead. Het synchroniseren van gradiënten tussen apparaten kan de flessenhals worden.
- Complexe configuratie. Het combineren en afstemmen van parallelismestrategieën is technisch zeer uitdagend.
- Fouttolerantie. Bij veel apparaten komen storingen vaak voor en deze moeten worden opgevangen zonder dat de voortgang verloren gaat.
- Kosten.Grote clusters van versnellers en snelle interconnects zijn duur in gebruik.
Wanneer heb je gedistribueerde training nodig?
Je hebt het nodig zodra een model of dataset te groot wordt voor één apparaat. Het trainen van grote taalmodellen, het werken met zeer grote datasets of de noodzaak om de trainingstijd van weken naar dagen te verkorten, zijn allemaal redenen om het werk te verdelen.
Voor kleine modellen en bescheiden datasets die gemakkelijk op één GPU passen, is een enkel apparaat eenvoudiger en goedkoper. De complexiteit van distributie loont pas zodra de schaal het noodzakelijk maakt.
Best practices voor gedistribueerde training
- Begin met dataparallelisme, de eenvoudigste strategie, voordat je overstapt op model- of pipeline-splitsing.
- Gebruik snelle interconnects zodat de synchronisatie van gradiënten de staptijd niet domineert.
- Laat communicatie en berekeningen elkaar overlappen om synchronisatiekosten waar mogelijk te verbergen.
- Maak regelmatig checkpoints zodat een defect apparaat je niet de hele run kost.
- Gebruik volwassen frameworks en bibliotheken in plaats van zelf distributielogica vanaf nul op te bouwen.
- Monitor het gebruik van apparaten om achterblijvers en communicatieknelpunten vroegtijdig op te sporen.
Conclusie
Gedistribueerde training verdeelt het werk van het trainen van een model over vele apparaten, waardoor grote modellen en datasets binnen een praktische tijd getraind kunnen worden. Door data, het model of beide te splitsen en elke stap te synchroniseren, fungeren vele apparaten als één trainer. De kunst is om de juiste parallellisatiestrategieën te kiezen en te combineren, en te voorkomen dat communicatie de bottleneck wordt.
TrueFoundry helpt teams bij het uitvoeren van trainings- en fine-tuning-taken op hun eigen GPU-infrastructuur door clusters, planning en benutting te beheren, zodat gedistribueerde workloads efficiënt draaien. Naarmate modellen en datasets blijven groeien, is gedistribueerde training de manier waarop teams trainingstijden en kosten onder controle houden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is distributed training in simple terms?
This refers to training a model using several GPUs or computers simultaneously, as opposed to one computer only. The machines divide up the task and work in parallel to produce results equivalent to training on a single large machine, just faster or bigger.
What is data parallelism?
Data parallelism involves copying the entire model to each device and assigning each device a unique portion of the data. Gradients between devices are synchronized at each step to keep them consistent. It scales throughput as long as the model fits on a single device.
What is the difference between data and model parallelism?
Data parallelism replicates the model and splits the data. Model parallelism splits a single model across multiple devices because it is too big to fit on one. Large runs often combine both, plus pipeline parallelism.
Why is synchronization important?
Because every device has to conclude each step with identical weights. Synchronizing gradients among devices lets them work together as one model; however, this introduces communication overhead that can become the bottleneck.
Do I always need distributed training?
No. When the model or dataset fits on one device, using a single GPU is easier and more economical. You need distribution only when the model or dataset exceeds the capacity of one device, or the time needed for training becomes too long.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


