


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Distributed Tracing en waarom is het belangrijk?

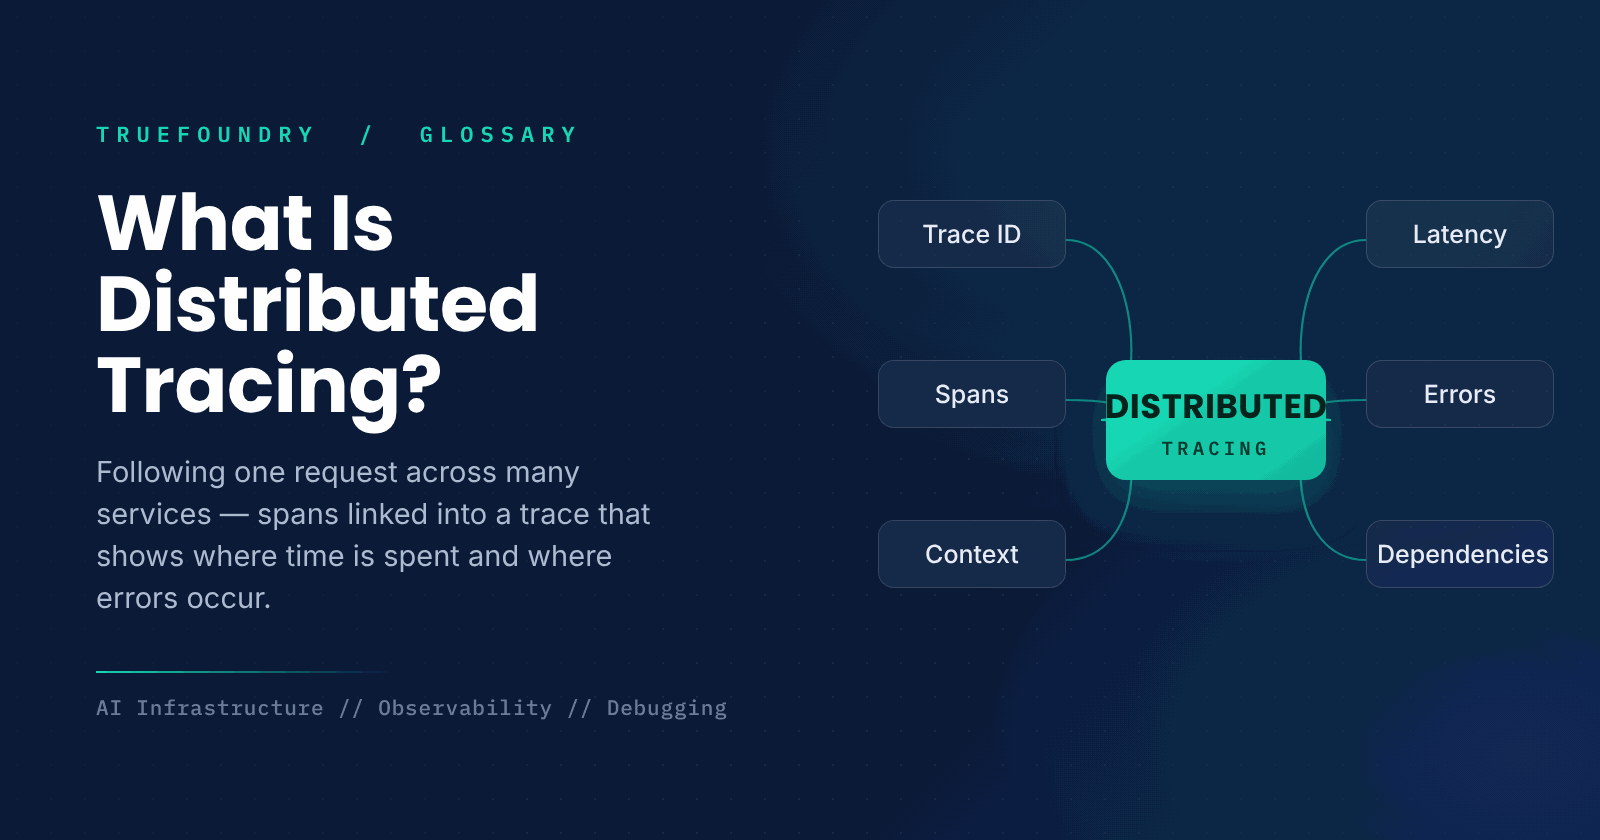
In een systeem dat uit vele services bestaat, kan een enkel gebruikersverzoek door wel twaalf services gaan voordat er een antwoord terugkomt. Wanneer iets traag is of kapotgaat, vertellen logs van één service zelden het hele verhaal. Distributed tracing lost dit op door elk verzoek van begin tot eind te volgen, over elke service die het raakt.
Naarmate applicaties verschoofden van monolithische architecturen naar microservices, en AI-systemen uitgroeiden tot meerstaps-pipelines van modellen, retrievers en tools, werd het cruciaal om gedrag over servicegrenzen heen te begrijpen. Distributed tracing biedt die zichtbaarheid over services heen, waardoor het mogelijk is om precies te zien waar een verzoek tijd heeft doorgebracht en waar het misging.
Deze gids legt uit wat distributed tracing is, hoe traces en spans werken, waarin het verschilt van logging en metrics, en waarom het belangrijk is.
Wat is distributed tracing?
Distributed tracing is een methode om een verzoek te volgen terwijl het door de componenten van een gedistribueerd systeem stroomt. Elke operatie onderweg – een service-aanroep, een databasequery, een model-inferentie – wordt vastgelegd als een span met timing en metadata. De spans voor één verzoek worden gekoppeld tot een enkele trace die het volledige pad van het verzoek laat zien.
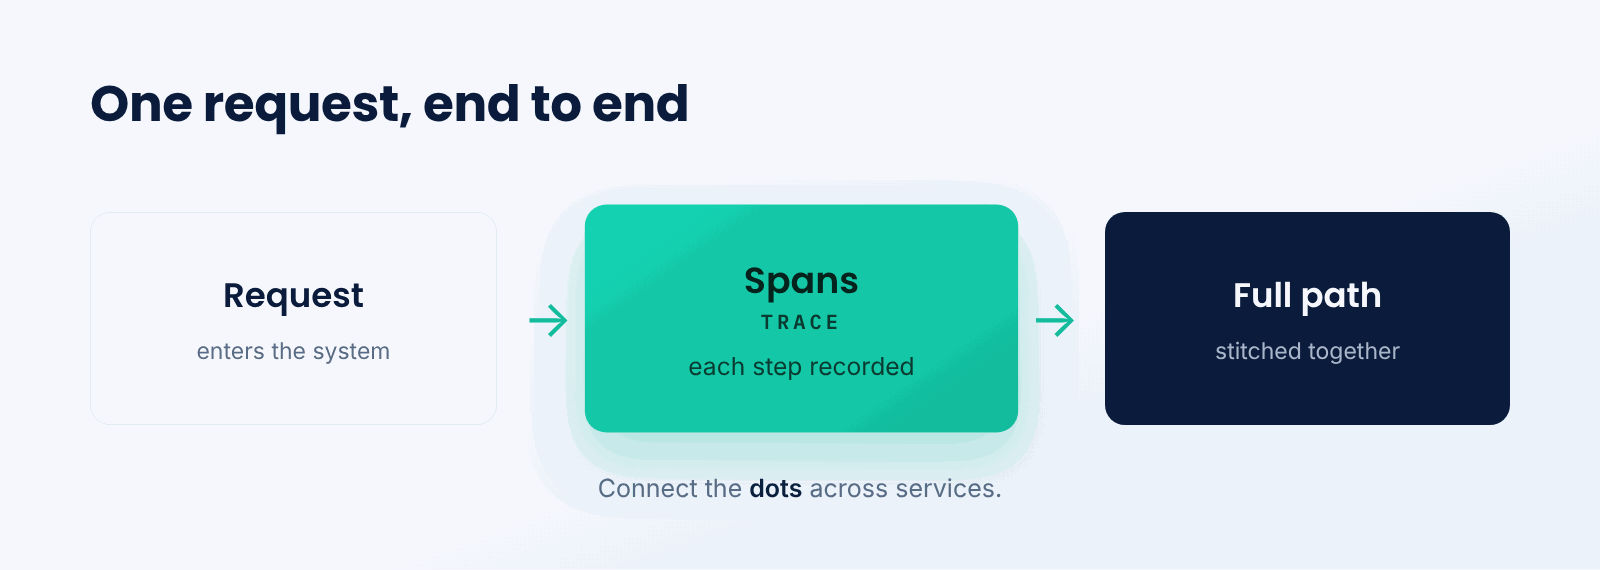
Zie het als het volgen van een pakketje via een bezorgnetwerk. Elke faciliteit waar het langskomt, scant het met een tijdstempel, en samen laten die scans de volledige reis zien: waar het heen ging, hoe lang elk onderdeel duurde en waar het bleef steken. Een trace doet hetzelfde voor een verzoek dat door services beweegt.
Het kernidee is het verbinden van de punten tussen services. In plaats van geïsoleerde logs in elke component, voegt een trace de hele reis samen, zodat je het verzoek als een enkele, coherente stroom kunt zien in plaats van als verspreide fragmenten.
Hoe werkt distributed tracing?
Tracing werkt door elk verzoek te labelen en spans vast te leggen terwijl het door het systeem beweegt.
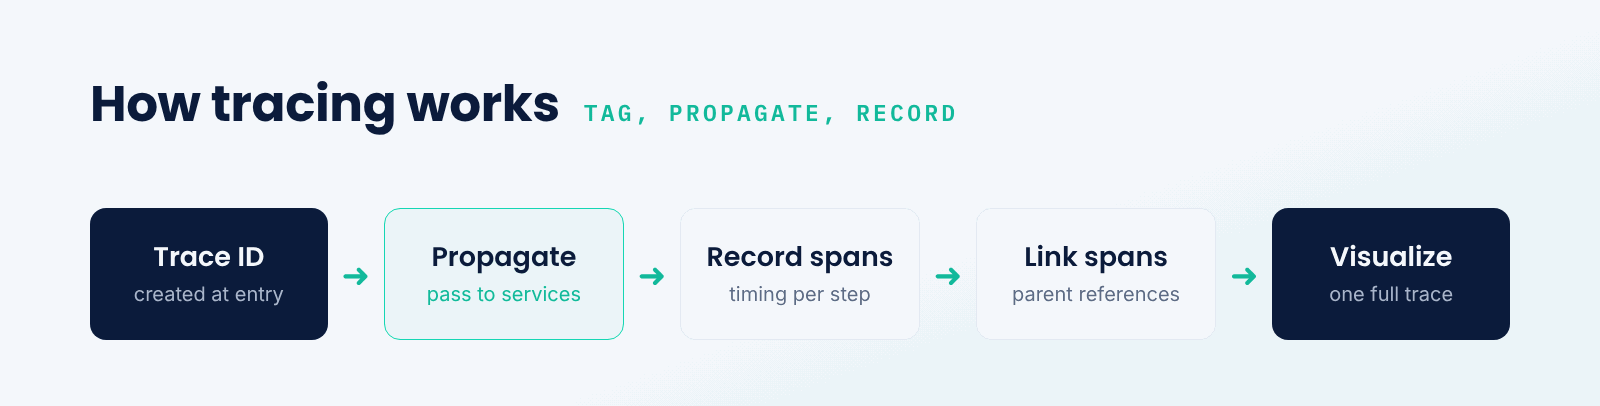
- Wijs een trace-ID toe. Er wordt een uniek ID aangemaakt wanneer het verzoek het systeem binnenkomt.
- Verspreid de context. Dat ID wordt doorgegeven aan elke downstream-service.
- Leg spans vast. Elke operatie legt een span vast met de bijbehorende timing en metadata.
- Koppel spans. Spans verwijzen naar hun parent, waardoor een boomstructuur voor de trace ontstaat.
- Verzamel en bekijk. Spans worden verzameld en gevisualiseerd als één end-to-end trace.
Het cruciale mechanisme is context-propagatie: het doorgeven van de trace-ID over servicegrenzen heen, zodat alle spans kunnen worden gekoppeld aan hetzelfde verzoek. Zonder dit zouden de spans van elke service los van elkaar staan. Met dit mechanisme wordt het volledige pad samengevoegd tot één enkele trace.
Tracing vs. logging vs. metrics
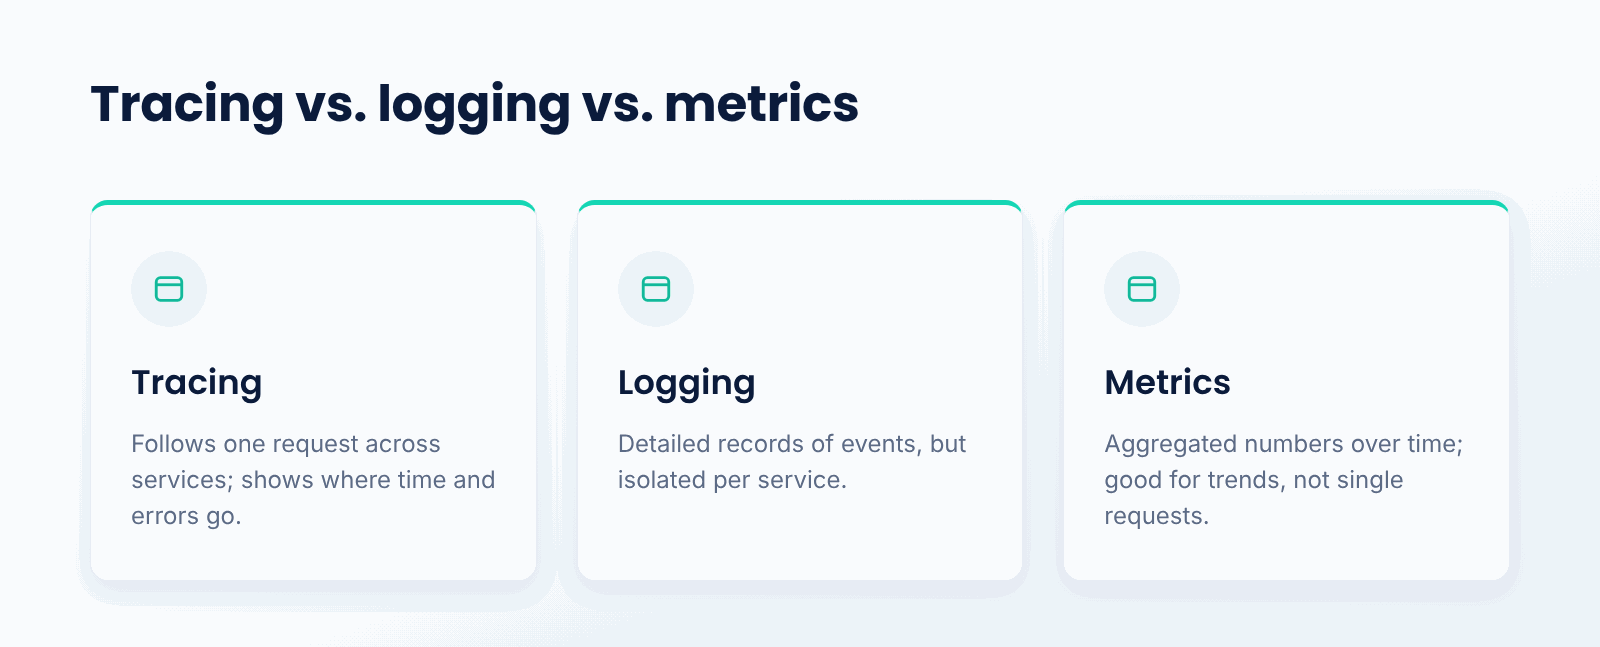
Deze drie vormen de pijlers van observability. Logs zijn tijdgebonden registraties van afzonderlijke gebeurtenissen, rijk aan details maar geïsoleerd per service. Metrics zijn geaggregeerde cijfers over een bepaalde periode, zoals aanvraagfrequenties en latenties; nuttig voor trends, maar niet voor individuele verzoeken. Traces volgen een enkel verzoek door verschillende services heen en laten zien hoe de tijd en fouten over het hele pad zijn verdeeld.
Ze vullen elkaar aan. Metrics vertellen je dat er iets mis is en wanneer, traces laten zien waar in de aanvraagstroom het probleem zich bevindt, en logs bieden de gedetailleerde context op dat punt. Samen stellen ze je in staat om van het opmerken van een probleem over te gaan naar het lokaliseren en begrijpen ervan.
Waarom is distributed tracing belangrijk?
- Zichtbaarheid tussen services. Het toont het volledige pad van een verzoek door het systeem.
- Latentie-debugging. Het onthult precies waar de tijd aan wordt besteed.
- Foutlokalisatie. Het wijst precies aan welke service een fout heeft veroorzaakt.
- Inzicht in afhankelijkheden. Het maakt interacties tussen services zichtbaar.
- AI-pipelines. Het traceert verzoeken door ketens van modellen en tools heen.
Wat zijn de afwegingen?
- Instrumentatie. Services moeten worden geïnstrumenteerd om spans te kunnen verzenden.
- Overhead. Het verzamelen en opslaan van traces brengt enige kosten met zich mee.
- Sampling. Systemen met een hoog volume traceren vaak slechts een fractie van de verzoeken.
- Contextdiscipline. Trace-context moet consistent worden doorgegeven om nuttig te zijn.
Wanneer moet je distributed tracing gebruiken?
Gebruik het wanneer verzoeken meerdere services of stappen omvatten en je inzicht nodig hebt in de prestaties en fouten daartussen; dit is typerend voor microservice-architecturen en AI-pipelines met meerdere fasen. Het is het meest waardevol bij het debuggen van latentie of fouten die de logs van een individuele service niet kunnen verklaren.
Voor een eenvoudige applicatie met één service voegt tracing minder waarde toe en kunnen logs en statistieken volstaan. Maar zodra een verzoek zich verspreidt over verschillende componenten, wordt distributed tracing de tool die het gedrag van het systeem begrijpelijk maakt.
Kernpunten over distributed tracing
- Het volgt één verzoek door vele services heen.
- Spans registreren individuele operaties; gekoppelde spans vormen samen een trace.
- Context-propagatie koppelt spans aan hetzelfde verzoek.
- Het vormt een aanvulling op logs en statistieken voor observability.
- Het is essentieel voor microservices en AI-pipelines.
- Systemen met een hoog volume gebruiken vaak sampling voor traces om de kosten te beheersen.
Conclusie
Distributed tracing volgt een enkel verzoek door elke service die het raakt, registreert elke stap als een span en koppelt deze aan elkaar tot één trace. Dit overzicht over verschillende services heen laat zien waar tijd wordt besteed en waar fouten optreden, wat het essentieel maakt voor het debuggen van microservices en AI-pipelines met meerdere stappen. Samen met logs en statistieken verandert het een kluwen van services in een begrijpelijk systeem.
TrueFoundry helpt teams bij het implementeren en observeren van AI-systemen op hun eigen infrastructuur, met tracing die verzoeken volgt door ketens van modellen, retrievers en tools. Wanneer verzoeken vele componenten omvatten, is distributed tracing wat prestaties en fouten zichtbaar maakt.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is distributed tracing in simple terms?
Tracing is precisely the method of choosing one request and watching it as it traverses multiple services within a deployment. Timing data logs each step along the way, linking them all into one continuous trace, so you have everything needed to understand how long it takes, where bottlenecks occur, and where failure points emerge.
What are spans and traces?
A span is an atomic record of an individual operation, such as a service invocation or database query, including its timing data and context attributes. A trace is the linked spans for a single request, forming a hierarchical tree that maps the entire course of the request from entry to exit.
How is tracing different from logging?
Logs describe specific events in fine detail but remain segmented by service boundaries. Traces stitch together all the operations of a single request across multiple services. Logs provide context at a moment; traces show the complete journey, and the two are used together.
What is context propagation?
Context propagation is passing the trace ID along the request path, so those individual service spans have enough metadata to trace all the way back to the originating request. Strip it away, and each service operates independently; with it, the full path reassembles into a single coherent trace.
Why is tracing important for AI systems?
Because AI applications frequently chain multiple models, retrieval systems, and tools within one request. Tracing follows those requests along their journey, revealing where latency builds up and which step failed, which is difficult to infer from any individual component's logs alone.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


