


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Direct Preference Optimization en waarom is het belangrijk?

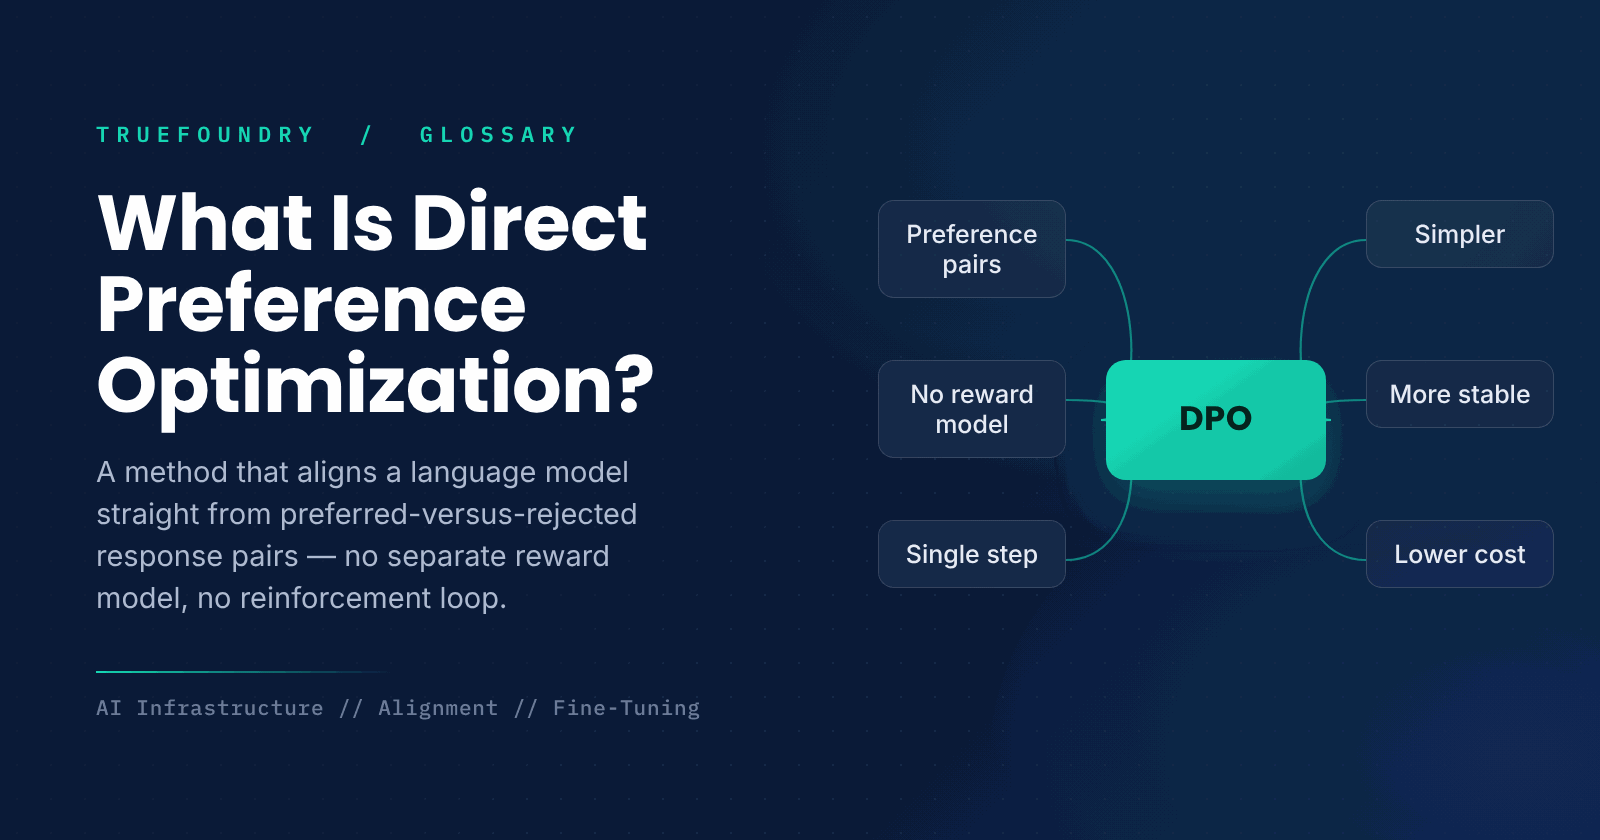
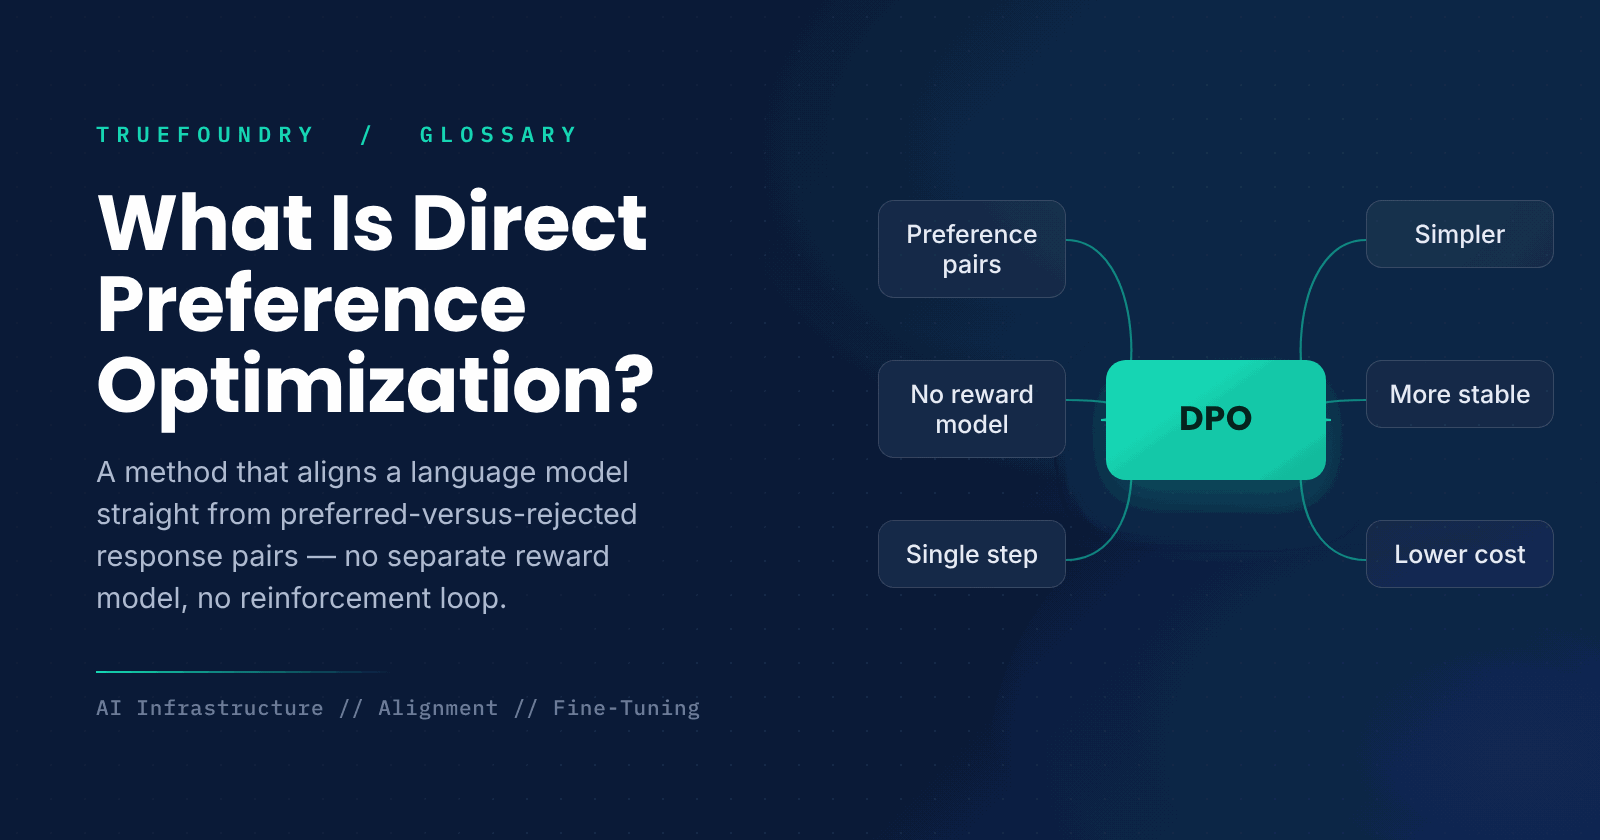
Nadat een taalmodel is gefinetuned om instructies op te volgen, willen teams het meestal verder afstemmen op menselijke voorkeuren, zodat het behulpzaam en eerlijk is en de gewenste toon aanslaat. De gevestigde methode hiervoor, reinforcement learning from human feedback (RLHF), is krachtig maar complex: er wordt een apart beloningsmodel getraind en vervolgens wordt reinforcement learning gebruikt om daarop te optimaliseren, wat bewerkelijk en kostbaar is.
Direct Preference Optimization biedt een eenvoudiger pad. Het traint het model rechtstreeks op menselijke voorkeursdata, bestaande uit paren van een beter en een slechter antwoord, zonder een apart beloningsmodel of een reinforcement-loop. Het resultaat is een afstemming die makkelijker uit te voeren en stabieler is, wat de reden is dat DPO een populair alternatief is geworden. Deze gids legt uit wat het is en hoe het werkt.
We behandelen de definitie, het trainingsproces, de vergelijking met RLHF en wanneer je het moet gebruiken.
Wat is Direct Preference Optimization?
Direct Preference Optimization, of DPO, is een techniek om een taalmodel af te stemmen op menselijke voorkeuren door het rechtstreeks te trainen op paren van antwoorden waarbij het ene de voorkeur krijgt boven het andere. Het model wordt geoptimaliseerd om het geprefereerde antwoord waarschijnlijker te maken en het afgewezen antwoord minder waarschijnlijk, waardoor menselijke voorkeuren direct uit de data worden geleerd zonder een tussenliggend beloningsmodel.
Zie het als lesgeven door middel van directe vergelijking. In plaats van eerst een beoordelingsrubriek op te stellen en daarop te coachen, laat je het model simpelweg veel paren zien en geef je aan welke mensen beter vonden; het model leert vervolgens om de kant op te buigen van het soort antwoord dat mensen prefereren.
Het kernidee is het direct optimaliseren van voorkeuren. Door wat RLHF in twee fasen splitst samen te voegen tot één trainingsdoel, verwijdert DPO een hele laag aan complexiteit, terwijl het model nog steeds dezelfde voorkeuren leert.
Hoe werkt DPO?
DPO traint op voorkeursparen met één enkel doel dat het gekozen antwoord bevoordeelt.
- Verzamel voorkeuren. Verzamel paren waarbij mensen hebben aangegeven welk antwoord beter is.
- Start vanaf een SFT-model. Begin met een basismodel dat is getuned op instructies.
- Vergelijk paren. Bekijk voor elk paar het geprefereerde en het afgewezen antwoord.
- Optimaliseer direct. Pas het model aan om het geprefereerde antwoord te verhogen en het afgewezen antwoord te verlagen.
- Houd het verankerd. Blijf dicht bij het oorspronkelijke model om afwijkingen te voorkomen.
Het trainingsdoel verhoogt de relatieve voorkeur van het model voor het gekozen antwoord ten opzichte van het afgewezen antwoord, terwijl een ingebouwde term voorkomt dat het te ver afwijkt van het beginmodel. Dit biedt de voordelen van RLHF-alignment zonder dat er een apart beloningsmodel getraind of geraadpleegd hoeft te worden.
DPO versus RLHF
RLHF werkt in twee fasen: eerst wordt een beloningsmodel getraind om menselijke voorkeuren te voorspellen, daarna wordt reinforcement learning gebruikt om het taalmodel te optimaliseren op basis van die beloning. Het is krachtig en bewezen effectief, maar de reinforcement-stap is complex, gevoelig voor afstelling en rekenintensief.
DPO brengt dit terug tot één stap, waarbij het model direct wordt geoptimaliseerd op de voorkeursparen met een eenvoudige loss-functie. Het is makkelijker te implementeren, stabieler in de training en goedkoper in gebruik, terwijl het op veel taken een vergelijkbare alignment-kwaliteit behaalt. Het nadeel is minder flexibiliteit dan bij een volledige reinforcement-opzet, wat bij de meest veeleisende alignment-doelen een rol kan spelen.
Waarom is DPO belangrijk?
- Eenvoud. Het verwijdert de noodzaak voor een beloningsmodel en een reinforcement-loop.
- Stabiliteit. Het traint betrouwbaarder dan reinforcement learning.
- Lagere kosten.Het vereist minder rekenkracht en technische inspanning.
- Toegankelijkheid.Het maakt alignment op basis van voorkeuren toegankelijk voor meer teams.
- Vergelijkbare kwaliteit. Het evenaart RLHF bij veel alignment-taken.
Wat zijn de afwegingen?
- Afhankelijkheid van data. Er zijn nog steeds goede voorkeursparen nodig om van te leren.
- Minder flexibiliteit. Het is minder expressief dan een volledige RL-opzet.
- Anker-afstelling. De term die de afwijking beperkt, moet zorgvuldig worden ingesteld.
- Geen wondermiddel. Voor specifieke alignment-doelen kan RLHF nog steeds de voorkeur genieten.
Wanneer moet je DPO gebruiken?
Gebruik DPO wanneer je een model wilt afstemmen op menselijke voorkeuren en waarde hecht aan eenvoud, stabiliteit en lagere kosten. Het is een sterke standaardkeuze voor teams die over voorkeursdata beschikken, maar de complexiteit van een volledig reinforcement learning-traject willen vermijden; dit geldt voor veel praktische alignment-projecten.
Als je de maximale flexibiliteit van een op een reward-model gebaseerde opzet nodig hebt, of als je alignment-doelen daarom vragen, kan RLHF de extra complexiteit nog steeds waard zijn. Maar voor de meeste teams biedt DPO het merendeel van de voordelen tegen een fractie van de inspanning.
Belangrijke punten over DPO
- DPO stemt een model direct af op basis van voorkeursparen.
- Het verwijdert het reward-model en de reinforcement-loop van RLHF.
- Het is eenvoudiger, stabieler en goedkoper om uit te voeren.
- Het verhoogt de score van het gewenste antwoord en verlaagt die van het afgewezen antwoord.
- Het blijft verankerd aan het basismodel om afwijkingen te voorkomen.
- Het evenaart de kwaliteit van RLHF bij veel taken.
Conclusie
Direct Preference Optimization is een eenvoudigere manier om taalmodellen af te stemmen op menselijke voorkeuren. Er wordt direct getraind op paren van gewenste versus afgewezen antwoorden, zonder het reward-model en de reinforcement-loop die RLHF vereist. Het is makkelijker te implementeren, stabieler en goedkoper, terwijl het bij veel taken een vergelijkbare kwaliteit behaalt. Daarom is het een populaire methode voor alignment geworden.
TrueFoundry helpt teams bij het finetunen en afstemmen van modellen op hun eigen infrastructuur, inclusief op voorkeuren gebaseerde methoden zoals DPO die alignment eenvoudig en kosteneffectief houden. Wanneer je afgestemd gedrag nodig hebt zonder de overhead van reinforcement learning, is DPO een uitstekend startpunt.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is DPO in simple terms?
It is a method for training a model toward the type of answer people prefer, based on direct training on pairs of a better and a worse answer. In this approach, there is no need for an additional reward model or reinforcement learning, as RLHF uses.
How is DPO different from RLHF?
There are two phases in RLHF: it first trains a reward model to score responses, and then applies reinforcement learning based on it. DPO merges both phases into one, where the model is optimized directly on preference pairs using a simple loss function, which makes it simpler, more stable, and cheaper.
Does DPO still need human preference data?
Yes. Since DPO is trained on pairs of answers where people have ranked one as better, the quality of the preference data is very important. What it removes is the separate reward model and reinforcement loop, not the need for human preferences in the first place.
Is DPO as good as RLHF?
For many alignment tasks, DPO is equally good with far less overhead. While RLHF can still provide more flexibility for the toughest use cases, in practice DPO is sufficient in most cases while using far less in resources and effort.
When should I use DPO instead of RLHF?
Select DPO if you want preference alignment and value simplicity, stability, and reduced cost, and you have preference data for training. Select RLHF if you specifically require the added flexibility of a reward-model-based reinforcement setup.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


