


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Differential Privacy en waarom is het belangrijk?

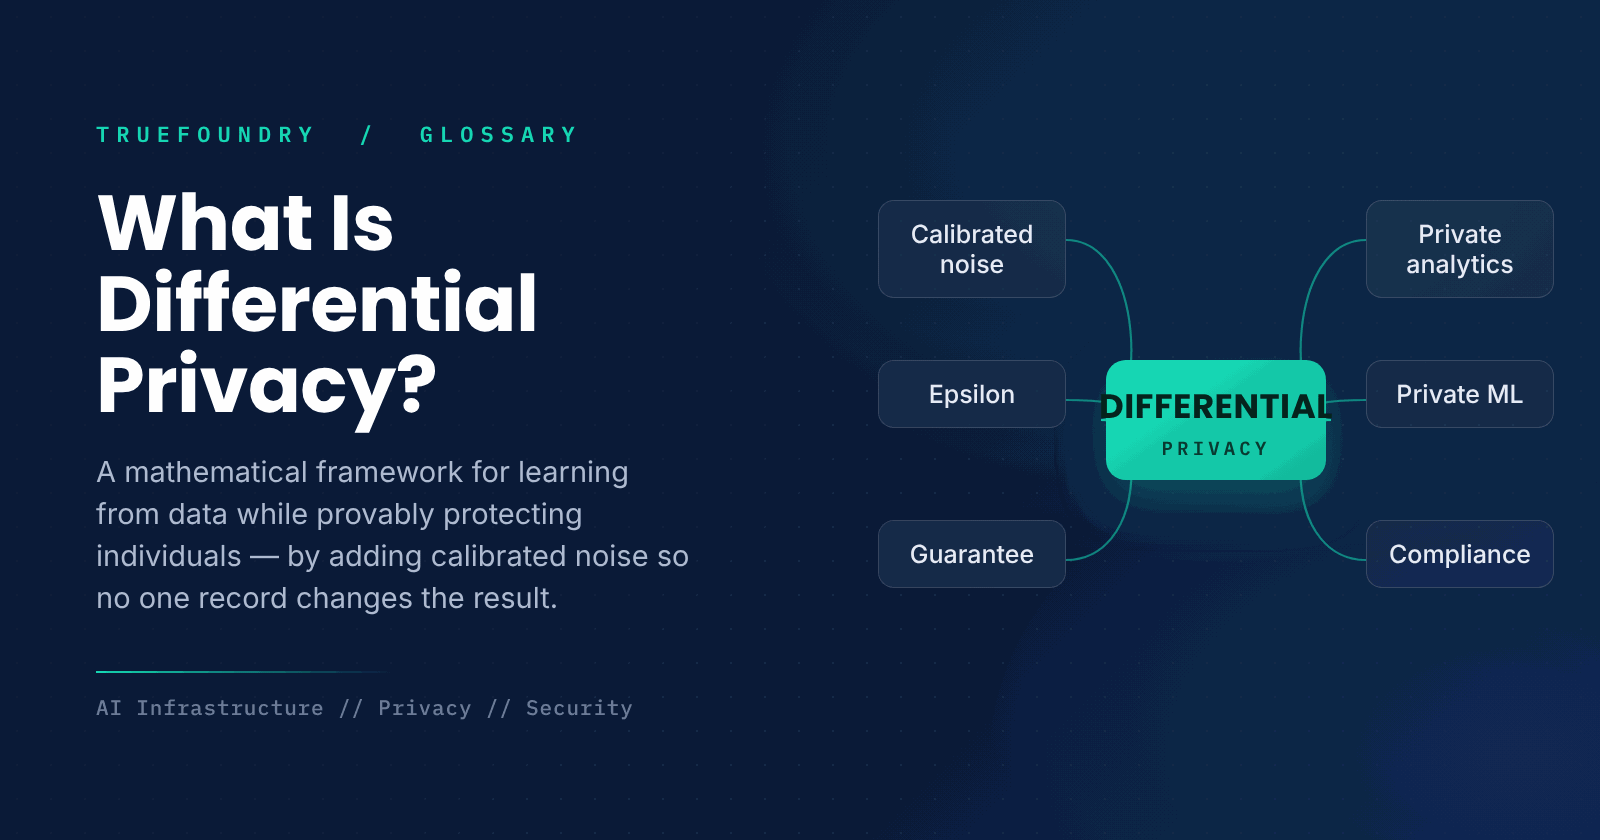
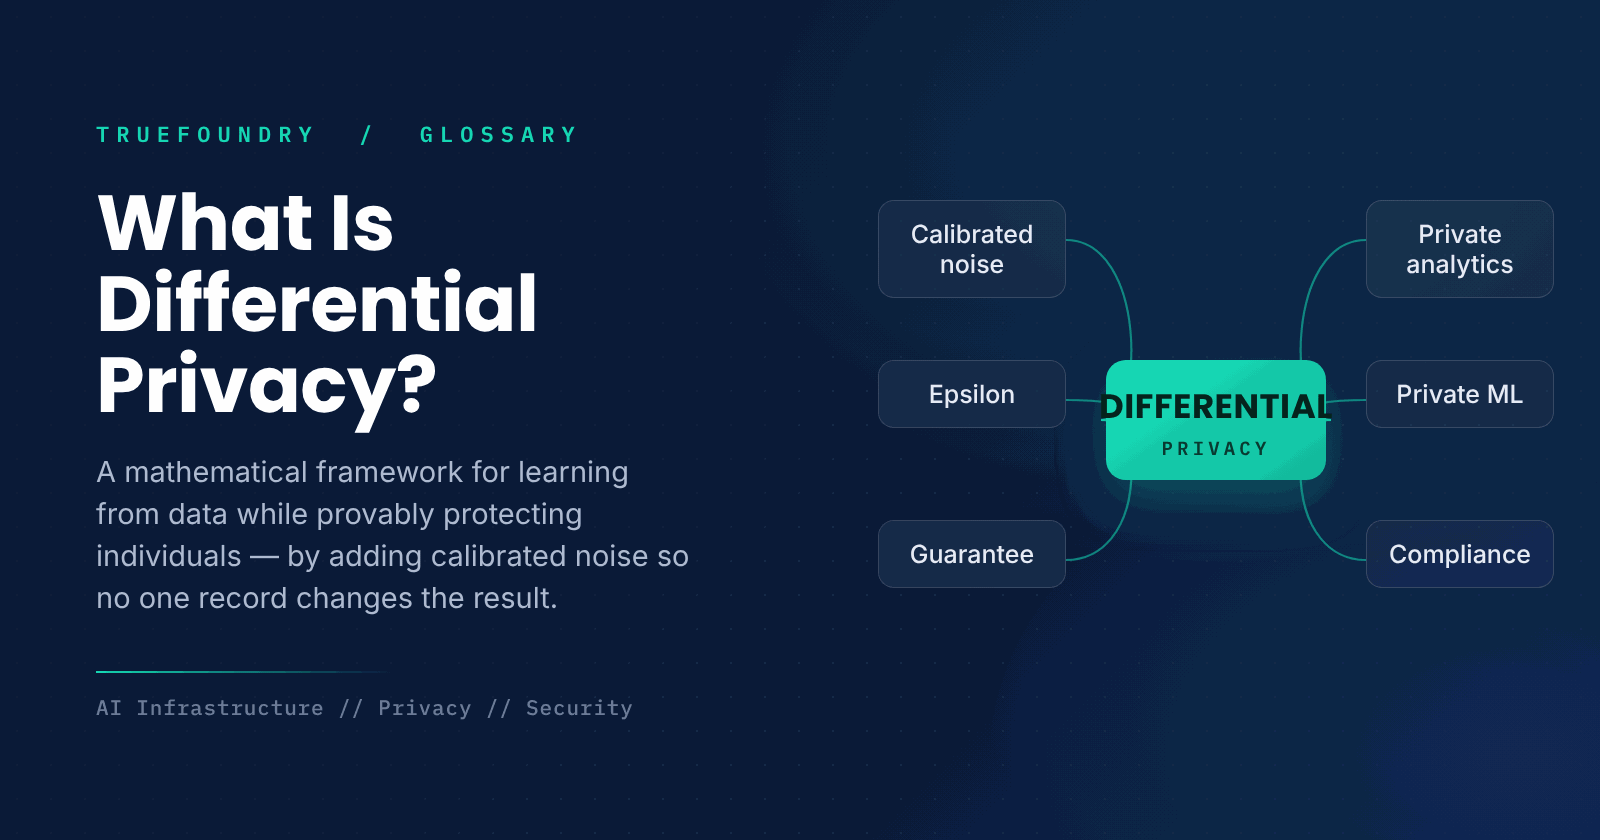
Organisaties willen leren van gegevens over mensen zonder die mensen bloot te stellen. Het probleem is dat zelfs geaggregeerde statistieken en getrainde modellen informatie over individuen kunnen lekken. Het simpelweg verwijderen van namen is niet voldoende, omdat andere details iemand opnieuw kunnen identificeren. Differential privacy biedt een rigoureus antwoord: een wiskundige garantie die beperkt in hoeverre de gegevens van één persoon invloed kunnen hebben op een resultaat, en daardoor via dat resultaat onthuld kunnen worden.
Differential privacy is geen specifiek hulpmiddel, maar een eigenschap die een proces kan hebben. Het wordt bereikt door een nauwkeurige hoeveelheid willekeurige ruis toe te voegen, zodat de aan- of afwezigheid van één individu de output nauwelijks verandert. Hierdoor kunnen organisaties statistieken publiceren of machine learning-modellen trainen op gevoelige data met een bewijsbare grens aan het privacyverlies.
Deze gids legt uit wat differential privacy is, hoe het werkt, hoe het zich verhoudt tot oudere anonimiseringstechnieken en wanneer je het moet gebruiken.
Wat is differential privacy?
Differential privacy is een formele definitie van privacy voor algoritmen die data analyseren. Een algoritme is 'differentially private' als de output statistisch gezien vrijwel hetzelfde is, ongeacht of het record van een specifiek individu wel of niet in de input is opgenomen. Die gelijkenis garandeert dat een waarnemer niet met zekerheid kan vaststellen of een bepaalde persoon in de dataset zat, en dus niet veel over die persoon kan leren uit het resultaat.
Zie het als het vervagen van een foto van een menigte, net genoeg zodat geen enkel gezicht herkenbaar is, terwijl het algemene beeld — hoeveel mensen er zijn en waar ze ongeveer staan — duidelijk blijft. Differential privacy vervaagt resultaten met gekalibreerde ruis, zodat individuele bijdragen verborgen blijven terwijl het geaggregeerde signaal behouden blijft.
Het kernidee is een bewijsbare, kwantificeerbare garantie. In tegenstelling tot ad-hoc anonimisering biedt differential privacy een wiskundige grens aan privacyverlies die standhoudt, ongeacht welke externe informatie een aanvaller bezit. Dat is wat het zo krachtig maakt.
Hoe werkt differential privacy?
Het voegt willekeurige ruis toe die is gekalibreerd op de mate waarin één individu het resultaat kan beïnvloeden, aangestuurd door een privacybudget.
- Meet de gevoeligheid. Bepaal in hoeverre de gegevens van één persoon de output kunnen veranderen.
- Stel een budget in. Kies epsilon, het privacybudget dat de sterkte van de garantie bepaalt.
- Voeg gekalibreerde ruis toe. Injecteer willekeurige ruis die is geschaald op basis van de gevoeligheid en het budget.
- Publiceer het resultaat. Deel de output met ruis, waardoor individuele bijdragen verborgen blijven.
- Houd het verbruik bij. Houd rekening met het privacybudget dat is verbruikt bij meerdere zoekopdrachten.
Het privacybudget, epsilon, is de centrale knop: een kleinere epsilon betekent meer ruis en een sterkere privacy, maar minder nauwkeurigheid, terwijl een grotere epsilon het tegenovergestelde betekent. Omdat elke query of trainingsrun een deel van het budget verbruikt, kan het totale privacyverlies over vele releases worden bijgehouden en begrensd.
Differentiële privacy versus traditionele anonimisering
Traditionele anonimisering verwijdert of maskeert identificerende velden zoals namen en ID's. Het probleem is dat de overblijvende kenmerken vaak kunnen worden gecombineerd met externe gegevens om personen opnieuw te identificeren, waardoor deze methoden geen harde garantie bieden. Differentiële privacy biedt daarentegen een wiskundige grens aan het privacyverlies die standhoudt, ongeacht wat een aanvaller weet, in plaats van te vertrouwen op het verbergen van specifieke velden.
De keerzijde is de nauwkeurigheid. Anonimisering laat exacte gegevens achter voor de records die overblijven, terwijl differentiële privacy bewust ruis toevoegt, waardoor de resultaten bij benadering zijn. In ruil daarvoor biedt het een garantie die anonimisering niet kan geven, en daarom heeft het de voorkeur wanneer sterke, bewijsbare privacy vereist is.
Waarom is differentiële privacy belangrijk?
- Bewijsbare privacy. Het biedt een wiskundige garantie, niet slechts een inspanningsverplichting.
- Robuustheid. De garantie blijft behouden, ongeacht de voorkennis van een aanvaller.
- Veilige analyses. Het stelt organisaties in staat om statistieken over gevoelige gegevens te delen.
- Private ML. Het maakt het mogelijk om modellen te trainen op gevoelige gegevens met beperkte datalekken.
- Naleving.Het ondersteunt sterke privacyclaims voor gereguleerde gegevens.
Wat zijn de afwegingen?
- Kosten voor nauwkeurigheid. Het toevoegen van ruis vermindert de precisie van de resultaten.
- Budgetlimieten. Elke query verbruikt privacybudget, wat het aantal query's dat je kunt uitvoeren beperkt.
- Optimalisatie.Het kiezen van epsilon brengt privacy in balans met bruikbaarheid en is niet eenvoudig.
- Complexiteit.Het correct implementeren ervan vereist zorgvuldigheid en expertise.
Wanneer moet je differential privacy gebruiken?
Gebruik het wanneer je gegevens over individuen moet analyseren of verwerken en hun privacy aantoonbaar moet beschermen, zoals bij het publiceren van statistieken over gevoelige populaties of het trainen van modellen op persoonsgegevens. Het is vooral waardevol wanneer de gegevens onderhevig zijn aan regelgeving of wanneer een sterke, verdedigbare privacygarantie vereist is.
Als je gegevens niet gevoelig zijn, of als geaggregeerde resultaten geen risico op heridentificatie met zich meebrengen, is het nauwkeurigheidsverlies van differential privacy mogelijk niet gerechtvaardigd. Het blinkt vooral uit in situaties waar de belangen bij het lekken van individuele informatie groot zijn en een wiskundige garantie de ruis waard is.
Kernpunten van differential privacy
- Het begrenst aantoonbaar wat er over een individu kan worden geleerd.
- Het voegt gekalibreerde ruis toe aan output of training.
- Epsilon, het privacybudget, stemt de balans tussen privacy en nauwkeurigheid af.
- De garantie blijft behouden, ongeacht de voorkennis van een aanvaller.
- Het maakt private analyses en privaat trainen van modellen mogelijk.
- Het ruilt enige nauwkeurigheid in voor aantoonbare privacy.
Conclusie
Differential privacy is een rigoureus raamwerk waarmee organisaties van gegevens kunnen leren terwijl ze de individuen daarin aantoonbaar beschermen, door gekalibreerde ruis toe te voegen zodat de gegevens van één persoon het resultaat niet wezenlijk veranderen. Aangestuurd door een privacybudget dat privacy afweegt tegen nauwkeurigheid, biedt het een garantie die traditionele anonimisering niet kan bieden. Daarom vormt het de basis voor private analyses en private machine learning op gevoelige gegevens.
TrueFoundry helpt teams bij het bouwen en implementeren van machine learning op hun eigen infrastructuur, inclusief workflows die gevoelige gegevens verwerken onder strikte privacyvereisten. Waar aantoonbare privacy van belang is, is differential privacy de standaard voor het leren van gegevens zonder de betrokken personen bloot te stellen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is differential privacy in simple terms?
It is a way to learn from data about people without revealing any individual. It adds a carefully measured amount of random noise so the result is almost the same whether or not any one person is included, which means no one can learn much about that person from it.
What is epsilon, the privacy budget?
Epsilon controls the strength of the privacy guarantee. A smaller epsilon adds more noise for stronger privacy but less accuracy; a larger epsilon does the reverse. Because each query spends budget, epsilon also caps how much total privacy loss you allow across releases.
How is differential privacy different from anonymization?
Anonymization removes identifying fields but can often be undone by combining other attributes with outside data. Differential privacy instead gives a mathematical bound on privacy loss that holds no matter what an attacker knows, at the cost of adding noise to results.
Does differential privacy hurt accuracy?
Yes, somewhat, because it deliberately adds noise. The amount depends on the privacy budget: stronger privacy means more noise and less precise results. The aggregate signal usually still comes through, but individual-level precision is intentionally reduced.
When should I use differential privacy?
When you need to analyze or train on data about individuals and must provably protect them, especially for regulated or sensitive data. If the data is not sensitive and results carry no re-identification risk, the accuracy cost may not be worth it.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


