


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is data drift en waarom is het belangrijk?

Een model leert de patronen in zijn trainingsgegevens en gaat ervan uit dat de gegevens die het later ziet er vergelijkbaar uitzien. Maar invoer verandert in de loop van de tijd: er komt een nieuw klantensegment bij, een sensor wordt opnieuw gekalibreerd, de typische waarden van een kenmerk verschuiven. Wanneer de productiegegevens niet langer lijken op de trainingsgegevens, begeeft het model zich op onbekend terrein. Die verschuiving is data drift.
Data drift is belangrijk omdat het vaak voorafgaat aan een daling van de modelprestaties. Door in de gaten te houden hoe invoerverdelingen veranderen, kunnen teams problemen vroegtijdig opsporen, soms nog voordat de nauwkeurigheid zichtbaar afneemt. Dit maakt drift-detectie een van de meest nuttige signalen bij productiemonitoring.
Deze gids legt uit wat data drift is, wat de oorzaken zijn, hoe het verschilt van concept drift en hoe je het kunt detecteren en aanpakken.
Wat is data drift?
Data drift is een verandering in de statistische verdeling van de invoergegevens van een model tussen de trainingsfase en de productiefase. De kenmerken die het model ontvangt, krijgen andere waarden, bereiken of frequenties dan tijdens de training, waardoor het model steeds vaker voorspellingen moet doen op basis van gegevens die niet lijken op wat het heeft geleerd.
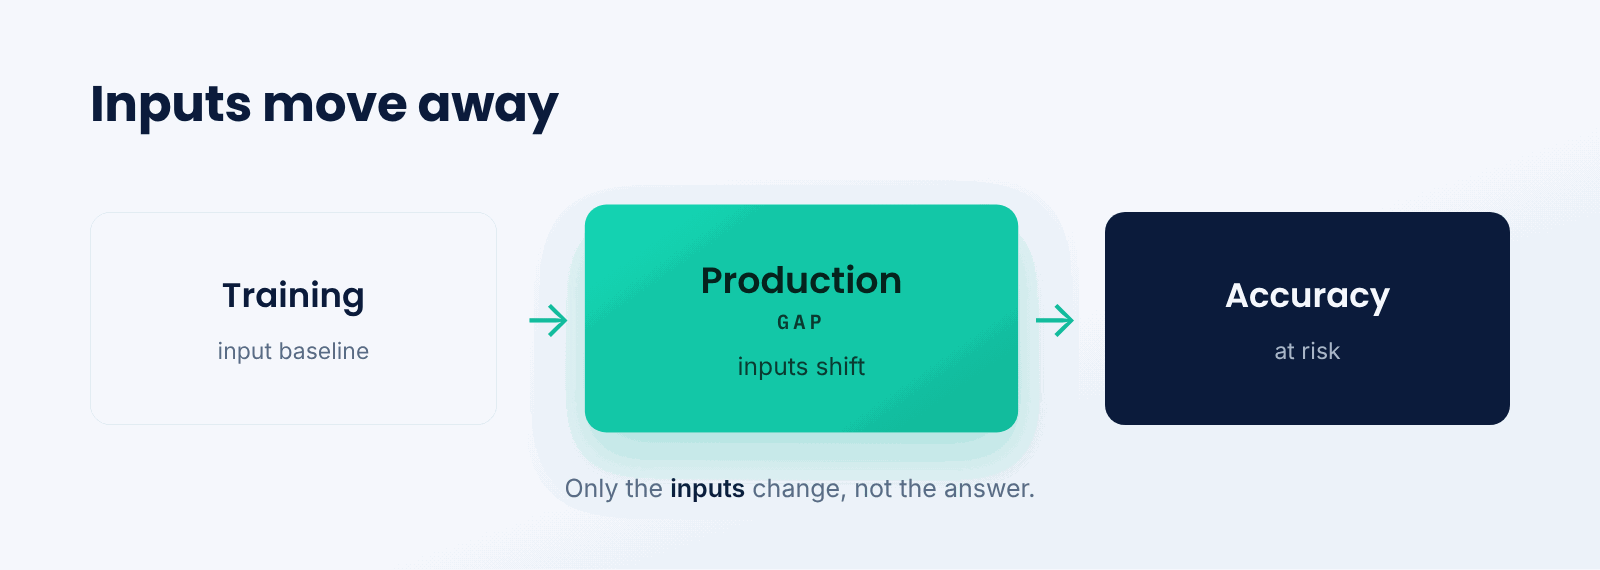
Zie het als een kleermaker die pakken maakt op basis van de maten van een bevolkingsgroep. Als het gemiddelde postuur van die groep geleidelijk verandert, passen de aannames van de kleermaker niet meer, ook al is zijn vakmanschap onveranderd. Een model is de kleermaker, de maten zijn de invoergegevens en data drift is de langzame verschuiving in die maten.
Het kernidee is dat alleen de invoer verandert, niet noodzakelijkerwijs het juiste antwoord. Zelfs als de werkelijke relatie tussen invoer en uitvoer nog steeds standhoudt, kan het voeden van het model met onbekende invoer het in gebieden duwen waar het nooit goed op getraind is, wat de nauwkeurigheid schaadt.
Wat veroorzaakt data drift?
Data drift heeft veel alledaagse oorzaken, meestal simpelweg omdat de wereld verandert.
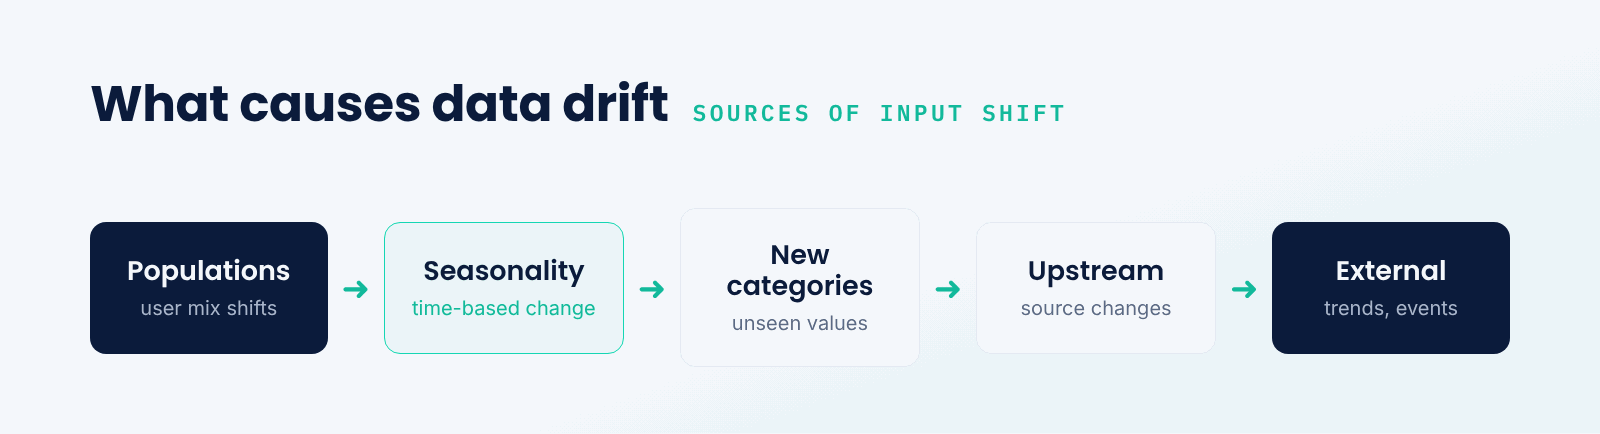
- Veranderende populaties. De samenstelling van gebruikers of items verschuift in de loop van de tijd.
- Seizoensinvloeden. Invoer varieert afhankelijk van het tijdstip van het jaar, de week of de dag.
- Nieuwe categorieën. Er verschijnen waarden of klassen die zeldzaam of afwezig waren tijdens de training.
- Upstream-wijzigingen. Een gegevensbron, sensor of pipeline verandert de manier waarop invoer wordt gegenereerd.
- Externe verschuivingen. Trends, gebeurtenissen of marktveranderingen veranderen de inkomende data.
Sommige hiervan zijn onschuldig en verwacht, zoals seizoensinvloeden, terwijl andere wijzen op een echt probleem, zoals een defecte upstream-pipeline. Het detecteren van drift is de eerste stap; het begrijpen van de oorzaak bepaalt of en hoe er gereageerd moet worden.
Data drift versus concept drift
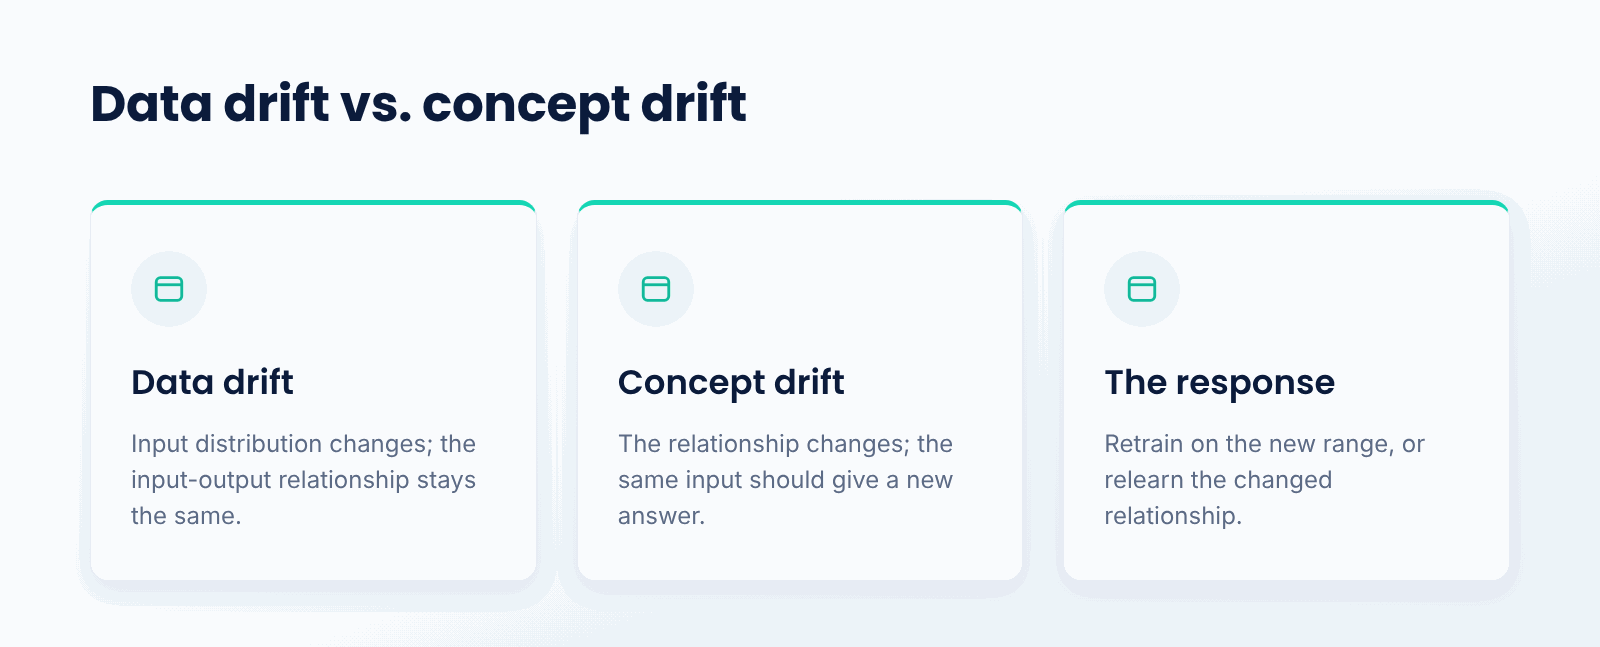
Dit zijn de twee belangrijkste soorten drift, en ze verschillen in wat er precies verandert. Data drift is een verandering in de inputdistributie; de inputs zien er anders uit, maar de relatie tussen de inputs en het doel blijft ongewijzigd. Concept drift is een verandering in die relatie zelf, waardoor dezelfde input nu een andere output zou moeten opleveren.
Dit onderscheid bepaalt de reactie. Data drift kan worden aangepakt door het model opnieuw te trainen op data die het nieuwe inputbereik dekt, terwijl concept drift betekent dat de aangeleerde relatie niet meer klopt en het model daadwerkelijk opnieuw moet leren. Beide verlagen de nauwkeurigheid, maar om verschillende onderliggende redenen.
Waarom is data drift belangrijk?
- Vroegtijdige waarschuwing. Het wijst vaak op problemen voordat de nauwkeurigheid zichtbaar afneemt.
- Nauwkeurigheid. Onbekende inputs dwingen het model buiten zijn getrainde bereik.
- Geen labels nodig. Inputdistributies kunnen worden gemonitord zonder te wachten op resultaten.
- Diagnose. Het helpt verklaren waarom de prestaties van een model veranderen.
- Betrouwbaarheid. Het tijdig signaleren houdt productiemodellen betrouwbaar.
Hoe detecteer en reageer je op data drift?
- Stel de trainingsdata vast als basislijn. Leg de distributie van elk inputkenmerk vast.
- Vergelijk in productie. Meet hoe huidige inputdistributies van elkaar verschillen.
- Gebruik statistische toetsen. Kwantificeer drift met afstands- of divergentiematen.
- Stel drempelwaarden in voor waarschuwingen. Markeer kenmerken waarvan de drift een limiet overschrijdt.
- Onderzoek en train opnieuw. Zoek de oorzaak en train opnieuw als de prestaties in gevaar zijn.
Wanneer moet je controleren op datadrift?
Monitor dit voor elk model in productie, vooral wanneer je resultaten niet direct kunt observeren. Omdat inputdistributies kunnen worden gecontroleerd zonder te wachten op ground-truth labels, biedt driftdetectie vaak het vroegste teken dat een model in de problemen kan komen.
Dit is vooral belangrijk in snel veranderende domeinen en in systemen waar labels langzaam of helemaal niet binnenkomen, aangezien inputmonitoring daar je belangrijkste vroege signaal kan zijn. Zelfs in stabiele omgevingen zijn periodieke driftcontroles een goedkope verzekering tegen stille modeldegradatie.
Kernpunten over datadrift
- Datadrift is een verschuiving in de distributie van de inputdata.
- Het vergelijkt productie-inputs met de trainingsbaseline.
- Het kan de nauwkeurigheid schaden, zelfs als de relaties ongewijzigd blijven.
- Het verschilt van conceptdrift, waarbij de relaties tussen input en output veranderen.
- Het kan zonder labels worden gedetecteerd, wat een vroege waarschuwing geeft.
- Reacties variëren van onderzoek tot hertraining.
Conclusie
Datadrift is een verschuiving in de distributie van de inputs die een model ontvangt in vergelijking met de trainingsdata, en het kan de nauwkeurigheid aantasten, zelfs wanneer de onderliggende relaties nog steeds standhouden. Omdat inputdistributies kunnen worden gemonitord zonder te wachten op resultaten, is driftdetectie een waardevol vroegtijdig waarschuwingssysteem dat aangeeft wanneer een model onderzoek of hertraining behoeft. Het is een essentieel onderdeel om productiemodellen betrouwbaar te houden.
TrueFoundry helpt teams bij het implementeren en monitoren van modellen op hun eigen infrastructuur, inclusief het volgen van inputdistributies om datadrift vroegtijdig op te sporen. Letten op drift is een van de meest praktische manieren om een geïmplementeerd model op de lange termijn betrouwbaar te houden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is data drift in simple terms?
It is when the distribution of inputs fed to a model diverges from the training dataset over its lifecycle. Input features evolve through time, so the model makes predictions on data it did not see during training, which can quietly degrade accuracy.
What causes data drift?
Routine variations within the environment: demographic shifts in users, seasonality effects, the emergence of novel data categories, alterations to an upstream data feed or sensor reading, and broader trend movements. All of these drive the input distribution apart from the training data.
How is data drift different from concept drift?
Data drift involves a shift in the input distribution, leaving the function mapping inputs to outputs unchanged. Concept drift is a modification in the input-output relationship, so the very same input should now generate a new output. Data drift changes the inputs; concept drift changes the rules.
How do you detect data drift?
You detect it by baselining the training data's input distributions and comparing them to production data over time, often through statistical distances or divergences. An alert triggers when a feature's distance crosses a threshold, flagging it for investigation.
Why monitor data drift if you can monitor accuracy?
Because accuracy requires ground-truth labels, which are often delayed or missing entirely. Input distributions can be monitored right away, so data drift is likely to flag a decline long before accuracy metrics can even provide evidence of degradation.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


