


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat zijn kosten per token en waarom zijn ze belangrijk?

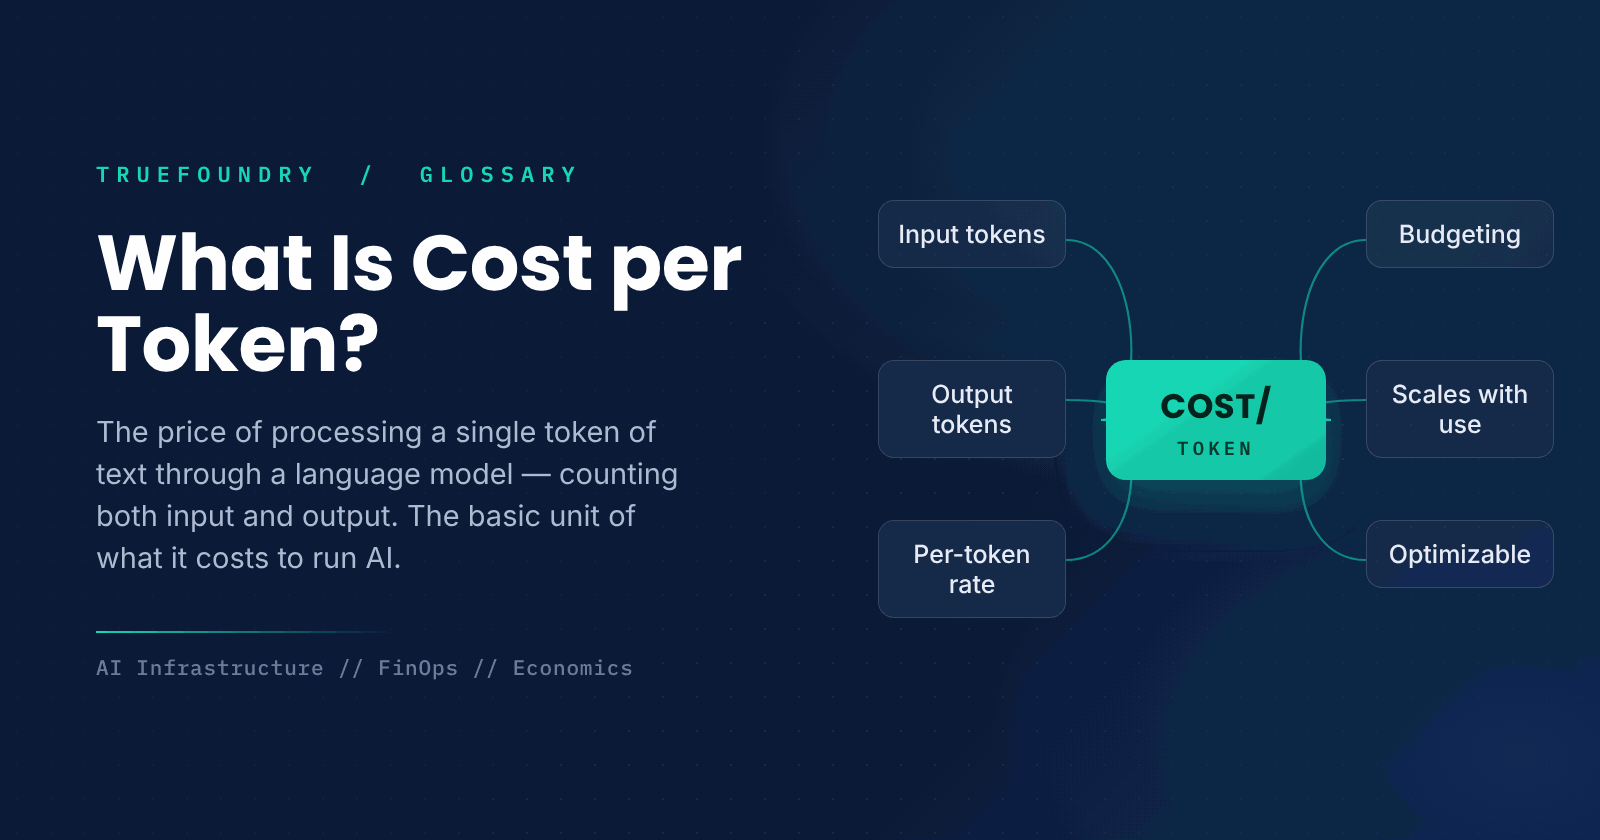
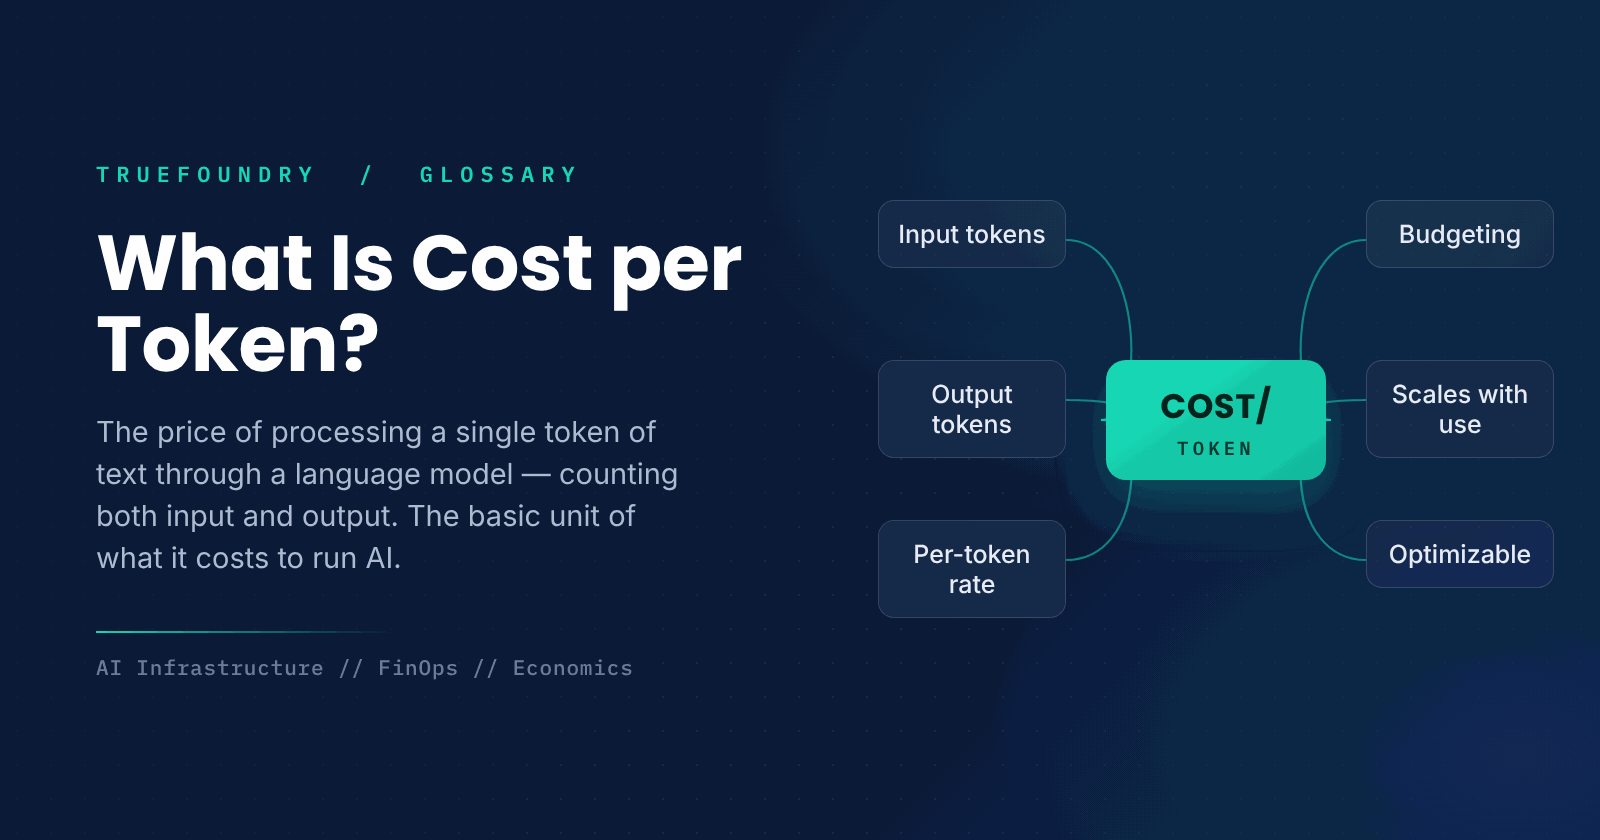
Taalmodellen rekenen niet per verzoek of per uur zoals veel andere diensten; ze rekenen per token, de kleine tekstfragmenten die ze lezen en schrijven. Elke prompt die je verstuurt en elk antwoord dat je terugkrijgt, wordt gemeten in tokens en je betaalt voor elk daarvan. Dat maakt de kosten per token de fundamentele eenheid voor de kosten van het draaien van een AI-applicatie.
Op kleine schaal is dit makkelijk over het hoofd te zien, maar naarmate het gebruik toeneemt, lopen de tokenkosten snel op en kunnen ze het budget van een AI-product gaan domineren. Begrijpen wat een token is, hoe input en output worden geprijsd en wat de totale kosten bepaalt, is essentieel om applicaties betaalbaar te houden. Deze gids legt uit wat kosten per token inhouden en hoe je deze kunt beheren.
We behandelen de definitie, hoe tokenkosten oplopen, hoe de prijzen voor input en output verschillen en hoe je deze kunt beheersen.
Wat zijn kosten per token?
Kosten per token is het bedrag dat in rekening wordt gebracht voor het verwerken van één token door een taalmodel. Een token is een klein stukje tekst, vaak ongeveer een paar tekens of een deel van een woord, en de prijs van een model wordt vermeld als kosten per aantal tokens. Zowel de tokens die je in de prompt verstuurt als de tokens die het model in zijn antwoord genereert, tellen mee voor wat je betaalt.
Zie het als een taximeter die oploopt op basis van afstand in plaats van per rit. Een korte rit kost weinig en een lange rit kost meer, allemaal tegen hetzelfde tarief per eenheid. Bij taalmodellen zijn de tokens de afstand: hoe meer tekst erin gaat en eruit komt, hoe meer je betaalt, tegen het tarief per token van het model.
Het kernidee is dat tekst wordt gefactureerd per token. Omdat alles wat een model leest en schrijft op deze manier wordt gemeten, zijn de kosten per token de maatstaf waarmee alle kosten voor AI-gebruik worden begrepen.
Hoe lopen tokenkosten op?
De totale kosten zijn het aantal gebruikte tokens vermenigvuldigd met het tarief per token, over elk verzoek heen.
- Tel de input. De prompt, context en eventuele geschiedenis worden omgezet in tokens.
- Tel de output. Het door het model gegenereerde antwoord wordt ook omgezet in tokens.
- Pas de tarieven toe. Input- en outputtokens worden elk per token geprijsd.
- Bereken het totaal per verzoek. Tel de input- en outputkosten voor één aanroep bij elkaar op.
- Vermenigvuldig met het volume. Bij veel verzoeken schaalt dit mee met het gebruik.
De kosten van een enkele aanvraag zijn laag, maar productiesystemen verwerken er miljoenen, waardoor zowel het tarief per token als het aantal tokens per aanvraag enorm belangrijk zijn. Lange prompts, grote contextvensters en uitgebreide output verhogen het aantal tokens en daarmee de kosten van elke aanroep.
Kosten voor input- versus output-tokens
De meeste aanbieders hanteren verschillende prijzen voor input- en output-tokens, waarbij output-tokens vaak duurder zijn omdat het genereren van tekst rekenkundig zwaarder is dan het lezen ervan. Een aanvraag die een lang antwoord genereert, kan daarom veel meer kosten dan de korte prompt zou doen vermoeden.
Dit onderscheid bepaalt hoe teams optimaliseren. Het inkorten van onnodige context verlaagt de inputkosten, terwijl het vragen om beknopte antwoorden de duurdere outputkosten drukt. Weten welke kant de overhand heeft in een bepaalde workload vertelt je waar je je op moet richten en is essentieel om uitgaven nauwkeurig in te schatten en te beheersen.
Waarom zijn de kosten per token belangrijk?
- Budgettering. Het vormt de basis voor het inschatten van AI-uitgaven.
- Schaal.Lage kosten per aanroep lopen bij grote volumes snel op.
- Optimalisatie. Het laat zien waar prompts en output kunnen worden ingekort.
- Modelkeuze. Het helpt bij het vergelijken van modellen op basis van kosten.
- Levensvatbaarheid. Het kan bepalend zijn voor de economische haalbaarheid van een product.
Hoe kun je de kosten per token beheren?
- Kort prompts in. Stuur alleen de context die het model daadwerkelijk nodig heeft.
- Beperk de output. Vraag om beknopte antwoorden en stel een lengtelimiet in.
- Kies modellen verstandig. Gebruik kleinere modellen waar deze volstaan.
- Cache en hergebruik. Voorkom dat dezelfde context herhaaldelijk wordt verzonden.
- Monitor het gebruik. Houd het aantal tokens per verzoek bij om verspilling op te sporen.
Wanneer moet je hierop letten?
Let op de kosten per token zodra je een taalmodeltoepassing op enige schaal gebruikt, zeker als deze veel gebruikers bedient of frequente aanroepen doet. Op dat moment worden tokenkosten een serieuze post op de begroting en kunnen kleine optimalisaties in de lengte van prompts en output leiden tot grote besparingen.
Bij incidenteel gebruik met een laag volume zijn de tokenkosten wellicht verwaarloosbaar en is optimalisatie niet nodig. Maar voor elk AI-systeem in productie is het begrijpen en beheren van de kosten per token essentieel om de economische haalbaarheid te waarborgen naarmate het gebruik groeit.
Kernpunten over kosten per token
- Kosten per token is de prijs voor het verwerken van één token.
- Zowel input- als outputtokens worden in rekening gebracht.
- Outputtokens kosten vaak meer dan inputtokens.
- De totale kosten schalen mee met het aantal tokens vermenigvuldigd met het volume.
- Het inkorten van prompts en output verlaagt de kosten.
- Het is cruciaal voor de economie van AI-producten.
Conclusie
Kosten per token vormen de fundamentele eenheid van wat het kost om een taalmodel te draaien, inclusief zowel de input die je verstuurt als de output die het genereert. Omdat modellen per token factureren, bepaalt dit cijfer de economie van elke AI-toepassing en kan het op grote schaal de begroting domineren. Door dit te begrijpen, prompts in te korten, output te beperken en modellen verstandig te kiezen, houden teams AI betaalbaar naarmate het gebruik toeneemt.
TrueFoundry helpt teams bij het implementeren en serveren van modellen op hun eigen infrastructuur, met inzicht in tokengebruik en kosten om AI-uitgaven onder controle te houden. Wanneer de economische kant van een AI-product ertoe doet, is het beheren van de kosten per token de plek waar besparingen worden behaald.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is cost per token in simple terms?
It is the cost of processing one tiny piece of text, known as a token, through a language model. You pay for both the tokens you send in your prompt and the tokens the model generates in its answer, so the more text goes in and out, the more you pay.
What is a token?
A token is a tiny piece of text, usually a couple of characters or part of a word, that a language model uses to read and write. Text is measured and charged in tokens, not words or characters, so token counts are what determine usage and cost.
Why do output tokens often cost more than input tokens?
Because creating text requires significantly more computing power than reading it. Most providers therefore price output tokens higher, which means a request with a long response can cost considerably more than its short prompt alone would suggest.
How can I reduce my cost per token usage?
Trim the prompt to just the context the model needs, request brief answers and cap their length, choose smaller models where they suffice, avoid re-sending the same context, and watch token usage per request to catch waste. Output length is often the biggest lever.
When does cost per token really matter?
At scale, particularly for applications with many users or frequent calls, where even a small cost per call adds up to a large bill. For sporadic, low-volume use it may be negligible, but for any production system it is central to the economics.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


