


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Continuous Batching en hoe werkt het?

LLM-inferentie genereert tekst token voor token, en verschillende verzoeken eindigen op verschillende lengtes. Bij traditionele statische batching groepeert de server een vaste set verzoeken, voert deze samen uit en kan pas nieuwe starten als de hele batch is voltooid. Hierdoor blijft de GPU deels inactief terwijl deze wacht op het langste verzoek. Continuous batching elimineert die verspilling.
Door de batch op het niveau van individuele tokens te beheren, kunnen verzoeken continu in- en uitstromen bij een lopende batch. De GPU blijft volledig benut met nuttig werk en de doorvoer stijgt aanzienlijk; daarom is dit een bepalende techniek geworden voor het efficiënt serveren van LLM's.
Deze gids legt uit wat continuous batching is, hoe het werkt, waarin het verschilt van statische batching en waarom het belangrijk is.
Wat is continuous batching?
Continuous batching, soms ook in-flight of dynamic batching genoemd, is een strategie voor het serveren van LLM's waarbij de set verzoeken die samen worden verwerkt bij elke generatiestap wordt bijgewerkt. Zodra een verzoek is voltooid, verlaat het de batch en neemt een wachtend verzoek de plaats in, zodat de batch continu wordt aangevuld in plaats van vast te staan voor de gehele duur.
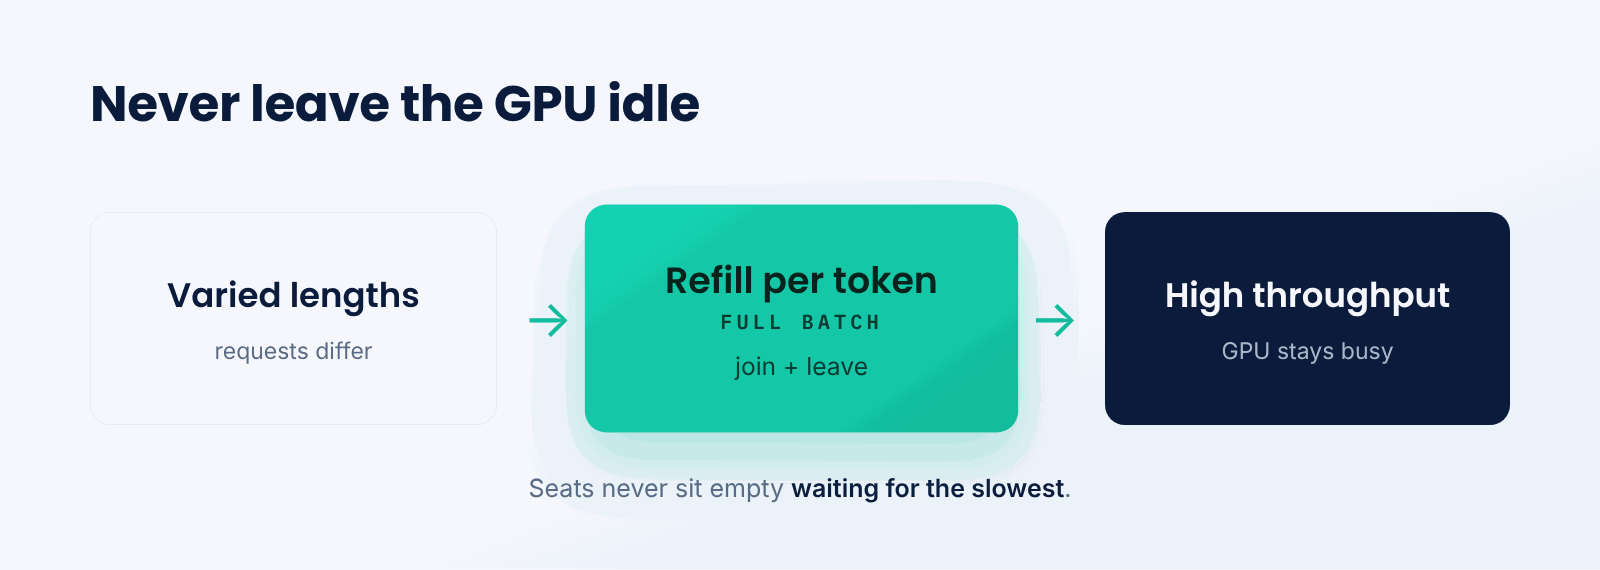
Zie het als een attractie waarbij mensen bij elke stop kunnen in- en uitstappen in plaats van te wachten tot iedereen een volledig rondje heeft voltooid. Stoelen blijven nooit leeg terwijl er op de langzaamste passagier wordt gewacht, waardoor de attractie veel meer mensen per uur kan vervoeren. Continuous batching houdt de stoelen van de GPU op dezelfde manier bezet.
Het kernidee is planning per token. Omdat de batch bij elke stap opnieuw wordt bekeken, hoeft de GPU zelden te wachten op een paar lange verzoeken terwijl andere verzoeken al uitgevoerd hadden kunnen worden.
Hoe werkt continuous batching?
Bij elke generatiestap verwerkt de server de batch, verwijdert voltooide verzoeken en voegt nieuwe toe.
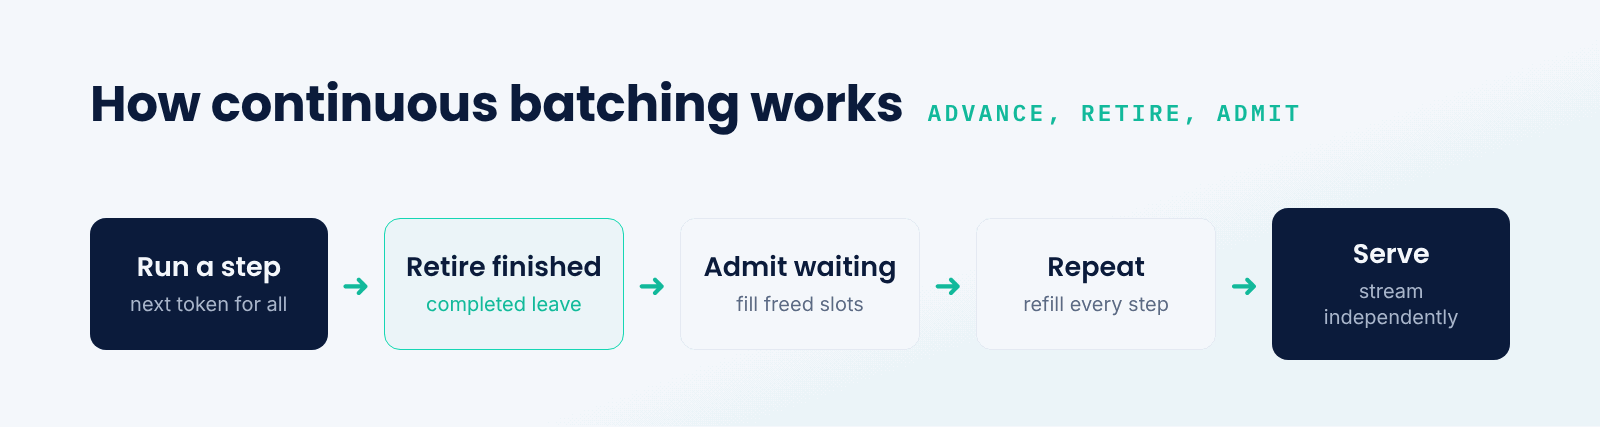
- Voer een stap uit. De engine genereert het volgende token voor elk verzoek in de batch.
- Verwijder voltooide verzoeken. Elk verzoek dat zojuist is voltooid, verlaat de batch.
- Voeg wachtende verzoeken toe. Wachtende verzoeken vullen de vrijgekomen plekken onmiddellijk op.
- Herhalen.De batch vordert token voor token en wordt continu aangevuld.
- Implementeer.Elk verzoek wordt tijdens het genereren gestreamd en eindigt onafhankelijk.
Omdat plekken bij elke stap vrijkomen en weer worden opgevuld, verwerkt de GPU bijna altijd een nagenoeg volle batch. Die constante bezettingsgraad, en niet een verandering aan het model zelf, is wat zorgt voor de winst in doorvoersnelheid.
Continue versus statische batching
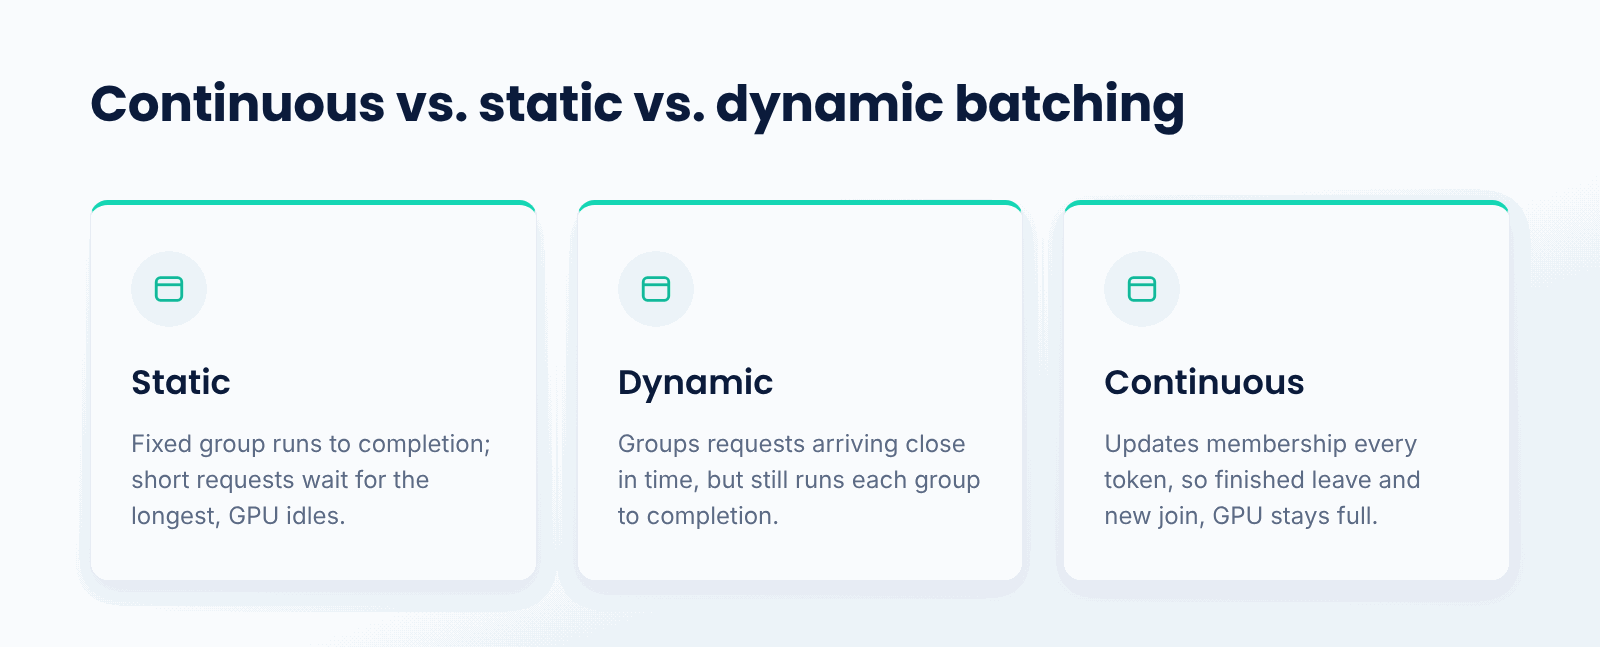
Het verschil tussen deze twee benaderingen zit in het moment waarop de batch wordt aangepast. Bij statische batching wordt een groep verzoeken vastgelegd en volledig afgehandeld voordat de volgende groep start; hierdoor moeten korte verzoeken wachten op de langste en blijft de GPU onbenut. Continuous batching werkt de samenstelling bij elk token bij, waardoor voltooide verzoeken direct vertrekken en nieuwe verzoeken direct aansluiten, wat de GPU constant aan het werk houdt. Dynamic batching vormt een middenweg: het groepeert verzoeken die kort na elkaar binnenkomen, maar verwerkt elke groep nog steeds in zijn geheel.
Het praktische verschil is aanzienlijk. Omdat de lengte van verzoeken bij LLM-workloads sterk varieert, verspilt statische batching veel GPU-tijd, terwijl continuous batching deze tijd benut, wat vaak leidt tot een hogere doorvoer op dezelfde hardware.
Waarom is continuous batching belangrijk?
- Hogere doorvoer.Door de GPU optimaal te benutten, kunnen er veel meer verzoeken per seconde worden verwerkt.
- Beter GPU-gebruik. Dure accelerators staan niet langer stil tussen verzoeken door.
- Lagere kosten per verzoek. Meer werk verzetten met dezelfde hardware verlaagt de kosten per eenheid.
- Soepelere latentie. Verzoeken hoeven niet te wachten tot een volledige batch is voltooid.
- Schaalbare verwerking. Het is essentieel voor LLM-inferentie op grote schaal.
Waar moet je rekening mee houden?
- Ondersteuning door de engine. Het vereist een serving engine die is ontworpen voor per-token scheduling.
- Geheugenbeheer. Het afhandelen van veel gelijktijdige verzoeken vereist een zorgvuldig gebruik van de KV-cache.
- Eerlijkheid. Bij scheduling moet een balans worden gevonden tussen doorvoer en de latentie van individuele verzoeken.
- Complexiteit.Dynamische planning is complexer dan statische batchverwerking.
Wanneer heb je continuous batching nodig?
Je hebt het nodig zodra je LLM-inferentie aanbiedt aan veel gelijktijdige gebruikers en je geeft om GPU-efficiëntie; dit geldt voor de meeste productieomgevingen. Hoe groter de variatie in verzoeklengtes en hoe hoger het volume, des te meer continuous batching de doorvoer verbetert en de kosten verlaagt.
Bij een enkel verzoek tegelijk of een zeer kleine werklast is het voordeel beperkt. Maar elke serieuze serveropstelling met gelijktijdig verkeer profiteert aanzienlijk, en daarom maken moderne inferentie-engines continuous batching tot de standaard.
Best practices voor continuous batching
- Gebruik een server-engine die continuous batching native ondersteunt.
- Combineer dit met efficiënt KV-cachebeheer voor gelijktijdige verzoeken.
- Stem de batchgrootte en planning af op je doelen voor latentie en doorvoer.
- Monitor het GPU-gebruik om te bevestigen dat de batch gevuld blijft.
- Combineer met autoscaling zodat de capaciteit aansluit bij de vraag.
- Breng voor interactieve apps een balans aan tussen doorvoer en latentie per verzoek.
Conclusie
Continuous batching werkt een LLM-inferentiebatch token voor token bij, waardoor verzoeken kunnen aansluiten bij en vertrekken uit een lopende batch in plaats van te wachten tot een vaste groep klaar is. Door de GPU bezig te houden in plaats van te laten wachten op ongelijke verzoeklengtes, wordt de doorvoer vermenigvuldigd en de kostprijs per verzoek op dezelfde hardware verlaagd. Het is een kerntechniek voor efficiënte LLM-serving op grote schaal.
TrueFoundry helpt teams bij het serveren van modellen met engines die gebruikmaken van continuous batching op hun eigen infrastructuur, waarbij GPU-gebruik en doorvoer op één plek inzichtelijk zijn. Naarmate de vraag naar inferentie groeit, is continuous batching essentieel om dit efficiënt te kunnen afhandelen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is continuous batching in simple terms?
It is building an LLM inference batch that changes every token: as soon as one request is completed, a waiting one takes its place. This way the GPU does not waste time idly waiting for the slowest request in a fixed batch.
How is continuous batching different from static batching?
Static batching runs a fixed group of requests to completion before starting the next, so short requests wait for the longest while the GPU idles. Continuous batching updates the batch every step, so finished requests leave and new ones join immediately.
Why does continuous batching increase throughput?
Because it keeps the GPU handling a nearly full batch almost all the time. Request lengths vary a lot, so static batching wastes GPU time waiting; continuous batching recovers that time, often multiplying the requests served per second.
Does continuous batching change the model's output?
No. It changes how requests are scheduled on the GPU, not how the model computes each token. Every request yields an identical output; it is simply served more efficiently alongside others.
What is needed to use continuous batching?
A serving engine designed for per-token scheduling and careful memory management, especially of the KV cache, to handle many concurrent requests. Most modern LLM inference engines support it by default.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


