


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is chunking en hoe werkt het?

Een taalmodel kan niet een hele kennisbank tegelijk lezen, en een ophaalsysteem kan niet nuttig zoeken in één gigantische brok tekst. Beide hebben materiaal nodig dat is opgedeeld in kleinere, betekenisvolle stukken. Chunking is die stap, en hoewel het triviaal klinkt, bepaalt het in stilte hoe goed een ophaalsysteem de juiste informatie vindt.
Splits een document op de verkeerde manier en een enkel idee wordt doormidden gesneden, of ongerelateerde onderwerpen worden op een hoop gegooid, waardoor het ophaalsysteem stukken teruggeeft die de vraag niet echt beantwoorden. Splits het goed en elke chunk is een samenhangende eenheid die gevonden en gebruikt kan worden. Daarom is chunking een van de belangrijkste en meest onderschatte onderdelen van een RAG-pipeline.
Deze gids legt uit wat chunking is, hoe het werkt, wat de belangrijkste strategieën zijn en hoe je het goed aanpakt.
Wat is chunking?
Chunking is het proces waarbij een lang document wordt verdeeld in kleinere segmenten, chunks genaamd, die elk onafhankelijk kunnen worden geëmbed, opgeslagen en opgehaald. Elke chunk is bedoeld als een op zichzelf staand stuk tekst, groot genoeg om betekenis over te dragen, maar klein genoeg om nauwkeurig te zijn en in de context van een model naast andere chunks te passen.
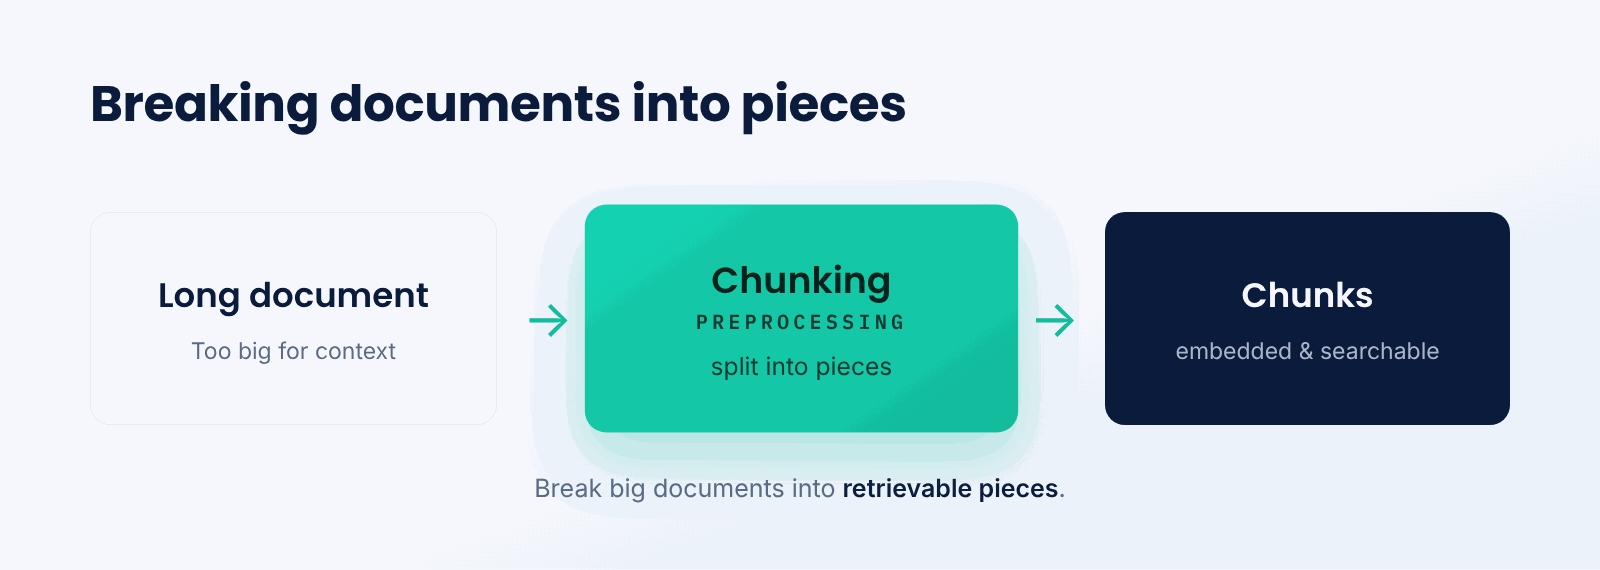
Denk aan het opdelen van een dik boek in indexkaarten. Eén enorme kaart is nutteloos om iets in te vinden, en kaarten die midden in een zin zijn afgesneden, zijn verwarrend. Het doel is kaarten die elk één samenhangend idee bevatten, zodat je snel de paar kaarten kunt pakken die een vraag beantwoorden. Chunking is het maken van die kaarten van je documenten.
Het belangrijkste punt is dat chunks de eenheid van ophalen zijn. Het model ziet nooit het hele document; het ziet de chunks die zijn opgehaald, dus de manier waarop je ze vormt, bepaalt waar het model mee kan werken.
Hoe werkt chunking?
Chunking is de eerste fase van het voorbereiden van documenten voor ophalen.
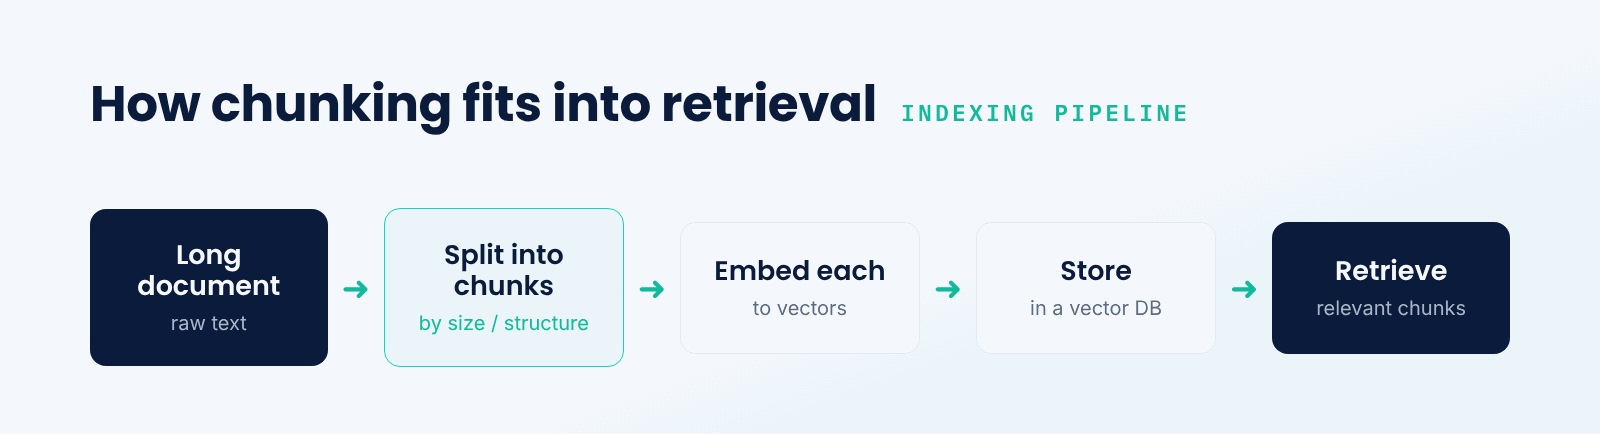
- Begin met het document. Een lang stuk tekst, zoals een handleiding, artikel of transcript, is de input.
- Splits in chunks. De tekst wordt op basis van grootte, structuur of betekenis verdeeld in kleinere segmenten, vaak met enige overlap.
- Embed elke chunk. Een embedding-model zet elke chunk om in een vector die de betekenis ervan vastlegt.
- Sla de chunks op. De vectoren en de bijbehorende tekst worden opgeslagen in een vectordatabase voor zoekopdrachten.
- Ophalen tijdens de query. Wanneer er een vraag binnenkomt, worden de meest relevante chunks opgehaald en doorgegeven aan het model.
Overlap tussen chunks, waarbij een klein stukje tekst bij de grenzen wordt herhaald, helpt voorkomen dat een idee middenin wordt afgekapt. De juiste chunk-grootte en overlap hangen af van de inhoud en worden meestal door testen bepaald.
Vaste grootte vs. semantische vs. recursieve chunking
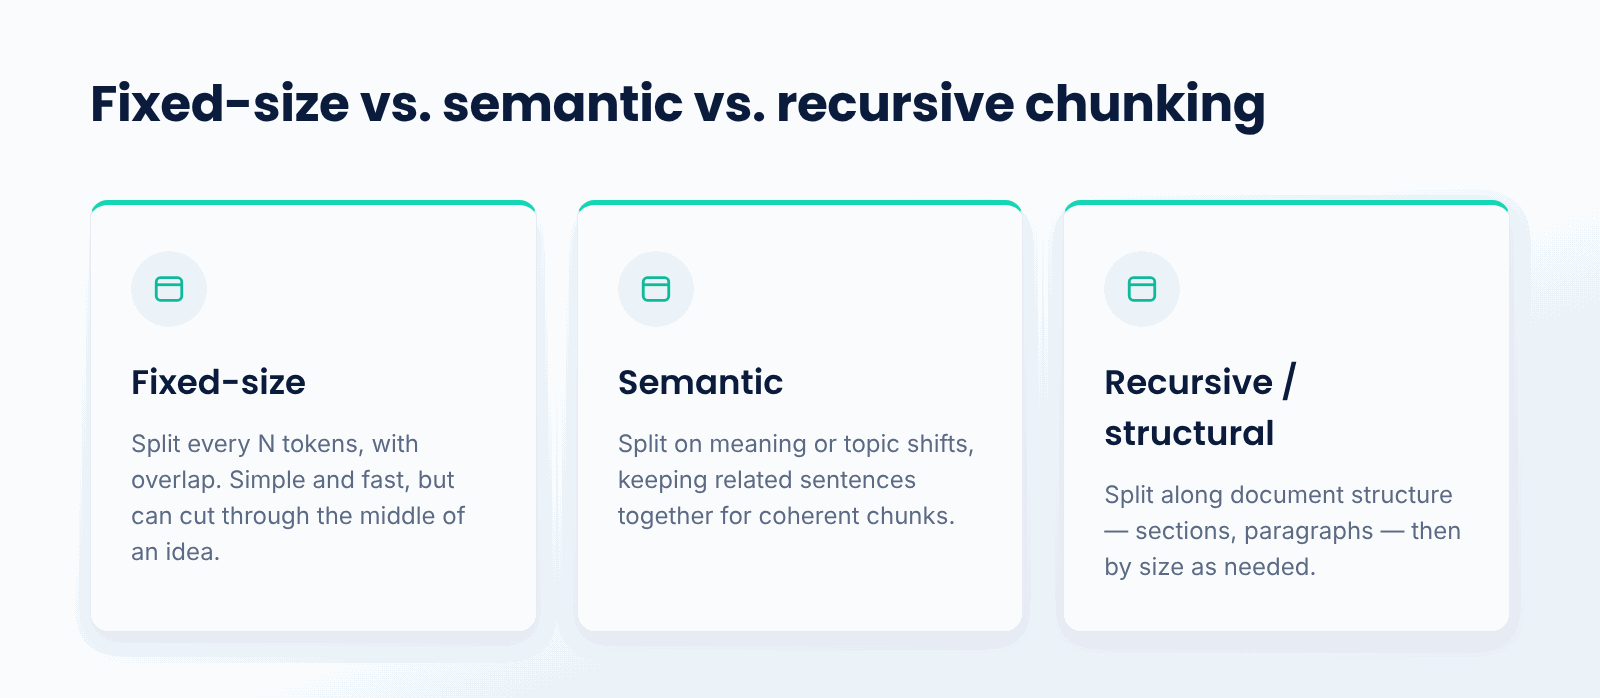
Er zijn een paar hoofdstrategieën. Chunking met een vaste grootte splitst de tekst elke N tokens met enige overlap; dit is eenvoudig en snel, maar kan een idee middenin doormidden snijden. Semantische chunking splitst op basis van betekenis, houdt gerelateerde zinnen bij elkaar en breekt bij onderwerpverschuivingen, wat coherentere chunks oplevert tegen hogere kosten. Recursieve of structurele chunking splitst langs de eigen structuur van het document, eerst op secties en alinea's, en daarna op grootte indien nodig, wat de natuurlijke grenzen van de tekst respecteert.
In de praktijk zijn structurele en semantische benaderingen meestal beter dan naïeve splitsing op vaste grootte, maar ze vergen meer werk. De juiste keuze hangt af van hoe gestructureerd je documenten zijn en hoe belangrijk de kwaliteit van de zoekresultaten is.
Waarom is chunking belangrijk?
- Kwaliteit van ophalen.Coherente chunks zijn makkelijker te matchen met een zoekopdracht, zodat de juiste informatie wordt gevonden.
- Precisie. Kleinere chunks leveren gerichte resultaten op in plaats van het antwoord te begraven in irrelevante tekst.
- Contextuele aansluiting. Chunks met de juiste grootte zorgen ervoor dat verschillende relevante fragmenten in het venster van het model passen.
- Onderbouwing. Betere retrieval betekent dat het model antwoordt op basis van de juiste bron, wat hallucinaties vermindert.
- Kosten.Het ophalen van compacte, relevante chunks in plaats van hele documenten bespaart tokens en geld.
Wat zijn de valkuilen?
- Chunks te groot. Grote chunks verwateren de relevantie en verspillen context aan irrelevante tekst.
- Chunks te klein. Hele kleine chunks verliezen de omliggende context die nodig is om het begrijpelijk te maken.
- Slechte grenzen. Splitsen midden in een idee levert chunks op die moeilijk te matchen en te gebruiken zijn.
- Eén maat voor alles. Verschillende documenttypen vereisen vaak verschillende chunking-strategieën.
Wanneer moet je je druk maken over chunking?
Je moet je druk maken over chunking zodra je een retrieval-systeem of RAG-pipeline bouwt voor je eigen documenten. Omdat de kwaliteit van de retrieval hiervan afhangt, is het afstemmen van de chunk-grootte, overlap en strategie een van de meest effectieve manieren om antwoorden te verbeteren.
Als je geen retrieval gebruikt, is chunking niet van toepassing. Maar voor elk systeem dat een kennisbank doorzoekt om een model te onderbouwen, is de manier waarop je chunkt een beslissing die je beter weloverwogen kunt nemen in plaats van op de standaardinstellingen te vertrouwen.
Best practices voor chunking
- Splits langs natuurlijke grenzen, zoals alinea's en secties, voordat je terugvalt op vaste groottes.
- Voeg een kleine overlap toe tussen chunks zodat ideeën niet middenin worden afgekapt.
- Stem de chunk-grootte af op je inhoud en test de retrieval-kwaliteit, in plaats van één keer te gokken.
- Houd gerelateerde metadata, zoals de bron en sectie, bij elke chunk voor filtering en citatie.
- Stem de strategie af op het documenttype in plaats van overal dezelfde aanpak te gebruiken.
- Meet de retrieval-kwaliteit van begin tot eind, aangezien chunking alleen nuttig is als het de antwoorden verbetert.
Conclusie
Chunking splitst lange documenten in kleinere, coherente stukken zodat ze kunnen worden geëncodeerd, opgehaald en aan een model kunnen worden gevoerd. Omdat chunks de eenheid van retrieval zijn, bepaalt de manier waarop je ze vormt – hun grootte, overlap en grenzen – direct hoe goed een RAG-systeem de juiste informatie vindt en gebruikt. Het is een fundamentele en vaak onderschatte stap bij het bouwen van retrieval-systemen.
TrueFoundry helpt teams bij het bouwen en aanbieden van retrieval-augmented systemen op hun eigen infrastructuur, waarbij embedding, retrieval en generatie op één plek achter een gateway worden beheerd. Welk model er ook aan het einde van de pipeline staat, goede chunking aan de bron is grotendeels bepalend voor de nauwkeurigheid en onderbouwing van de antwoorden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is chunking in simple terms?
It involves splitting a document into smaller chunks so each can be embedded, searched, and fed to the model. The model does not read the entire document, only the retrieved chunks, so how you split matters.
What is a good chunk size?
It depends on the content, but chunks are typically several hundred tokens long — big enough to contain a meaningful idea but small enough not to become imprecise. The best size is determined by experimenting with retrieval results on your own documents.
What is chunk overlap?
Overlap repeats a small bit of text at the boundary of each chunk so an idea is not divided into two pieces. It allows retrieval of complete ideas rather than fragmented ones.
What is the best chunking strategy?
There is no single best approach. Chunking based on structure or semantics — dividing by the document's structure or its meaning — generally performs better than naive fixed-size approaches, but it requires additional resources. The right choice depends on your documents and how much quality matters.
Why does chunking affect RAG quality?
Because chunks are precisely what a search looks for and retrieves. The better organized and sized the chunks are, the easier it is to match them to a query and provide focused context, while poor chunks retrieve irrelevant fragments.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


