


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Chain-of-Thought Prompting en hoe werkt het?

Stel een model een moeilijke vraag met meerdere stappen en eis een direct antwoord, en het kiest vaak voor de eerste de beste weg die in hem opkomt, wat meestal fout is. Vraag het om het probleem eerst uit te werken, en de nauwkeurigheid schiet omhoog. Die simpele verandering, het model aanzetten tot redeneren voordat het antwoordt, is chain-of-thought prompting.
Het blijkt dat modellen, net als mensen, beter presteren bij moeilijke problemen als ze hun werkwijze laten zien. Het genereren van tussenstappen geeft het model de ruimte om een probleem op te splitsen, overzicht te houden en eigen fouten te corrigeren voordat het tot een definitief antwoord komt.
Deze gids legt uit wat chain-of-thought prompting is, hoe het werkt, hoe het zich verhoudt tot redenerende modellen en wanneer je het moet gebruiken.
Wat is chain-of-thought prompting?
Chain-of-thought prompting is een techniek waarbij een taalmodel wordt gevraagd om een reeks tussenliggende redeneerstappen te genereren voordat het definitieve antwoord wordt gegeven. In plaats van een vraag direct naar een antwoord te vertalen, schrijft het model de stappen op die nodig zijn om daar te komen, wat de prestaties bij problemen die redenering vereisen verbetert.
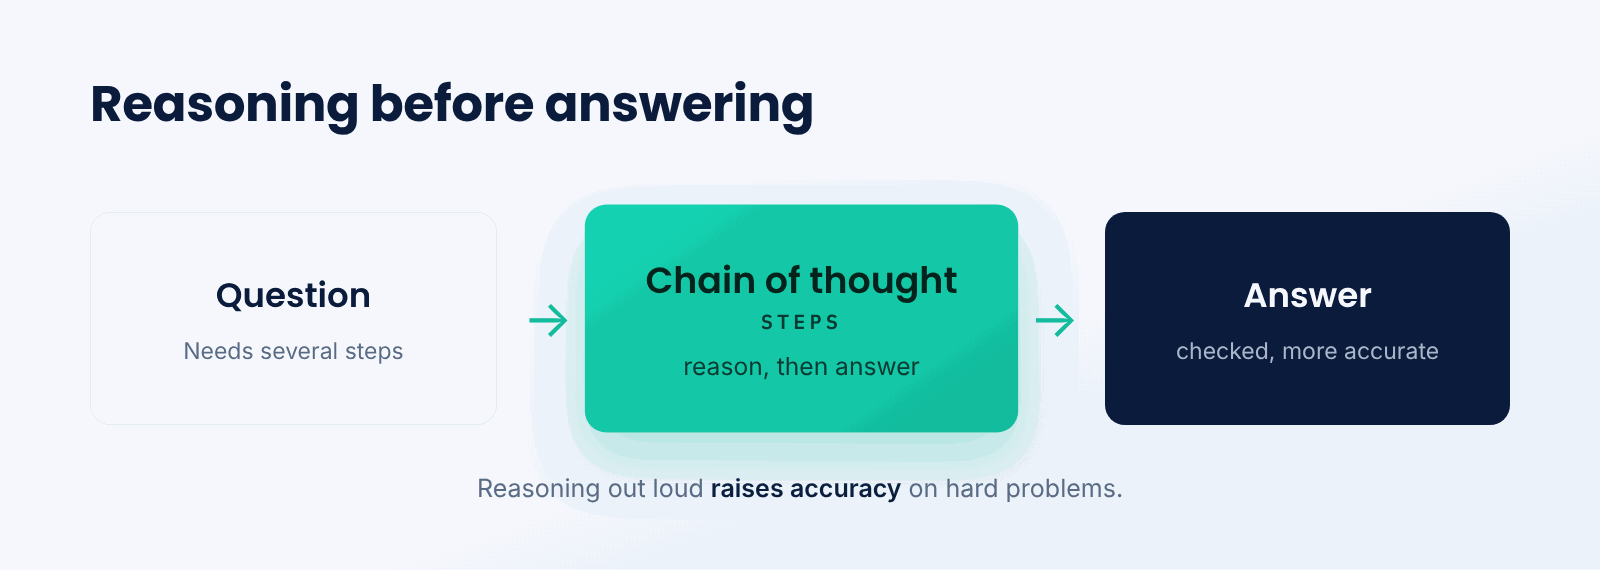
Denk aan het oplossen van een wiskundig probleem in je hoofd versus op papier. In je hoofd is het makkelijk om het overzicht te verliezen en een fout te maken. Op papier wordt elke stap opgeschreven, gecontroleerd en verder uitgebouwd, waardoor de kans op een juist eindantwoord veel groter is. Chain-of-thought geeft het model dat papier om op te werken.
Het belangrijkste inzicht is dat redeneren ruimte kost. Door het model tokens te laten gebruiken om na te denken, geef je het de ruimte om een probleem uit te werken in plaats van te gokken naar het antwoord.
Hoe werkt chain-of-thought prompting?
De techniek is vaak zo simpel als het toevoegen van een aanwijzing die uitnodigt tot stapsgewijs redeneren.
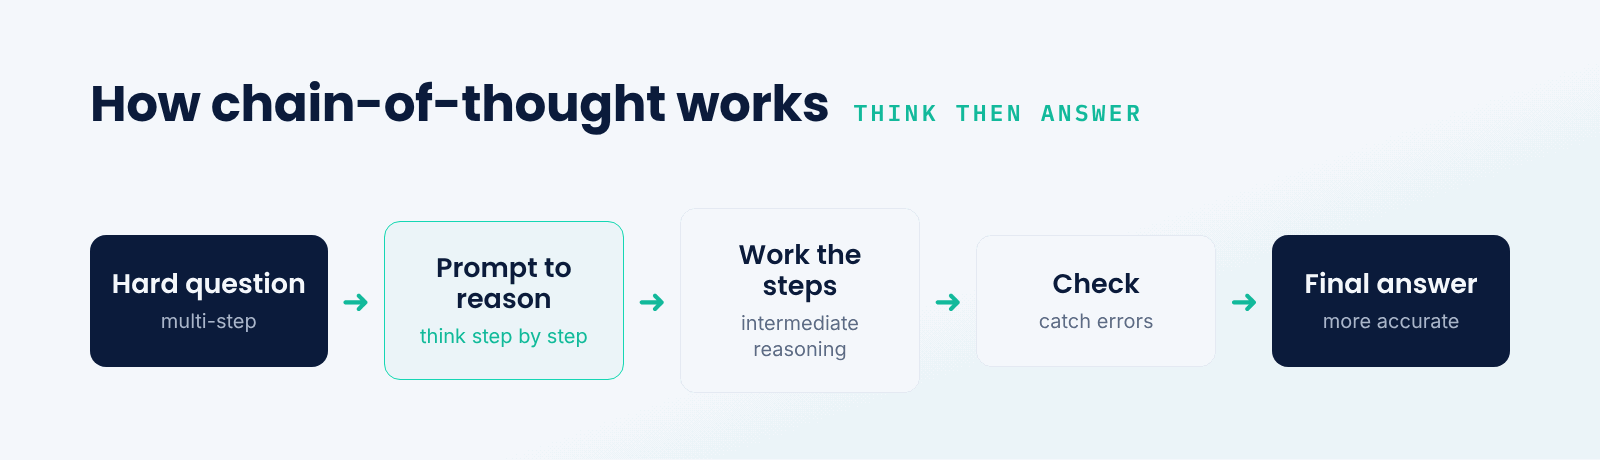
- Stel het probleem. Een vraag die uit meerdere stappen bestaat, wordt aan het model voorgelegd.
- Vraag om redenering. Een aanwijzing zoals laten we stap voor stap nadenken nodigt het model uit om eerst te redeneren.
- Werk de stappen uit. Het model genereert een tussenliggende redenering en breekt het probleem op in delen.
- Controleer gaandeweg. Door stappen uit te schrijven kan het model fouten tijdens het redeneren opmerken en corrigeren.
- Geef het definitieve antwoord. Na de redenering geeft het model het antwoord, dat nu een grotere kans heeft om correct te zijn.
Een gerelateerde variant, few-shot chain-of-thought, bevat uitgewerkte voorbeelden in de prompt die de redenering voor soortgelijke problemen laten zien, wat het model het te volgen patroon aanleert. Hoe dan ook, de winst komt voort uit het genereren van de stappen, niet alleen het antwoord.
Chain-of-thought versus directe prompting en redeneermodellen
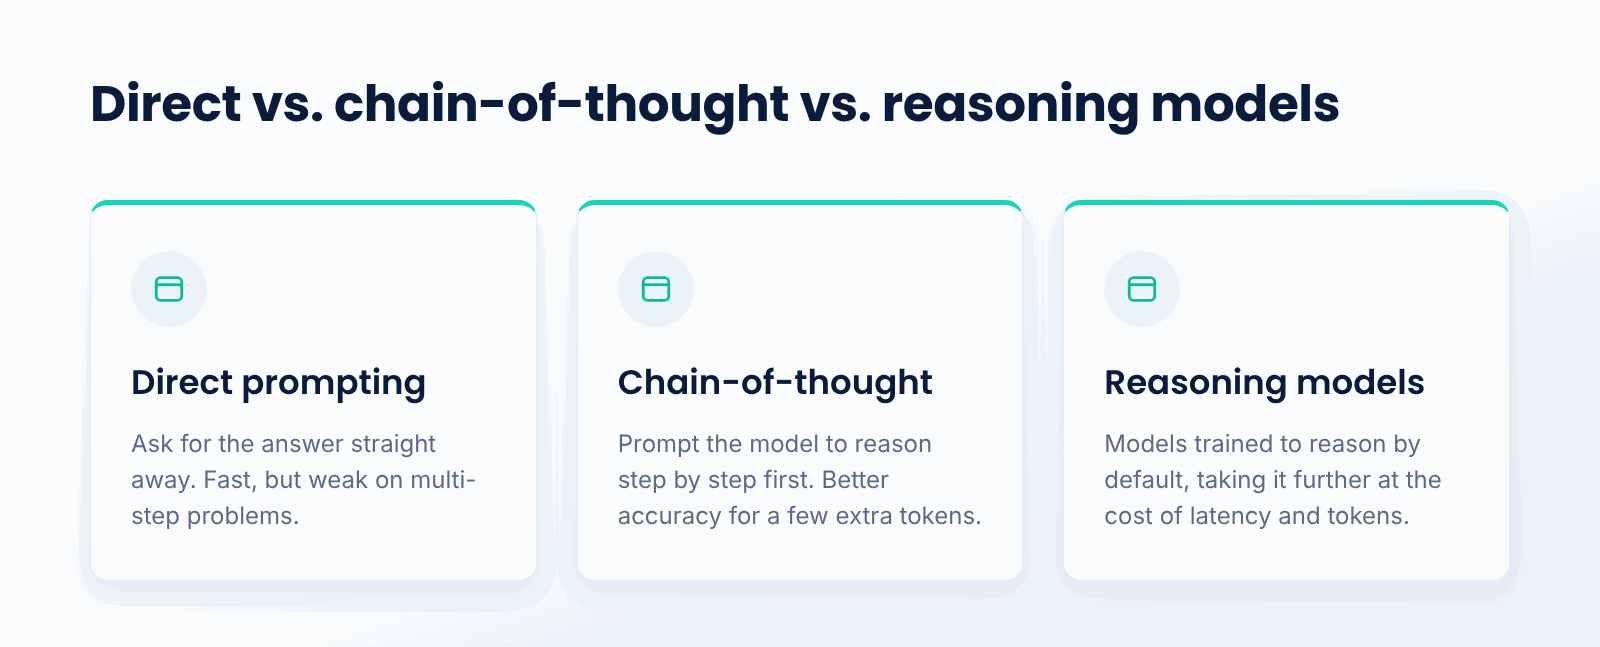
Deze bevinden zich op een spectrum van hoeveel een model nadenkt. Directe prompting vraagt direct om het antwoord, wat snel is en prima voor eenvoudige taken, maar zwak bij problemen met meerdere stappen. Chain-of-thought prompting voegt expliciete redenering toe via de prompt, wat de nauwkeurigheid verbetert voor een paar extra tokens. Redeneermodellen gaan nog een stap verder: ze zijn standaard getraind om te redeneren en besteden aanzienlijke rekenkracht aan het denkproces, wat de nauwkeurigheid nog verder verhoogt ten koste van latentie en tokens.
In de praktijk is chain-of-thought prompting een goedkope manier om veel van de voordelen van redeneren te behalen met een standaardmodel. Specifieke redeneermodellen zijn de moeite waard wanneer een probleem complex genoeg is om de extra kosten te rechtvaardigen.
Wat zijn de voordelen van chain-of-thought prompting?
- Hogere nauwkeurigheid. Stapsgewijs redeneren verbetert de prestaties bij wiskundige, logische en meerstaps-taken.
- Zelfcorrectie. Door stappen uit te schrijven kan het model fouten opmerken vóór het uiteindelijke antwoord.
- Transparantie.De zichtbare redenering laat zien hoe het model tot zijn conclusie is gekomen.
- Goedkoop toe te passen. Het vereist vaak slechts een korte aanwijzing in de prompt, zonder dat er training nodig is.
- Betere structuur. Redeneren leidt meestal tot meer georganiseerde en consistente antwoorden.
Wat zijn de beperkingen?
- Meer tokens. Het genereren van redeneringen kost extra tokens en zorgt voor iets meer latentie.
- Overbodig voor eenvoudige taken. Bij simpele vragen voegt het redeneren kosten toe zonder het antwoord te verbeteren.
- Geen garantie.Redeneren vermindert fouten, maar kan nog steeds tot een verkeerde conclusie leiden.
- Zichtbare redenering. Als de redenering aan gebruikers wordt getoond, kan deze meer onthullen dan je bedoelt.
Wanneer moet je chain-of-thought prompting gebruiken?
Gebruik het wanneer een taak uit meerdere stappen bestaat of zorgvuldig redeneren vereist: wiskunde, logische puzzels, planning, het debuggen van code of elke vraag waarbij het antwoord afhangt van een reeks deducties. In deze gevallen rechtvaardigt de nauwkeurigheidswinst de extra tokens ruimschoots.
Sla het over bij eenvoudige opzoekingen, classificaties of korte feitelijke antwoorden, waarbij redeneren kosten toevoegt zonder voordeel. Veel teams passen chain-of-thought selectief toe en activeren het alleen voor verzoeken die complex genoeg zijn om het nodig te hebben.
Best practices voor chain-of-thought prompting
- Gebruik een duidelijke aanwijzing zoals "denk stap voor stap" om redenering bij complexe problemen te activeren.
- Geef uitgewerkte voorbeelden voor complexe taken, zodat het model het redeneerpatroon leert.
- Reserveer het voor problemen die daadwerkelijk meerdere stappen vereisen, niet voor elk verzoek.
- Verberg de redenering voor eindgebruikers wanneer alleen het uiteindelijke antwoord getoond moet worden.
- Houd in je kosten- en latentieschattingen rekening met de extra tokens die de redenering genereert.
- Stuur complexe verzoeken via een gateway door naar chain-of-thought of een redeneermodel.
Conclusie
Chain-of-thought prompting verbetert de nauwkeurigheid van een model door het te vragen stap voor stap na te denken voordat het antwoordt. Door tussenstappen te genereren, kan het model moeilijke problemen opbreken, eigen fouten corrigeren en tot betere antwoorden komen, en dat voor de kosten van slechts een paar extra tokens. Het is een van de eenvoudigste en meest effectieve prompting-technieken voor taken die echt redeneervermogen vereisen.
Met de AI Gateway van TrueFoundry kunnen teams verzoeken die veel redeneervermogen vereisen naar het juiste model sturen en de tokencosten van technieken zoals chain-of-thought bijhouden, naast caching en observability in één laag. Voor elke werklast die redeneren in meerdere stappen vereist, is het model vragen om na te denken een kleine aanpassing met een groot resultaat.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is chain-of-thought prompting in simple terms?
It involves making the model solve a problem in steps and give the answer after completing all of them. This helps the model accurately solve difficult problems that require several steps.
How do you trigger chain-of-thought?
Usually by providing a simple cue such as think step by step along with the prompt, or by adding some worked examples that illustrate the thought process for solving related questions. Both invite the model to reason first.
Does chain-of-thought always help?
No, not always. It helps solve complex problems that involve a lot of thinking, such as mathematical or logical ones. For simple problems it just increases the number of tokens and adds latency, so it is best used selectively.
Is chain-of-thought the same as a reasoning model?
No. Chain-of-thought is an approach applied to a regular model. Reasoning models are trained to reason by default and use a lot more computation on that. Chain-of-thought is the cheaper option for achieving similar results.
Does chain-of-thought cost more?
A little bit. It creates additional reasoning tokens before the answer, which carries some overhead and delay. The value is normally not there on simple questions but certainly is on difficult ones.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


