


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is catastrofale vergetelheid en waarom is het belangrijk?

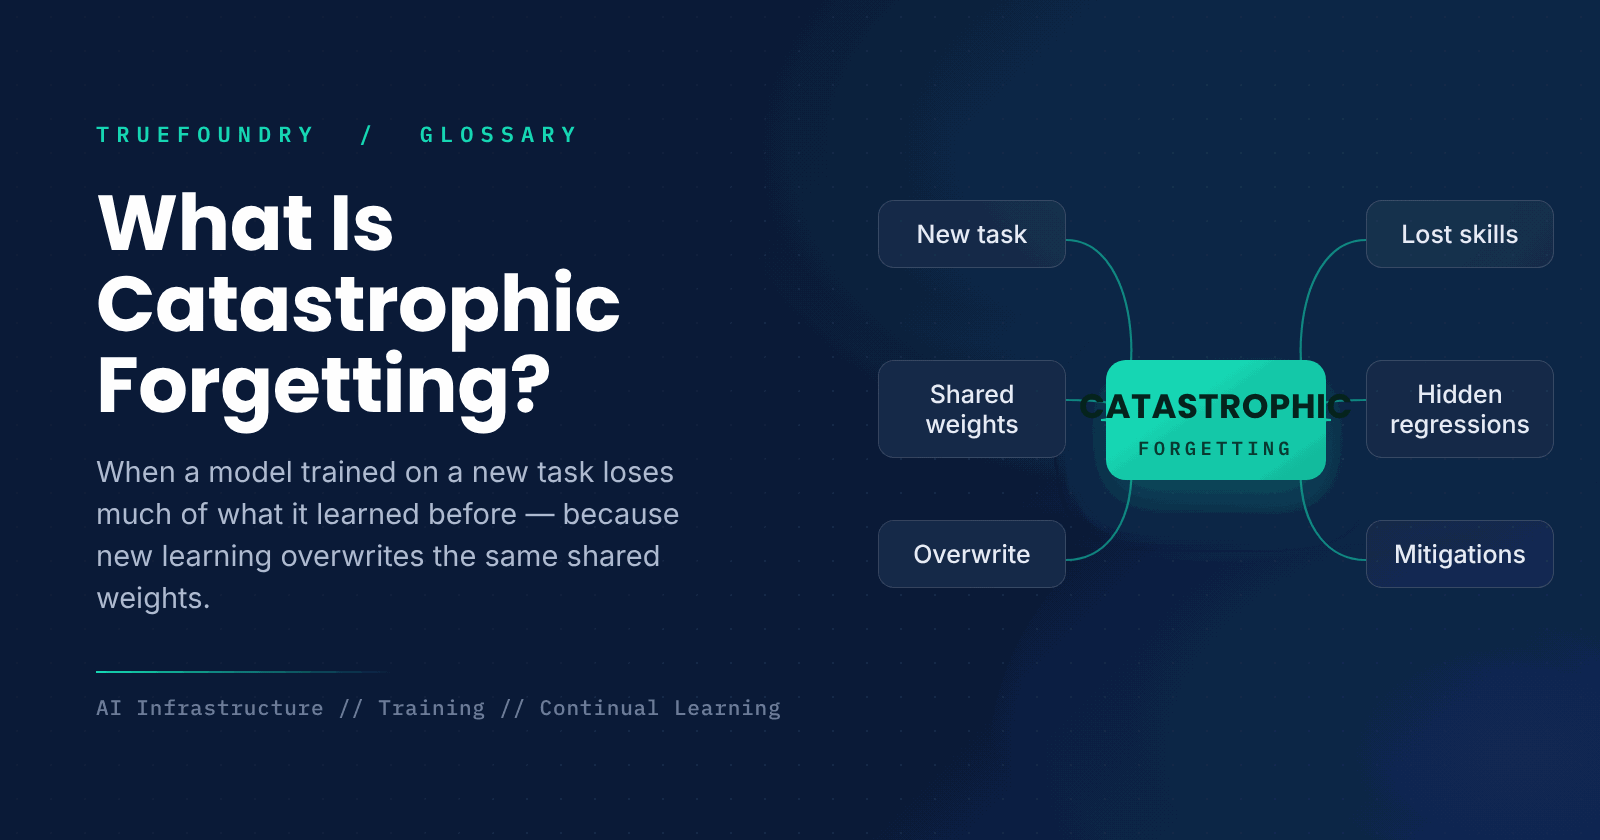
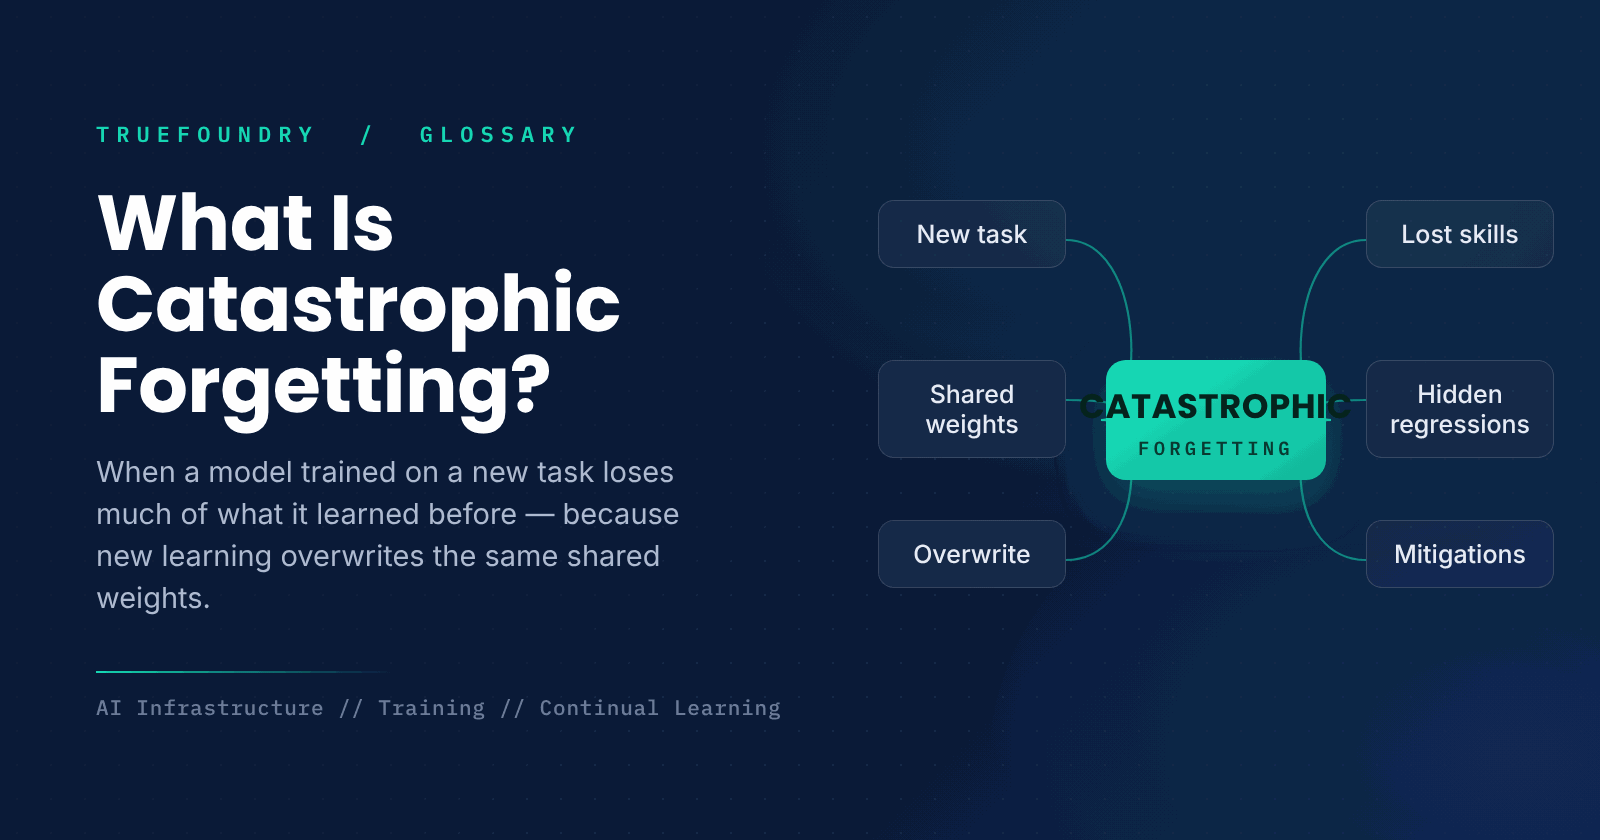
Wanneer je een model finetunet voor een nieuwe taak, hoop je dat het de nieuwe vaardigheid verwerft terwijl het alles wat het al wist behoudt. Vaak is dat niet het geval. Terwijl het model de nieuwe taak leert, kan het veel van zijn eerdere vaardigheden verliezen, soms op dramatische wijze. Dit is catastrofale vergetelheid en het is een van de grootste uitdagingen bij het aanpassen en continu trainen van neurale netwerken.
De oorzaak zit ingebakken in de manier waarop deze modellen leren: training past dezelfde gedeelde gewichten aan, waardoor updates voor de nieuwe taak de patronen die oude kennis bevatten kunnen overschrijven. Het begrijpen en beheersen van dit effect is essentieel voor veilig finetunen en voor het bouwen van systemen die in de loop van de tijd blijven leren. Deze gids legt uit wat het is, waarom het gebeurt en hoe je het kunt verminderen.
We behandelen de definitie, de oorzaak, hoe het wordt beperkt en wanneer het van belang is.
Wat is catastrofale vergetelheid?
Catastrofale vergetelheid is de neiging van een neuraal netwerk om eerder geleerde kennis te verliezen wanneer het wordt getraind op nieuwe data of een nieuwe taak. De prestaties van het model op eerdere taken nemen af, soms scherp, naarmate het zich aanpast aan de nieuwe taak, omdat het trainingsproces de gewichten overschrijft waarin de oude kennis was opgeslagen.
Zie het als schrijven op hetzelfde whiteboard. Om nieuwe aantekeningen toe te voegen, wis je een deel van wat er stond, waardoor de oude aantekeningen verloren gaan. Een neuraal netwerk leert op basis van een gedeelde set gewichten, dus iets nieuws aanleren kan het voorgaande uitwissen, tenzij je voorzorgsmaatregelen neemt om het te beschermen.
Het kernidee is interferentie tussen oude en nieuwe leerstof. Omdat kennis verspreid is over gedeelde gewichten in plaats van opgeslagen in afzonderlijke vakjes, kunnen nieuwe updates als bijwerking oude vaardigheden verstoren.
Waarom treedt catastrofale vergetelheid op?
Het gebeurt omdat het aanleren van een nieuwe taak dezelfde gewichten hergebruikt en overschrijft die oude kennis bevatten.
- Gedeelde gewichten. Het model slaat alle kennis op in één set gewichten.
- Training voor een nieuwe taak. Finetuning stuurt die gewichten in de richting van de nieuwe taak.
- Overschrijven. Updates veranderen gewichten die eerdere vaardigheden codeerden.
- Interferentie. Oude patronen worden verstoord als bijwerking.
- Degradatie. De prestaties op eerdere taken nemen af.
Hoe meer de nieuwe taak de gewichten wegtrekt van hun oorspronkelijke positie, hoe meer de oude kennis erodeert. Intensieve training op een specifieke nieuwe taak is hier extra gevoelig voor, omdat het model sterk optimaliseert voor de nieuwe data zonder enige noodzaak om het oude te behouden.
Hoe wordt catastrofale vergetelheid verminderd?
Eén familie van methoden beschermt of bevriest belangrijke gewichten, zodat training alleen de onderdelen verandert die het minst relevant zijn voor oude taken. Parameter-efficiënte methoden zoals adapters en LoRA gaan nog een stap verder door het basismodel volledig te bevriezen en alleen kleine, toegevoegde gewichten te trainen, waardoor de oorspronkelijke kennis intact blijft.
Een andere familie houdt oude kennis aanwezig tijdens de training. Bij 'replay' worden voorbeelden van eerdere taken gemengd met de nieuwe trainingsdata, zodat het model blijft oefenen wat het al wist. Regularisatiemethoden voegen een straf toe voor het te ver verplaatsen van belangrijke gewichten. In de praktijk combineren teams deze benaderingen om een balans te vinden tussen nieuw leren en behoud van kennis.
Waarom is catastrofale vergetelheid belangrijk?
- Risico bij fine-tuning. Het aanpassen van een model kan ongemerkt de algemene vaardigheden verminderen.
- Continu leren. Het belemmert modellen om taken in een reeks te leren.
- Verborgen regressies. Verloren vaardigheden komen mogelijk pas later aan het licht.
- Kosten. Opnieuw trainen vanaf nul om verloren kennis te herstellen is kostbaar.
- Betrouwbaarheid.Het behouden van oud gedrag is essentieel voor betrouwbare updates.
Wat zijn de uitdagingen bij het aanpakken hiervan?
- Afweging. Het beschermen van oude kennis kan het nieuwe leerproces beperken.
- Detectie. Vergetelheid kan onopgemerkt blijven als oude taken niet worden getest.
- Gegevenstoegang. Replay vereist toegang tot eerdere trainingsdata.
- Optimalisatie.Mitigatiemethoden voegen hun eigen instellingen toe voor de balans.
Wanneer moet je je hier zorgen over maken?
Maak je zorgen over catastrofale vergetelheid wanneer je een model fine-tunt dat zijn oorspronkelijke vaardigheden moet behouden, of wanneer je van plan bent een model op opeenvolgende taken te trainen. Het is vooral een punt van zorg bij intensieve fine-tuning op beperkte data, waarbij het model te gespecialiseerd kan raken en zijn algemene vaardigheden verliest.
Als je een nieuw model traint voor een enkele taak en de eerdere kennis nooit meer nodig hebt, is vergeten geen probleem. Maar zodra behoud van kennis belangrijk is, loont het om parameter-efficiënte methoden, replay of regularisatie te gebruiken en oude vaardigheden na de training te testen.
Kernpunten over catastrofale vergetelheid
- Het is het verlies van oude vaardigheden bij het aanleren van nieuwe.
- Het gebeurt doordat nieuwe training gedeelde gewichten overschrijft.
- Intensieve fine-tuning op beperkte data verergert het probleem.
- Adapters en LoRA voorkomen dit door het basismodel te bevriezen.
- Replay en regularisatie helpen oude kennis te behouden.
- Het is relevant zodra eerdere vaardigheden behouden moeten blijven.
Conclusie
Catastrofale vergetelheid is het verlies van eerder geleerde kennis wanneer een model op iets nieuws wordt getraind, veroorzaakt doordat nieuwe leerstof de gedeelde gewichten overschrijft die de oude kennis bevatten. Het is een centrale uitdaging bij fine-tuning en continu leren, maar technieken zoals parameter-efficiënte adapters, replay en regularisatie kunnen dit aanzienlijk verminderen.
TrueFoundry helpt teams bij het fine-tunen van modellen op hun eigen infrastructuur met methoden die behouden wat een model al weet, zoals adapter-gebaseerde tuning waarbij het basismodel intact blijft. Wanneer het aanpassen van een model zonder verlies van sterke punten belangrijk is, is het beheersen van catastrofale vergetelheid cruciaal.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is catastrophic forgetting in simple terms?
It happens when a model acquires a new skill but at the cost of forgetting a lot of what it had learned earlier. This is because training modifies the same weights that were associated with the previous knowledge, so the model's performance on earlier tasks drops.
Why does catastrophic forgetting happen?
Because a neural network stores its knowledge in one common set of weights. The training done for a new task drives those weights toward the new task, and this process overwrites the weight patterns that were responsible for earlier skills, disrupting them as a side effect.
How can catastrophic forgetting be reduced?
Various methods: freezing the base model and training small added weights, as adapters and LoRA do; replaying examples from previous tasks during new training; or adding a penalty so important weights don't move too far. Teams often combine these to balance new learning with retention.
Does fine-tuning always cause forgetting?
Not always, but heavy fine-tuning on narrow data is especially prone to it, because the model optimizes hard for the new task with no pressure to keep the old. Parameter-efficient methods and testing old capabilities afterward help keep it in check.
When should I worry about catastrophic forgetting?
Whenever you need to refine a model that still requires its original abilities, or when you will train it on tasks in sequence. If you are building a fresh model for only one task and never need the prior knowledge, it is not a concern.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


