


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is autoscaling en hoe werkt het?

De vraag naar een dienst is zelden constant. Deze stijgt en daalt met het tijdstip van de dag, productlanceringen en gebruikspatronen. Als u provisiont voor de piek, betaalt u het grootste deel van de tijd voor ongebruikte capaciteit; provisiont u voor het gemiddelde, dan loopt het systeem vast bij verkeerspieken. Autoscaling lost dit op door de capaciteit automatisch te wijzigen zodat deze overeenkomt met de actuele vraag op elk moment.
Voor AI-workloads, waarbij de compute — vooral GPU's — duur is, is dit van groot belang. Met autoscaling kan een dienst groeien om een piek op te vangen en weer krimpen als deze voorbij is. Zo krijgt u responsiviteit wanneer u die nodig hebt, zonder te betalen wanneer u er geen gebruik van maakt.
In deze gids wordt uitgelegd wat autoscaling is, hoe het werkt, wat de belangrijkste typen zijn en waarom het belangrijk is om diensten efficiënt uit te voeren.
Wat is autoscaling?
Autoscaling is het automatisch aanpassen van de compute-resources die aan een dienst zijn toegewezen op basis van realtime vraag. In plaats van een vaste hoeveelheid capaciteit uit te voeren, bewaakt het systeem signalen zoals verkeer, CPU of lengte van de wachtrij. Het voegt capaciteit toe of verwijdert deze, zodat het aanbod de vraag volgt zonder handmatige tussenkomst.
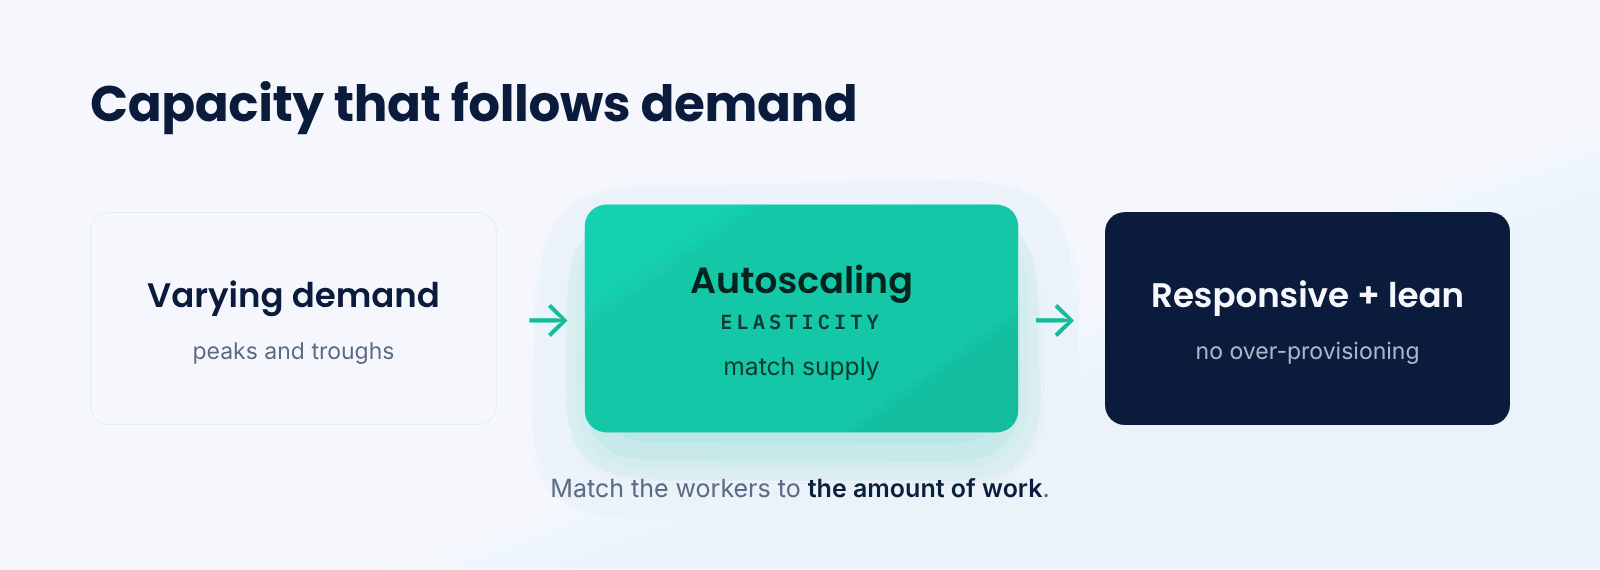
Zie het als een winkel die caissières toevoegt als de rij groeit en ze op pauze stuurt als het rustig is. Klanten worden op drukke momenten snel geholpen en het personeel staat niet niets te doen als het rustig is. Autoscaling doet dit voor compute door het aantal workers af te stemmen op de hoeveelheid werk.
Het kernidee is elasticiteit. In plaats van een vaste toewijzing die is gebaseerd op een schatting van de vraag, beweegt de capaciteit mee met de werkelijkheid. Dit verbetert zowel de responsiviteit als de kostenefficiëntie.
Hoe werkt autoscaling?
Autoscaling bewaakt vraagsignalen en wijzigt de capaciteit volgens gedefinieerde regels.
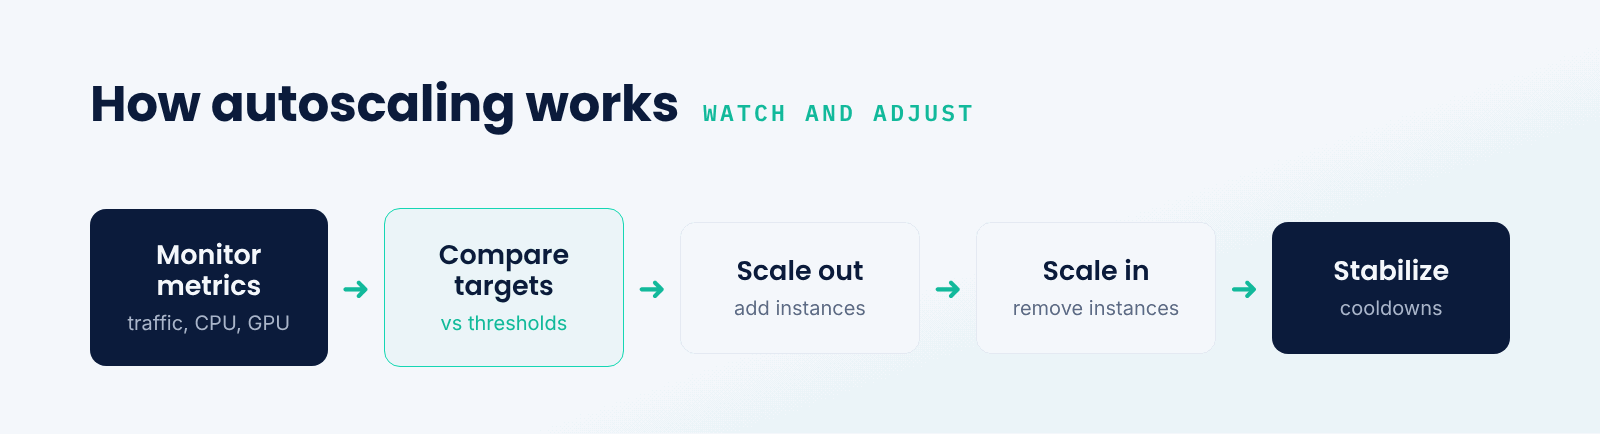
- Statistieken bewaken. Signalen zoals het aantal requests, CPU, GPU of de lengte van de wachtrij worden bijgehouden.
- Vergelijken met doelen. Statistieken worden gecontroleerd aan de hand van drempelwaarden die u zelf instelt.
- Scale out (horizontaal schalen). Wanneer de vraag het doel overschrijdt, worden er meer instanties toegevoegd.
- Scale in. Wanneer de vraag daalt, worden instanties verwijderd om kosten te besparen.
- Stabiliseren. Cooldown-perioden voorkomen dat het systeem snel heen en weer schaalt (flapping) terwijl het zich stabiliseert.
Goede autoscaling draait om de juiste signalen en drempelwaarden. Schaalt u te langzaam, dan merken gebruikers vertraging tijdens een piek; schaalt u te agressief, dan verspilt u geld of raakt het systeem instabiel. Het afstemmen van de regels op de workload is dus wat het effectief maakt.
Scale out vs. scale up vs. scale to zero
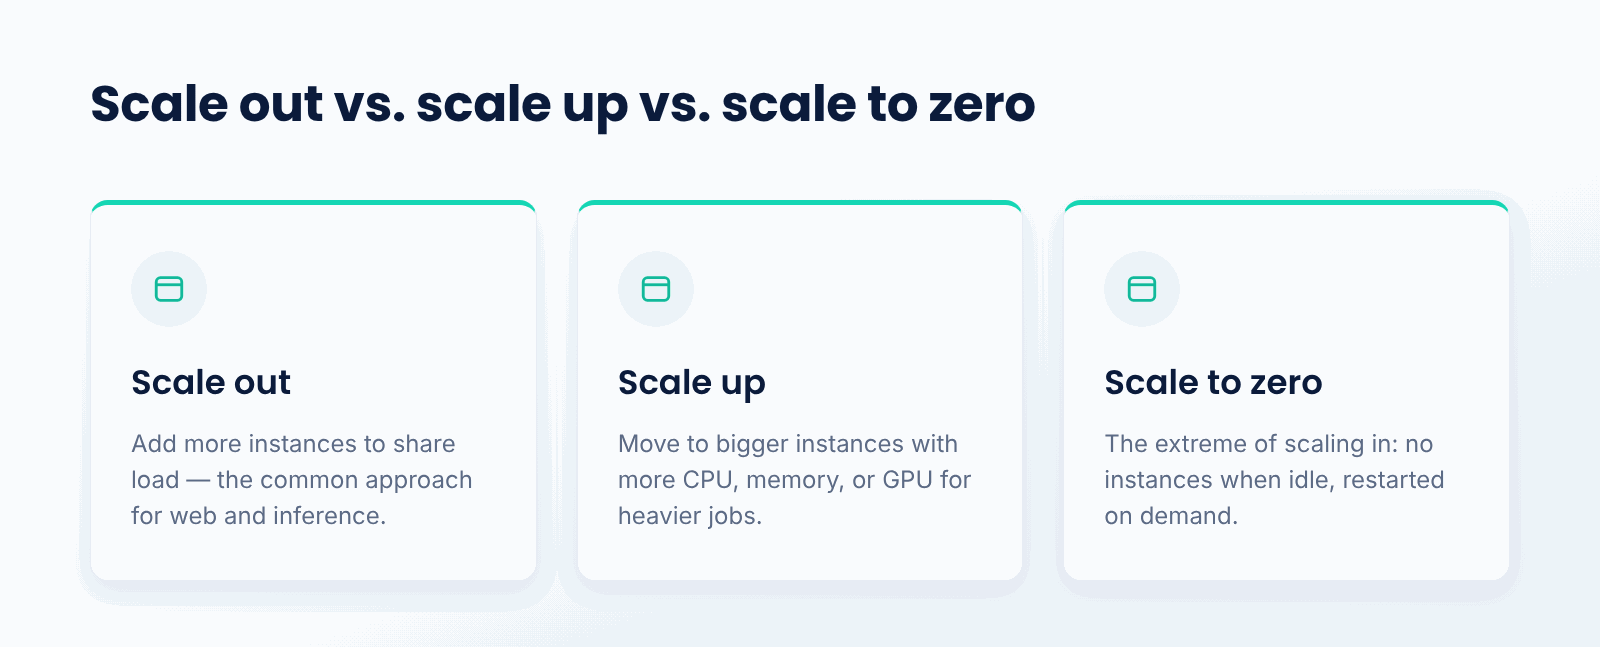
Autoscaling kent verschillende vormen. Scaling out, of horizontaal schalen, voegt meer instanties van een dienst toe om de belasting te verdelen; dit is de meest gebruikelijke aanpak voor web- en inference-workloads. Scaling up, of verticaal schalen, stapt over op grotere instanties met meer CPU, geheugen of GPU voor zwaardere individuele taken. Scale to zero is het uiterste van in-schalen: het terugbrengen naar nul instanties wanneer het systeem volledig inactief is, en weer opstarten bij vraag.
Deze vormen vullen elkaar aan. De meeste diensten schalen uit en in met de belasting, kunnen up-scalen voor grotere workloads en kunnen to zero schalen wanneer de inactieve tijd aanzienlijk is. Samen zorgen ze ervoor dat de capaciteit over het gehele bereik aansluit op de vraag.
Waarom is autoscaling belangrijk?
- Vangt pieken op. Het houdt diensten responsief wanneer de vraag plotseling stijgt.
- Beheerst kosten. Het verwijdert capaciteit bij inactiviteit, zodat u niet te veel betaalt.
- Neemt handmatig werk weg. Capaciteit past zich aan zonder dat iemand dashboards hoeft te bewaken.
- Verbetert de betrouwbaarheid. Schalen met de belasting helpt overbelasting en uitval te voorkomen.
- Optimaliseert GPU's. Voor kostbare accelerators brengt het de prestaties in balans met de uitgaven.
Wat zijn de uitdagingen?
- Juiste signalen. Het kiezen van statistieken die de belasting van uw workload echt goed weerspiegelen, vereist zorgvuldigheid.
- Schaalvertraging (lag). Nieuwe instanties, vooral GPU-instanties, hebben tijd nodig om online te komen.
- Thrashing (instabiliteit). Slecht afgestelde regels kunnen ertoe leiden dat capaciteit te vaak wordt toegevoegd en verwijderd.
- Kostenbeheersing. Zonder limieten kan out-scalen tot onverwacht hoge rekeningen leiden.
Wanneer hebt u autoscaling nodig?
U hebt het nodig wanneer de vraag varieert en u geeft om zowel responsiviteit als kosten — wat geldt voor de meeste productiediensten. Hoe variabeler het verkeer en hoe duurder de compute, hoe meer autoscaling oplevert.
Een dienst met een volkomen stabiele, voorspelbare belasting zou op een vaste grootte kunnen draaien. Maar elke workload met pieken en dalen, vooral op GPU's, profiteert van capaciteit die de vraag volgt in plaats van vast te staan.
Best practices voor autoscaling
- Schaal op basis van statistieken die de werkelijke belasting van uw workload getrouw weerspiegelen.
- Stel verstandige minimum- en maximumgrenzen in om de responsiviteit en het budget te beschermen.
- Gebruik cooldowns om te voorkomen dat het systeem snel heen en weer schaalt.
- Houd rekening met de opstarttijd en pas pre-warming toe waar cold starts nadelig zijn.
- Combineer scale out, scale up en scale to zero afhankelijk van wat de workload nodig heeft.
- Bewaak het schaalgedrag en de kosten, zodat regels in de loop van de tijd kunnen worden bijgesteld.
Conclusie
Autoscaling stemt de compute van een dienst automatisch af op de vraag: er wordt capaciteit toegevoegd bij belasting en verwijderd wanneer de vraag daalt. Het houdt applicaties responsief tijdens pieken en voorkomt de kosten van het permanent provisionen voor het drukste moment. Door scale out, scale up en zelfs scale to zero kan de capaciteit de werkelijke vraag volgen, wat vooral waardevol is voor dure GPU-workloads.
TrueFoundry biedt autoscaling voor model-deployments op uw eigen infrastructuur, waarbij GPU-ondersteunde diensten meeschalen met de vraag en terugschaalt naar nul bij inactiviteit. Omdat AI-workloads variëren, is autoscaling dé manier voor teams om ze zowel responsief als kostenefficiënt te houden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
Wat is autoscaling in eenvoudige bewoordingen?
Hiermee kan een service automatisch rekenkracht toevoegen wanneer de vraag stijgt en deze weer verwijderen wanneer de vraag afneemt. Zo blijf je tijdens drukke periodes goed bereikbaar, zonder dat je betaalt voor extra capaciteit wanneer het rustig is.
Wat is het verschil tussen horizontaal schalen (scaling out) en verticaal schalen (scaling up)?
Bij horizontaal schalen (scaling out) worden er meer instanties toegevoegd om de werklast te verdelen; dit is de gebruikelijke aanpak voor webtoepassingen en inferentie. Bij verticaal schalen (scaling up) wordt overgestapt op grotere instanties met meer CPU, geheugen of GPU voor zwaardere individuele taken. Veel systemen gebruiken een combinatie van beide.
Hoe bepaalt autoscaling wanneer er geschaald moet worden?
Het bewaakt signalen zoals het aantal aanvragen, CPU/GPU-gebruik of wachtrijlengte en controleert of deze de door jou ingestelde drempelwaarden overschrijden. Wanneer de vraag een drempelwaarde overschrijdt, wordt er capaciteit toegevoegd of verwijderd, waarbij wachttijden worden gehanteerd om te voorkomen dat er te snel heen en weer wordt geschaald.
Wat is de relatie tussen autoscaling en scale to zero?
Scale to zero is de uiterste vorm van schalen: het terugbrengen naar nul instanties wanneer het systeem volledig inactief is. Bij standaard autoscaling blijft er normaal gesproken ten minste één instantie actief, terwijl je bij scale to zero niets betaalt tijdens inactiviteit, met als nadeel een cold start.
Waarom is autoscaling belangrijk voor GPU's?
Omdat GPU's duur zijn, is het aanhouden van een vast aantal dat is afgestemd op piekmomenten zonde van het geld tijdens daluren, terwijl een te klein aantal niet voldoet onder belasting. Het automatisch schalen van GPU-services op basis van de vraag brengt prestaties en kosten in balans, wat essentieel is voor betaalbare AI.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


