


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is een attention-mechanisme en waarom is het belangrijk?

Wanneer je een zin leest, geef je niet elk woord evenveel gewicht. Om een voornaamwoord te begrijpen, kijk je terug naar het zelfstandig naamwoord waar het naar verwijst; om een werkwoord te interpreteren, focus je op het onderwerp en het lijdend voorwerp. Attention-mechanismen geven neurale netwerken een versie van dat vermogen: een manier om voor elk stukje uitvoer te bepalen welke delen van de invoer het meest relevant zijn.
Attention is het kernconcept van de transformer, de architectuur achter vrijwel elk modern groot taalmodel. Het verving oudere benaderingen die sequenties strikt in volgorde verwerkten en moeite hadden om woorden die ver uit elkaar stonden met elkaar te verbinden. Door elk token direct naar elk ander token te laten kijken, maakte attention het mogelijk om taal te modelleren op een schaal en met een kwaliteit die voorheen onbereikbaar was.
Deze gids legt uit wat een attention-mechanisme is, hoe het werkt, waarin self-attention verschilt van eerdere methoden en waarom het zo belangrijk is.
Wat is een attention-mechanisme?
Een attention-mechanisme is een functie die een gewogen combinatie van waarden berekent, waarbij de gewichten weerspiegelen hoe relevant elke waarde is voor een bepaalde query. Elk invoerelement produceert een query, een key en een value. De query wordt vergeleken met alle keys om attention-scores te genereren, en die scores bepalen in hoeverre elke value bijdraagt aan de uitvoer.
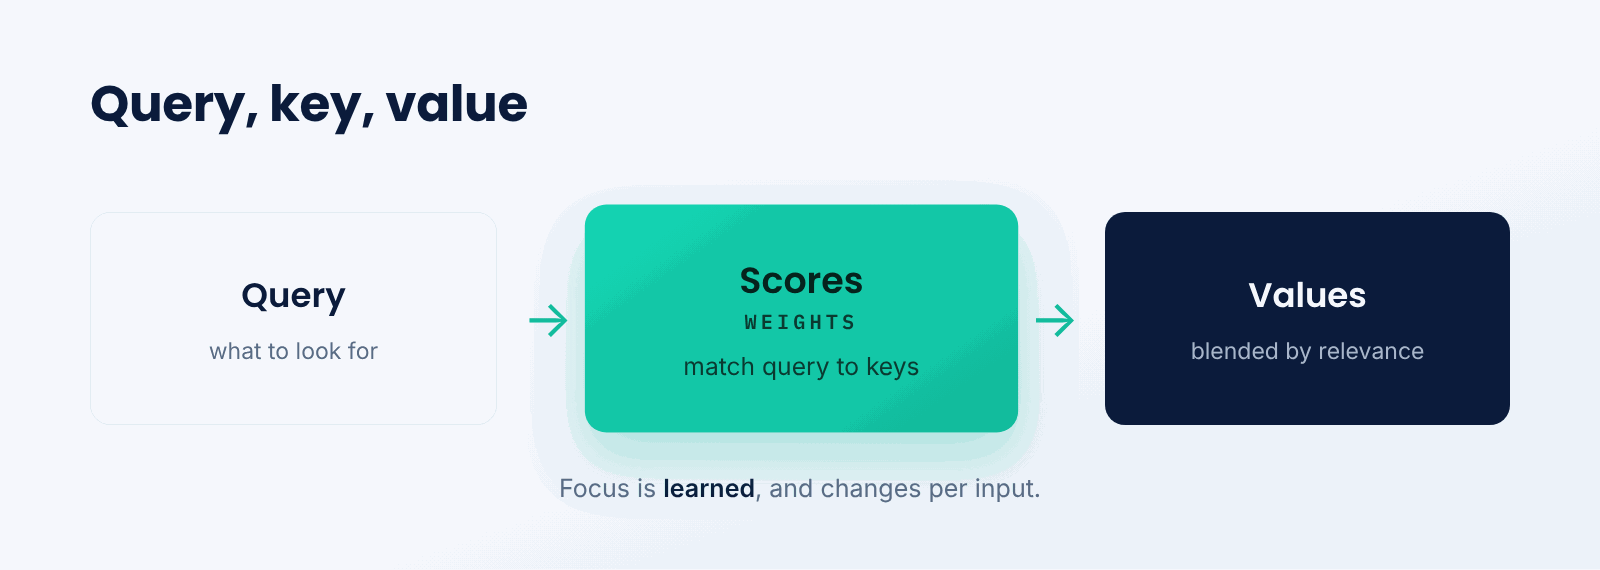
Zie het als iets opzoeken in een bibliotheek. Je vraag is de query, de labels op de planken zijn de keys en de boeken zelf zijn de values. Je vergelijkt je vraag met de labels om de meest relevante planken te vinden en put vervolgens het meest uit die boeken. Attention doet hetzelfde met getallen, waarbij informatie wordt gecombineerd in verhouding tot de relevantie.
Het belangrijkste idee is dat attention wordt aangeleerd en dynamisch is. Het model krijgt niet verteld welke invoer belangrijk is; het leert om queries en keys te produceren zodat relevante paren hoog scoren. Hierdoor kan het voor elke invoer die het ziet anders focussen.
Hoe werkt self-attention?
In een transformer stelt self-attention elk token in een sequentie in staat om aandacht te besteden aan alle andere tokens, inclusief zichzelf.
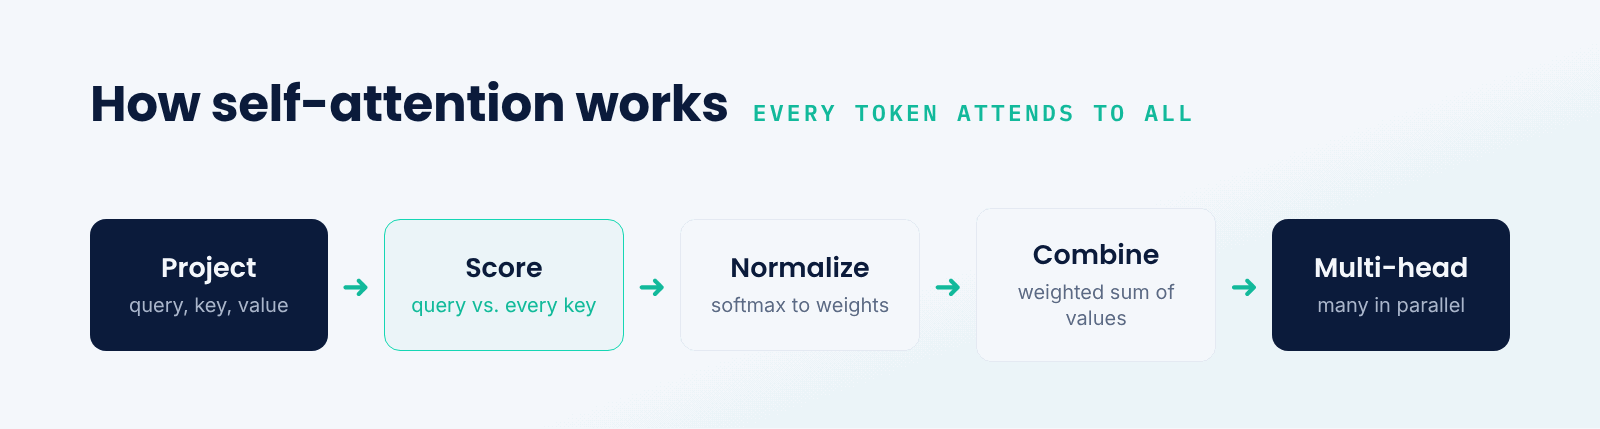
- Projectie. Elk token wordt omgezet in een query-, key- en value-vector.
- Score.Elke query wordt vergeleken met elke key om relevantiescores te verkrijgen.
- Normalisatie. De scores worden via softmax omgezet in gewichten die samen één vormen.
- Combineer.De uitvoer van elk token is een gewogen som van alle values, gebruikmakend van die gewichten.
- Parallel herhalen. Meerdere attention-heads doen dit tegelijkertijd, waardoor verschillende relaties worden vastgelegd.
Omdat elk token aandacht besteedt aan elk ander token, legt self-attention relaties vast ongeacht de afstand. Hierdoor wordt een woord net zo gemakkelijk verbonden met een woord dat ver terug in de tekst staat als met zijn directe buurman. Meerdere heads stellen het model in staat om verschillende soorten relaties tegelijkertijd bij te houden, zoals grammatica en betekenis.
Attention versus oudere sequentiële modellen
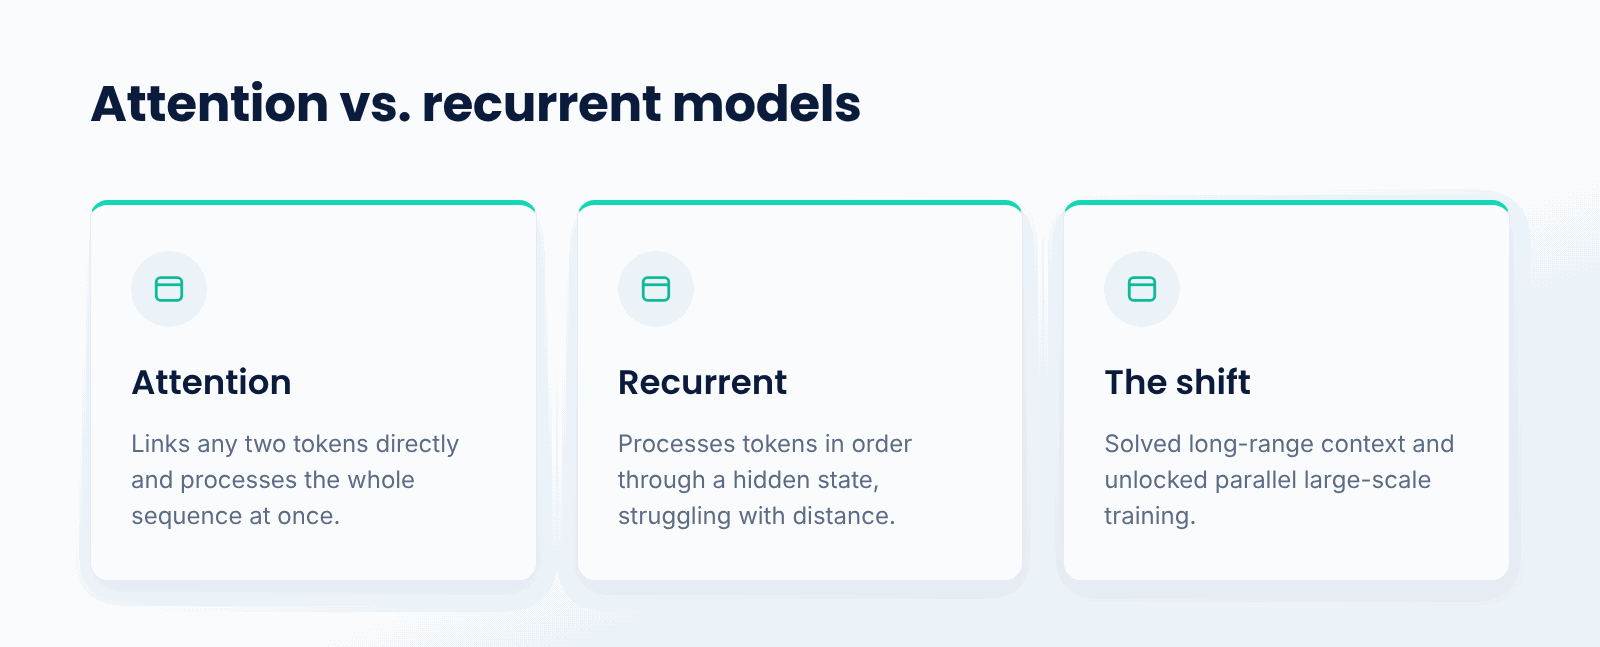
Vóór de komst van attention werden sequenties voornamelijk afgehandeld door recurrente netwerken die tokens één voor één verwerkten en een verborgen toestand meenamen. Hierdoor was het lastig om verre tokens met elkaar te verbinden, omdat informatie vele stappen moest overleven, en het dwong tot sequentiële berekeningen die traag waren om te trainen. Attention verwerkt de hele sequentie in één keer en koppelt elke twee posities direct aan elkaar.
Die verschuiving had twee grote gevolgen. Het loste het probleem van langeafhankelijkheden op, waardoor modellen verbanden konden leggen tussen verre delen van een tekst, en het maakte parallelle training op moderne hardware mogelijk, wat training op enorme datasets praktisch maakte. Samen zijn dit de redenen waarom de transformer eerdere architecturen heeft vervangen.
Waarom is attention belangrijk?
- Context over lange afstand. Het verbindt verre tokens direct, in plaats van via vele tussenstappen.
- Parallelisme. De volledige sequentie wordt in één keer verwerkt, wat snelle training mogelijk maakt.
- Schaal.Het maakte het trainen van zeer grote modellen op enorme datasets praktisch.
- Flexibiliteit. Hetzelfde mechanisme werkt voor tekst, afbeeldingen, audio en meer.
- Kwaliteit.Het is de kernreden waarom transformers zo goed met taal omgaan.
Wat zijn de afwegingen?
- Kwadratische kosten. Het vergelijken van elk token met elk ander token groeit met het kwadraat van de lengte.
- Geheugengebruik. Lange sequenties vereisen grote attention-berekeningen en KV-caches.
- Contextuele beperkingen.De kosten van attention bepalen hoe lang een context in de praktijk kan zijn.
- Efficiëntieonderzoek. Er bestaan veel varianten om attention goedkoper te benaderen.
Wanneer moet je je druk maken om attention?
Als je grote taalmodellen gebruikt of bouwt, is attention het mechanisme dat aan bijna alles ten grondslag ligt wat ze doen. Het begrijpen ervan helpt dus om hun sterke punten en beperkingen te verklaren. Vooral de kwadratische kosten van attention zijn de reden waarom contextlengte en de verwerking van lange invoer zulke belangrijke en actief geoptimaliseerde onderdelen van het serveren van modellen zijn.
De meeste applicatieontwikkelaars hoeven zelf geen attention te implementeren, maar weten dat dit mechanisme zowel de capaciteit als de kosten van deze modellen bepaalt, helpt je om na te denken over latentie, contextvensters en waarom langere prompts duurder zijn om te verwerken.
Belangrijke punten over attention
- Attention weegt de relevantie van input met behulp van queries, keys en values.
- Self-attention stelt elk token in staat om aandacht te besteden aan elk ander token.
- Het is de kernbouwsteen van de transformer-architectuur.
- Het legt relaties over lange afstanden vast die oudere modellen misten.
- De kwadratische kosten ervan bepalen de limieten voor contextlengte en optimalisaties voor het serveren van modellen.
- Dankzij meerdere 'heads' kan een model verschillende relaties tegelijkertijd volgen.
Conclusie
Een attention-mechanisme stelt een model in staat om te bepalen welke delen van de input het belangrijkst zijn voor elk deel van de output, met behulp van queries, keys en values. Self-attention, waarbij elk token naar elk ander token kijkt, vormt de basis van de transformer en is de belangrijkste reden waarom moderne taalmodellen zo goed omgaan met context over lange afstanden. De grootste kostenpost, die schaalt met het kwadraat van de sequentielengte, is de reden waarom efficiënte attention en contextbeheer essentieel zijn voor het serveren van modellen.
TrueFoundry helpt teams om transformer-modellen efficiënt te serveren door het geheugen en de rekenkracht die attention vereist te beheren, zodat lange contexten snel en betaalbaar blijven. Het begrijpen van attention is de eerste stap om te begrijpen waarom deze modellen zich zo gedragen en waarom ze kosten zoals ze doen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is an attention mechanism in simple terms?
It is a process through which the model establishes what is more important in the input for generating a certain output. The same way you focus on important words while making sense of a sentence, the model assigns higher weight to the inputs that are most relevant and blends them accordingly.
What is self-attention?
This is attention performed on one sequence alone, with each token attending to all others, including itself. In this way, the model can relate any two positions directly, allowing transformers to capture the context of an entire piece of text.
What are queries, keys, and values?
They are three vectors each token produces. The comparison of the query with all the keys gives relevance scores, which in turn assign weights to the values to form the output. It is similar to matching a question (query) to labels (keys) to retrieve content (values).
Why is attention expensive for long inputs?
Since each token needs to be compared against all the other tokens, the complexity is proportional to the square of the sequence length. When the sequence length is doubled, the computation and memory for attention become roughly four times more, which is why very long contexts are costly to process.
Why did attention replace recurrent networks?
This approach tackled two issues at the same time: it provides a direct connection between far-apart tokens, bypassing multiple sequential steps, and allows parallel processing of the entire sequence. That made both long-range context and large-scale training practical, which recurrent models could not do well.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


