


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Approximate Nearest Neighbor Search en waarom is het belangrijk?

Veel AI-systemen werken door data om te zetten in vectoren en vervolgens de items te vinden waarvan de vectoren het dichtst bij een zoekopdracht liggen; een proces dat de kern vormt van semantisch zoeken, aanbevelingen en retrieval-augmented generation. De exacte versie hiervan, waarbij de zoekopdracht met elk afzonderlijk item wordt vergeleken, is nauwkeurig maar veel te traag zodra een verzameling groeit tot miljoenen vectoren.
Approximate nearest neighbor search lost dit op door items te vinden die heel dicht bij de zoekopdracht liggen – niet noodzakelijkerwijs de exact dichtstbijzijnde – maar dit aanzienlijk sneller te doen. Door een klein verlies aan nauwkeurigheid te accepteren, verandert het een onpraktische zoekopdracht in een zoekopdracht die in milliseconden wordt uitgevoerd. Deze gids legt uit wat het is, hoe het werkt en waarom het belangrijk is.
We behandelen de definitie, de werking, de vergelijking met exact zoeken en wanneer je het moet gebruiken.
Wat is approximate nearest neighbor search?
Approximate nearest neighbor (ANN) search is een techniek om snel de items in een grote dataset te vinden waarvan de vectoren het meest lijken op een zoekvector, waarbij benaderende in plaats van exacte resultaten worden geaccepteerd in ruil voor snelheid. In plaats van de garantie op de enige echte dichtstbijzijnde match, geeft het resultaten terug die bijna altijd tot de dichtstbijzijnde behoren, en dat veel sneller dan een uitputtende vergelijking zou toestaan.
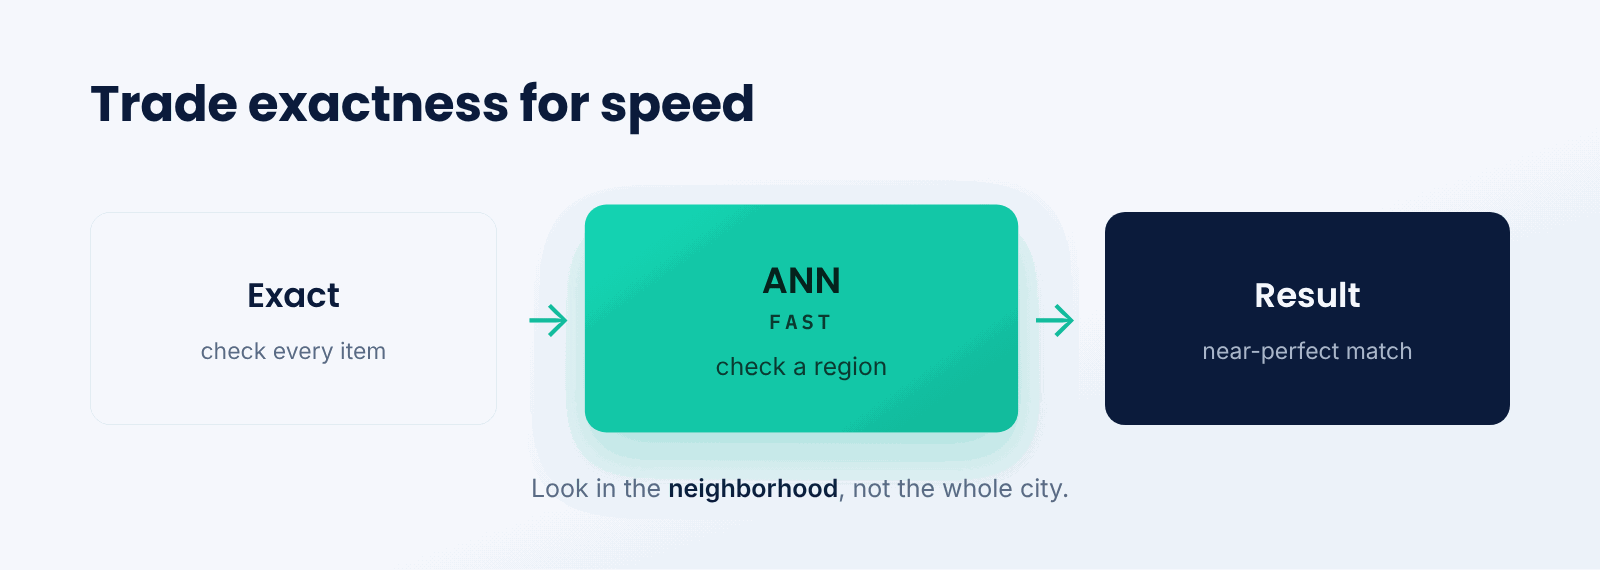
Zie het als het vinden van een koffietentje in de buurt. Je zou de exacte afstand tot elk koffietentje in de stad kunnen meten om de absolute dichtstbijzijnde te vinden, of je kunt eerst in je eigen buurt kijken en daar de dichtstbijzijnde kiezen. De tweede manier is bijna altijd juist en enorm veel sneller. ANN-search werkt volgens dat principe.
Het kernidee is het inruilen van exactheid voor snelheid. Door de garantie op de perfecte match los te laten, vermijdt ANN-search het vergelijken van de zoekopdracht met elk item, waardoor het snel genoeg wordt om op enorme verzamelingen te gebruiken.
Hoe werkt ANN-search?
ANN-search bouwt een index waarmee het de meeste vergelijkingen kan overslaan.
- Embed de data. Zet elk item om in een vector.
- Bouw een index. Organiseer de vectoren zodat vergelijkbare vectoren gemakkelijk te bereiken zijn.
- Embed de zoekopdracht. Zet ook de zoekopdracht om in een vector.
- Doorzoek de index. Navigeer naar de regio nabij de zoekopdracht, niet de hele set.
- Geef matches terug. Geef de daar gevonden dichtstbijzijnde items snel terug.
De index is wat ANN snel maakt. Veelgebruikte methoden groeperen nabijgelegen vectoren, bouwen navigeerbare grafen tussen deze vectoren of hashen vergelijkbare vectoren samen, zodat een zoekopdracht slechts een klein, veelbelovend deel van de data onderzoekt in plaats van alles. Het afstellen van de index is een afweging tussen snelheid, nauwkeurigheid en geheugengebruik.
ANN versus exacte 'nearest neighbor'-zoekopdrachten
Bij een exacte 'nearest neighbor'-zoekopdracht wordt de query vergeleken met elk item, wat de garantie geeft op de werkelijk dichtstbijzijnde resultaten. Dit is perfect nauwkeurig, maar schaalt slecht: bij miljoenen vectoren wordt elke zoekopdracht traag en kostbaar, omdat de werklast toeneemt naarmate de collectie groeit.
ANN-zoeken gebruikt daarentegen een index om slechts een fractie van de data te onderzoeken. Hierdoor worden resultaten die bijna altijd de dichtstbijzijnde zijn, in een fractie van de tijd geretourneerd. De keerzijde is een kleine kans dat de exacte beste match wordt gemist, wat voor de meeste toepassingen acceptabel is, aangezien snelheid op schaal veel belangrijker is dan perfecte recall.
Waarom is ANN-zoeken belangrijk?
- Snelheid.Het levert resultaten in milliseconden op enorme datasets.
- Schaal.Het maakt vectorzoeken praktisch toepasbaar op miljoenen items.
- Kosten.Het verbruikt veel minder rekenkracht dan een volledige zoekopdracht.
- Mogelijkheden. Het vormt de basis voor semantisch zoeken, RAG en aanbevelingssystemen.
- Instelbaar. Je kunt naar behoefte nauwkeurigheid inruilen voor snelheid.
Wat zijn de afwegingen?
- Benadering. Het kan incidenteel de exacte dichtstbijzijnde match missen.
- Indexkosten. Het bouwen en opslaan van de index kost geheugen en tijd.
- Optimalisatie.Het balanceren van snelheid, nauwkeurigheid en geheugen vereist zorgvuldigheid.
- Updates. Sommige indexen zijn lastiger bij te werken naarmate data verandert.
Wanneer moet je ANN-zoeken gebruiken?
Gebruik approximate nearest neighbor search wanneer je behoefte hebt aan snelle gelijkeniszoekopdrachten in een grote verzameling vectoren; dit is het geval bij de meeste vectordatabases en retrievalsystemen. Het is essentieel wanneer de dataset te groot is voor een snelle exacte zoekopdracht, en wanneer een bijna perfect resultaat volstaat, wat meestal het geval is.
Als je dataset klein is, kan een exacte zoekopdracht snel genoeg en eenvoudiger zijn, zonder enige benadering. Maar zodra de schaal ervoor zorgt dat een uitputtende vergelijking te traag wordt, is ANN-search de standaardmanier om gelijkeniszoekopdrachten snel en betaalbaar te houden.
Belangrijke punten over ANN-search
- ANN-search vindt zeer vergelijkbare vectoren snel.
- Het ruilt een beetje nauwkeurigheid in voor een enorme snelheidswinst.
- Het gebruikt een index om de meeste vergelijkingen over te slaan.
- Het schaalt naar miljoenen vectoren in milliseconden.
- Het vormt de basis voor semantisch zoeken, RAG en aanbevelingssystemen.
- Exacte zoekopdrachten zijn alleen geschikt voor kleine datasets.
Conclusie
Approximate nearest neighbor search maakt gelijkeniszoekopdrachten op schaal snel door items te vinden die bijna altijd het dichtst bij een query liggen, waarbij een index wordt gebruikt om de meeste vergelijkingen over te slaan. Door een fractie van de nauwkeurigheid in te ruilen voor een enorme snelheidswinst, verandert het een onpraktische, uitputtende zoekopdracht in een proces dat in milliseconden verloopt. Dit maakt vector search, semantisch zoeken en retrieval-augmented generation praktisch toepasbaar op grote collecties.
TrueFoundry helpt teams bij het bouwen en beheren van retrieval- en vector-search-systemen op hun eigen infrastructuur, inclusief de approximate nearest neighbor-indexen die gelijkeniszoekopdrachten snel en betaalbaar houden. Wanneer zoekopdrachten zowel snel als schaalbaar moeten zijn, is ANN-search de techniek die daarachter zit.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is approximate nearest neighbor search in simple terms?
It is a quick way to find which vectors in a large set are most similar to your query vector. Rather than computing over every vector, it uses an index to look only where good matches are likely, which makes the process much faster while returning results that are almost always the closest.
Why is it approximate?
Because it does not guarantee the one and only closest match. It is very fast because it analyzes only the most promising part of the data rather than all of it, so it may occasionally miss the true best match; in exchange it is enormously faster, and the results are correct most of the time.
How is ANN different from exact nearest neighbor search?
Exact search matches the query against every record and always gives the true closest matches, but it is slow on a huge dataset. ANN searches an index and checks only a portion of the data, giving near-perfect results much faster. The tradeoff is a small chance of missing the exact best match.
What makes ANN search fast?
The index. When vectors are arranged so that similar ones are grouped, connected in a navigable graph, or hashed together, ANN search only examines a small, promising region near the query instead of the whole dataset, which is what gives it its speed.
When should I use ANN search?
For any use case that needs quick similarity search over vectors, such as a vector database or a retrieval system. For small datasets, exact search may be simpler and fast enough. At scale, ANN search is the standard choice.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


