


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



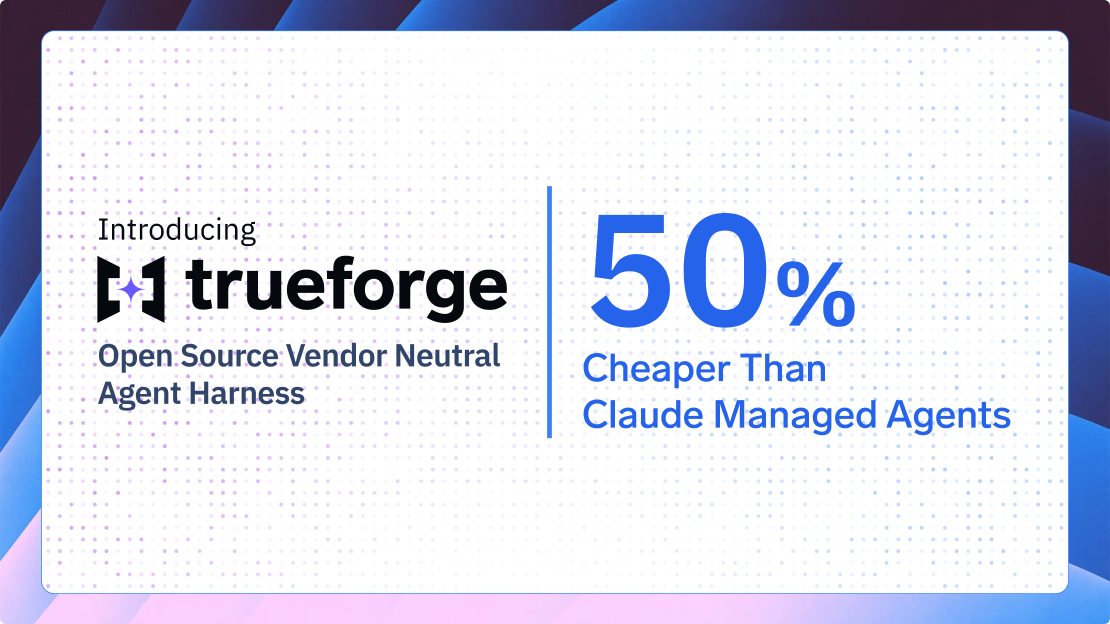

Veel van die agent-platformen hebben hun eigen soort eigenzinnige connectoren [...] waardoor je vastzit aan een leverancier. Ik zie dit als een betere manier: om wat meer leveranciersonafhankelijk te zijn en de mogelijkheid te hebben om portable te blijven.

Agent Harness
Een agent-harnas is de laag tussen een model en zijn tools.
Het bepaalt wat er in het contextvenster blijft, wat wordt samengevat, wat in een sandbox wordt uitgevoerd en nooit in de context terechtkomt, wanneer een ruisachtige deeltaak aan een subagent moet worden overgedragen en wanneer het tijd is om te stoppen en een mens in te schakelen. Het is geen framework: je schrijft nog steeds je eigen tools. Het is geen gateway: het beheert je inloggegevens of je beleid niet. Het is hetgeen dat een agent in leven houdt van iteratie één tot iteratie vijftig.
De loop zelf bestaat uit ongeveer tweehonderd regels code. Iedereen kan het schrijven, en de meeste teams doen dat ook, in een middag. Het harnas is alles wat je de zes maanden daarna bouwt, zodra die loop een echte workload tegenkomt en halverwege tegen obstakels aanloopt.
Onze stelling is dat modellen inwisselbaar zullen worden, dat tools het onderscheidende vermogen van de onderneming worden in plaats van dat van de leverancier, en dat governance onder de agent hoort in plaats van erin. Wat we hadden onderschat, was het harnas. Het Developer Platform Engineering-team van NetApp voerde een werkelijk zware workload uit om die stelling te toetsen, grondig en vooruitlopend op de markt, en liet ons precies zien waar het systeem tegen zijn grenzen aanliep.

het Open Pad
NetApp koos voor een open pad voordat de markt het inhaalde
In juni 2025 was Rob Rubin, nu Senior Director of Developer Platform Engineering bij NetApp, al voorbij de vraag waar de meeste ondernemingen nog over debatteerden. Zijn team beheert de Kubernetes-omgevingen waarop de rest van het bedrijf bouwt, en self-service provisioning was al volledig geautomatiseerd. De beperking was de interface daarvoor: een aanvraagformulier kan alleen bieden wat iemand vooraf heeft gemodelleerd.
Zijn idee was om daar in plaats daarvan intentie te plaatsen. Beschrijf de stack die je wilt; laat een agent deze samenstellen op basis van automatisering die al bestaat.
Dat betekende twee dingen voor ons.
Geen agent-framework. Geen harness. Daar ging het gesprek toen nog niet over. Zijn reden om te standaardiseren op MCP is waarom dit verhaal eindigt waar het eindigt:
Midden 2025 was dat nog een minderheidsstandpunt. Het is een belangrijke reden waarom TrueForge open source uitbrengt in plaats van als een gesloten managed runtime.

identiteit
Governance hoort onder de agents, niet erin
De eerste fase was identiteit, en dat is het onderdeel dat de meeste teams onderschatten.
Geen identiteit waarbij "de agent een API-sleutel vasthoudt". Echte identiteit, waarbij de persoon die de vraag stelt bepaalt wat de tools mogen doen. Een gebruiker authenticeert via de identiteitsprovider van NetApp. Die identiteit wordt via de MCP Gateway doorgegeven aan de MCP-server, die deze verifieert tegen het eigen clusteraccount van de gebruiker en kortstondige, gebruikersgebonden referenties uitgeeft. Elke kubectl-aanroep en elk shell-commando wordt uitgevoerd als die persoon. Vraag naar iets waar je geen toegang toe hebt en je krijgt precies wat een terminal je zou geven: niets.
Vier woorden, en zij zijn de reden dat dit de productieomgeving heeft gehaald. Een agent die draait als serviceaccount met cluster-admin is een demo. Een agent die draait als jij is infrastructuur.

Al het andere bevindt zich in de gateway in plaats van in een individuele agent: aanbiedersreferenties, RBAC op modelniveau, machtigingen op toolniveau, budgetten, snelheidslimieten, guardrails en logging. Agents verwijzen naar modelnamen en servernamen; referenties worden nooit verstuurd. Dat is wat een platformteam in staat stelt om de veertigste agent net zo gemakkelijk goed te keuren als de eerste, omdat een nieuwe agent geen nieuwe kopie van het beveiligingsmodel is.

De werklast
Eén vraag, acht clusters, dertig iteraties
Begin 2026 was de Kubernetes-agent live voor gebruikers, en de vorm van de workload verklaart alles wat volgt.
Een engineer vraagt "waarom zit mijn pod in CrashLoopBackOff?" Het platform omspant acht Kubernetes-clusters die het hele bedrijf bedienen, dus de eerste taak van de agent is meestal om de workload te lokaliseren voordat er überhaupt iets gediagnosticeerd kan worden. Dan het eigenlijke onderzoek: beschrijf de namespace, lijst pods op, haal events op, grep logs, inspecteer de ingress-laag, bevraag historische metrieken. De MCP-server stelt kubectl, een shell, Prometheus en een cluster-inventarisatietool beschikbaar. Niets van deze reeks is gescript; het model stelt het per probleem samen.
Vijftien tot dertig rondes van echte commando-output, per vraag. Onthoud dat getal, want het is het hele technische verhaal.

Hardwarelaag
Onder Kubernetes
Omdat NetApp nu eenmaal NetApp is, bouwde Igor Feoktistov een tweede MCP-server die onder het cluster door reikt tot in de fysieke infrastructuur. In een labsessie typte hij "troubleshoot cluster issue", zonder clusternaam en zonder hints.

De agent lokaliseerde het niet-reagerende knooppunt, werkte zich door de Kubernetes-laag heen, vond daar niets doorslaggevends, stapte over op hardware-diagnostiek en identificeerde de hoofdoorzaak als een geheugenfout in de onderliggende hardware. Vervolgens identificeerde het een reserve-onderdeel en voerde de workload-migratie uit, met een verwacht herstelvenster van vijf tot tien minuten.
Het technisch interessante deel is het pad, niet de uitkomst. Geen enkel draaiboek codeert "pod-fout naar geheugenfout naar workload-migratie." Die keten doorkruiste twee onafhankelijk gebouwde MCP-servers en bleef intact omdat beide eerlijke tools blootstelden onder dezelfde gebruikersidentiteit, waardoor het model steeds diepere lagen kon verkennen totdat het bewijs duidelijk werd. De capaciteit kwam van de tool-laag, die NetApp zelf heeft ontworpen en geschreven. Onze taak was om het veilig te maken om deze bloot te stellen en de lus een duurzame plek te geven om te draaien.

Contextmuur
Waar de lus brak: context is het echte technische probleem
Dertig iteraties van ruwe kubectl- en log-output doen iets voorspelbaars met een contextvenster. Onderzoeken begonnen halverwege te sterven.
Wat terugkwam was geen feature-verzoek. Het was een bugrapport, en nog een goed onderbouwd rapport ook:

Hij had de dure verdachten uitgesloten, wat het lastigste deel van elke diagnose is: niet het model, niet de prompt, niet de tools. De laag waar hij naar wees, bleek zich net onder de interface te bevinden; de laag die bepaalt wat in de context blijft, wat wordt samengevat en wat elders wordt uitgevoerd en nooit in de context terechtkomt.
Die laag hadden we niet. We waren er stilletjes vanuit gegaan dat de loop daartussen het probleem van de klant was om op te lossen. Die aanname is wat NetApp heeft doorbroken, en het is de aanname waarvan wij denken dat de meeste partijen in de markt die nog steeds maken.


Wat TrueForge is: acht dingen die een loop in leven houden
Wat we daarna bouwden was van onszelf, en niemand had om het meeste ervan gevraagd. NetApp vond de muur; het ontwerp van wat daar voorbij kwam was ons werk, elke week onder druk getest tegen hun live workload.
Geïsoleerde uitvoering voor code, bestanden en shell-commando's. In plaats van megabytes aan logbestanden in de context te laden zodat het model ze kan lezen, voert de agent code uit op die output en geeft alleen het antwoord terug. Geheimen komen nooit in de sandbox terecht.
Zodra een agent een workload kan migreren van defecte hardware, moet iemand de mogelijkheid hebben om te zeggen: pauzeer en vraag het eerst aan mij. De uitvoering stopt voor goedkeuring op gedefinieerde punten.
Agents worden aanroepbare services die in elke front-end kunnen worden ingebed, in plaats van opgesloten te zitten in de onze. Een verzoek van NetApp, en degene die de vorm van het product het meest heeft veranderd.
Automatische compressie naarmate het venster volloopt; grote toolresultaten worden naar opslag verplaatst in plaats van inline geplaatst; uitgesteld laden van tools, zodat meer dan honderd tooldefinities het venster niet verbruiken voordat het werk begint.
Een bouw- en testomgeving voor mensen die nooit Python zullen schrijven, en dat ook niet zouden moeten hoeven.
Hiermee kan het model verschillende tool-aanroepen in één gesandboxte scriptketen plaatsen in plaats van voor elke aanroep een model-roundtrip te betalen. Bedoeld voor fan-out werk, zoals het scannen van acht clusters.
Alledaags, maar wel belangrijk. Het plafond van NetApp verschoof van 30 naar 40 naar 50 naarmate de tooling rijker werd. Elke limiet die we hard hadden gecodeerd, zou op elk punt van die curve onjuist zijn geweest.
Hiermee kan een langdurig onderzoek een ruis-gevoelige deeltaak delegeren en een conclusie ontvangen in plaats van een transcript. De context van de hoofdtaak blijft schoon gedurende meer dan 30 iteraties.

Eén → Vloot
Van één agent naar een vloot
Een tweede NetApp-team meldde zich onafhankelijk. Vimal Kannan, Director of IT for Enterprise Data and Analytics, beheert NetAI Chat, de interne assistent van NetApp. Zijn probleem was breedte in plaats van diepte: veel teams, veel tools, veel modellen, die allemaal centraal beheer nodig hadden.
Vandaag de dag zijn er ongeveer 150 tools bereikbaar via één Virtual MCP Server - één eindpunt dat fungeert als interface voor vele MCP-servers, zodat een client slechts één keer verbinding hoeft te maken in plaats van geconfigureerd te worden voor elke server afzonderlijk. Toegangscontrole per gebruiker bepaalt wat een individu kan aanroepen, en Skills (verpakte instructies voor een terugkerende taak) zijn zo afgebakend dat een team alleen ziet wat bij hen hoort. Duizenden NetApp-medewerkers bereiken die tools via de gateway zonder ooit een TrueFoundry-console te openen. Het beheer is onzichtbaar voor hen, en dat is precies de bedoeling.
Omdat Developer Platform Engineering ons had gepusht om agents als een SDK en een API aan te bieden, kon het NetAI Chat-team die agents rechtstreeks vanuit hun eigen front-end aanroepen. Twee onafhankelijke inspanningen werden één platform, nu onder één mandaat geleid door Rob Rubin, dat modellen, tools, agents en een Agent Registry omvat die bijhoudt wat er bestaat en wie de eigenaar is.
Eén Kubernetes-agent werden er meerdere in productie, met meer in de bouwfase en een interne agent-builder op de roadmap. Op dat punt verandert de aard van het probleem:
Dat is het probleem waar je tegenaan loopt als adoptie werkt. Het gaat sneller dan de meeste teams plannen.
Attributie
Het kostenverhaal is een controleverhaal
Een open, zelf-gehoste runtime elimineert de factuur van een beheerd platform per gebruiker. Dat is niet het interessante deel, en het is niet de reden waarom NetApp hier is.
Naast attributie is er het disciplineprobleem: mensen grijpen naar het grootste model terwijl een kleiner model zou volstaan. Beide worden op dezelfde plek opgelost. Elke model- en tool-aanroep wordt gekoppeld aan een persoon en een team, budgetten en limieten die daadwerkelijk werken, en routering die werk naar het juiste model stuurt in plaats van naar het grootste beschikbare model.
We zijn nog niet klaar. Rob wil budgethandhaving per uitvoering in plaats van per week, en hij heeft gelijk: een wekelijks plafond is te grofmazig wanneer één langlopende agent het in een enkel onderzoek kan verbruiken.
Dit is ook de reden waarom de harness en de gateway in één systeem thuishoren. Een harness alleen geeft je een agent. Een harness binnen een beheerd control plane geeft je een agent waar zowel je securityteam als je financiële team hun goedkeuring aan zal geven.
Open source
Waarom we het open-source maken
Eén klant, hoe geavanceerd ook, is slechts één datapunt. NetApp ontdekte de contextmuur door onderzoeken van 30 iteraties uit te voeren over acht clusters. Een team dat werkt aan documentworkflows, schadeafhandeling of CI-triage zal een andere muur tegenkomen, en we leren dat liever van de markt dan van onze eigen roadmap.
Er is ook een lastigere reden. Een team dat in 2025 weigerde om met propriëtaire connectoren te werken, zou zijn Kubernetes-omgeving nooit toevertrouwen aan een runtime die ze niet konden inzien, zelf konden draaien of konden forken. Portabiliteit was de voorwaarde voor deze hele samenwerking. Door de harness open-source te maken, nemen we die voorwaarde serieus in plaats van te vragen om blind vertrouwen.
Platformteams
Wat ik hiervan zou meenemen als ik een platformteam zou aansturen
Het onderscheidende vermogen van NetApp, van Kubernetes tot aan de hardware, bestaat omdat hun engineers hun eigen MCP-servers schreven voor hun eigen systemen. Geen enkele leverancier zou dat ooit meeleveren. De taak van het platform is om deze te hosten, beveiligen en beheren.
Het is de tweeëntwintigste iteratie, de context staat vol met shell-output en het onderzoek is nog niet afgerond. Bijna al het echte engineeringswerk zit in die kloof, en het blijft onzichtbaar totdat je iets lang genoeg draait om ertegenaan te lopen. Een grove test: als je agents routinematig meer dan tien tool-aanroepen per taak doen, zul je deze muur tegenkomen.
Elke agent die vastloopt tijdens de review, loopt vast op dezelfde vraag: wat kan dit ding doen en namens wie? Beantwoord dit in de infrastructuur & het antwoord geldt voor elke agent die daarna komt.
Iteratielimieten, contextbudgetten, aantal tools: elk van deze zaken werd voor NetApp binnen enkele maanden aangepast. Behandel ze als configuratie.
Een agent die alleen binnen de UI van een leverancier draait, kan nergens in worden geïntegreerd. De SDK en API zorgden voor de verandering waardoor twee NetApp-teams één platform konden worden.

Open source
Uitproberen
TrueForge is open source, MIT-gelicentieerd en te vinden op github.com/truefoundry/trueforge. De muur waar NetApp tegenaan liep, is nu iets waar je zelf tegenaan kunt lopen in je eigen workload, met de laag die er al voorbij kwam, nu in jouw handen.


Hiermee start je de harness en de bijbehorende UI op je machine. Wanneer je klaar bent om het serieus in te zetten, kun je het zelf hosten met Docker Compose of Kubernetes in je eigen omgeving. Koppel het aan elk gewenst model via een OpenAI-compatibel eindpunt, verbind je MCP-servers, en je hebt een werkende agent.
De harness staat op zichzelf; de gateways bepalen hoe je deze beheert. Draai TrueForge standalone en je krijgt de volledige cyclus: sandboxed uitvoering, context engineering, subagents, goedkeuringen, de SDK en API. Je brengt en beheert je eigen model- en MCP-sleutels. Koppel het aan TrueFoundry's AI Gateway en MCP Gateway en elke modelaanroep, tool-aanroep en MCP-interactie wordt geverifieerd, gebudgetteerd, beleidsgestuurd en gelogd onder de echte gebruikersidentiteit; de laag waar de security review van NetApp daadwerkelijk om gaf.
- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


