
EMEA, hallo! TrueFoundry breidt zijn aanwezigheid uit in Europa, het Midden-Oosten en Afrika. Lees meer. →


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


AI-oplossing om de leesvaardigheid van kinderen in kansarme gemeenschappen te beoordelen en te verbeteren
Wadhwani AI is een non-profitorganisatie die werkt aan meerdere kant-en-klare AI-oplossingen voor kansarme bevolkingsgroepen in ontwikkelingslanden.
Via het Vachan Samiksha-project ontwikkelt het team een op maat gemaakte AI-oplossing waarmee leraren in landelijk India de leesvaardigheid van leerlingen kunnen beoordelen en een gepersonaliseerd stappenplan kunnen opstellen om de leesvaardigheid van elke leerling te verbeteren.
Het team had de oplossing geïmplementeerd in basisscholen voor pilots. Het team kampte echter met de volgende problemen die moesten worden opgelost voordat de scope van het project werd uitgebreid naar meer scholen en leerlingen:
Het TrueFoundry-team werkte samen met het team om deze problemen op te lossen. Met behulp van het TrueFoundry-platform kon het team:
Wadhwani AI werd opgericht door Romesh en Sunil Wadhwani (onderdeel van de Time100 AI-lijst) om AI in te zetten voor het oplossen van problemen waar kansarme gemeenschappen in ontwikkelingslanden mee te maken hebben. Ze werken wereldwijd samen met overheden en wereldwijde non-profitorganisaties om via de oplossing waarde te leveren. Als non-profit gebruikt Wadhwani AI kunstmatige intelligentie om sociale problemen op te lossen op het gebied van landbouw, onderwijs en gezondheid, onder andere. Enkele van hun projecten zijn:
Wadhwani AI werkt ook samen met partnerorganisaties om hun AI-gereedheid te beoordelen — hun vermogen om AI-oplossingen effectief en duurzaam te creëren en te gebruiken. Het werk van Wadhwani AI is erop gericht AI voor het goede in te zetten en het leven van miljarden mensen in ontwikkelingslanden te verbeteren.
Leesvaardigheid is fundamenteel voor de onderwijsbasis van elk kind. Helaas missen veel leerlingen uit landelijke en kansarme regio's in India en andere ontwikkelingslanden deze vaardigheden. Om dit probleem op fundamenteel niveau op te lossen, heeft het Wadhwani AI-team een op AI gebaseerde tool voor mondelinge leesfrequentie ontwikkeld, genaamd Vachan Samiksha.
De tool zet AI in om de leesprestaties van elk kind te analyseren. Het is op dit moment vooral gericht op landelijke en semi-stedelijke regio's van het land en wordt gebruikt bij alle leeftijdsgroepen. Om de oplossing voor het grootste deel van het land generaliseerbaar te maken, heeft het team een accent-inclusief model gebouwd om regionale talen en Engels te beoordelen. Handmatige beoordeling van deze vaardigheden heeft eigen vooroordelen en is vaak onnauwkeurig.
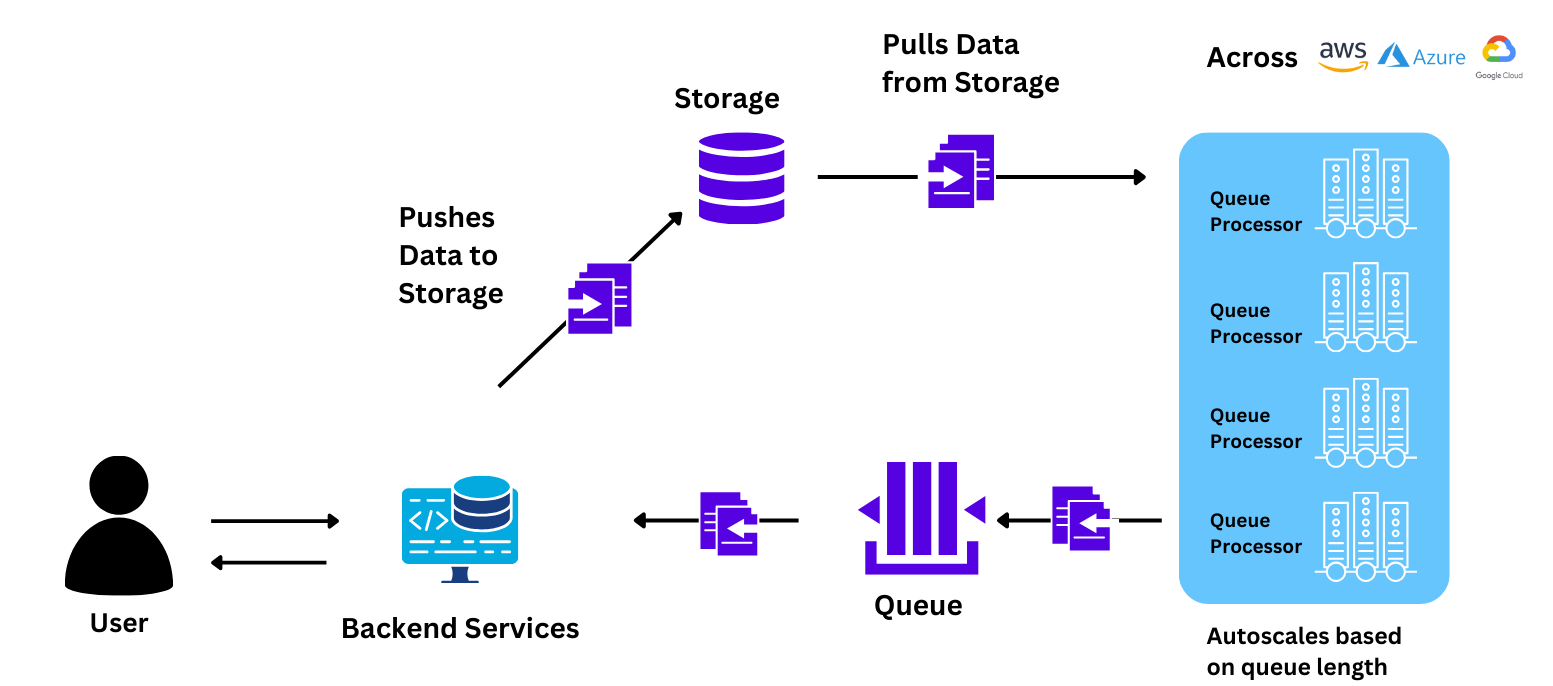
De oplossing wordt aan de gebruikers (leraren van de doelscholen) geleverd via een app die het model aanroept dat in de cloud is geïmplementeerd. De leerling leest een paragraaf voor, die door de applicatie wordt opgenomen en naar de cloud wordt gestuurd. In de cloud beoordeelt het model leesnauwkeurigheid, snelheid, begrip en andere complexe leerachterstanden die bij een normale beoordeling gemist zouden kunnen worden. Naast het beoordelen van deze vaardigheden stelt de applicatie ook een gepersonaliseerd leerplan op voor elke leerling om hun leerproces te faciliteren, en maakt het demografische rapporten voor acties op macroniveau door overheidsinstanties. Het team had het model voor de pilot geïmplementeerd met de beheerde ML-dienst van de cloudprovider
Toen we onze samenwerking met het Vachan Samiksha-team binnen Wadhwani AI startten, maakte het team gebruik van de native MLOps-stack van hun cloudprovider om het model te implementeren voor zijn pilot bij het onderwijsdepartement van Gujarat.
Hun infrastructuuropzet was als volgt:

Het team ondervond uitdagingen met deze opzet tijdens het uitvoeren van de eerste pilot, wat hen motiveerde om andere oplossingen te proberen:
Verwacht werd dat de pilot op een enorme schaal zou draaien (~6 miljoen leerlingen in een maand). Het team had er echter geen vertrouwen in dat de beheerde ML-dienst deze schaal zou kunnen ondersteunen, omdat:
Tijdens de pilot ondervond het team problemen met de opschaalsnelheid, en sommige pods kwamen niet op zoals verwacht. Om het probleem op te lossen, nam het team echter contact op met vertegenwoordigers van de cloudprovider, die vervolgens contact opnamen met het technische team. Dit veroorzaakte een vertraging in het systeem en leidde tot vertraging in de pilot.
Toen het verkeer tijdens de pilot toenam, moesten de pods horizontaal opschalen (nieuwe nodes opstarten die een deel van de verzoeken uit de wachtrij konden oppakken en verwerken). Dit proces duurde ~9-10 minuten voor elke nieuwe pod die werd opgestart, wat resulteerde in vertraagde reacties en een slechte ervaring voor de eindgebruiker.
GPU-instances zijn zeer duur vanwege het wereldwijde chiptekort. Tel daarbij op de 20-40% toeslag voor ML-instances die de cloudprovider rekent. Dit maakte de kosten van de instances zeer hoog en onhaalbaar voor het team op de schaal waarop ze het project wilden draaien.
Toen we het Vachan Samiksha-team ontmoetten, bevonden ze zich in de periode tussen hun eerste en tweede pilot. De pilot was minder dan een week weg en we moesten:

In de periode vóór de pilot:
Ons team hielp het Wadhwani AI-team het platform te installeren op hun eigen kale Kubernetes. Het control plane en het workload-cluster werden beide geïnstalleerd op hun eigen infrastructuur. Alle data, UI-elementen om met het platform te interacteren, en de workloadprocessen voor het trainen/implementeren van de modellen bleven binnen hun eigen VPC. Het platform voldeed ook aan alle beveiligingsregels en -praktijken van het bedrijf.
We hielpen het team begrijpen hoe de verschillende componenten met elkaar interacteren tijdens het training- en onboardingproces. We leidden hen door het opzetten van resources, het configureren van autoscaling en het implementeren van het model.
Het Wadhwani AI-team kon de applicatie met minimale hulp van het TrueFoundry-team zelfstandig migreren. Dit werd gedaan in een gesprek van 1 uur met het team.
Nadat de applicatie was geïmplementeerd, begon het team met het testen van productiebelasting erop. Het team schaalde de applicatie zelfstandig op naar meer dan 100 nodes via een eenvoudig argument op de TrueFoundry UI, wat 5x hun eerdere hoogst haalbare schaal is. Ze probeerden ook de snelheid van node-opschaling te benchmarken, die veel (3-4x) sneller was dan wat hun eerdere systeem bood.
Met de loadtests afgerond, implementeerde het team de pilotapplicatie en was voorbereid op de uitrol in de tweede fase van de pilot, die werd uitgerold naar 1000 scholen, 9000 leraren en meer dan 2 lakh leerlingen.
Met een minimale inspanning van minder dan 10 uur kon het Wadhwani AI-team een aanzienlijke verbetering realiseren in snelheid, controle en kosten. Enkele van de belangrijkste veranderingen die ze realiseerden waren:
De Data Scientists en Machine Learning Engineers konden meerdere elementen configureren die ofwel lastig voor hen waren om via de console van de cloudprovider te doen, of waarvoor ze afhankelijk waren van het engineeringteam:
Gebaseerd op wachtrijlengte en het verhogen van het maximale aantal replica's/nodes naar 70 in plaats van de eerdere limiet van 20
Omdat het meeste pilotverkeer binnenkwam tijdens schooluren, wanneer leraren met de leerlingen interacteerden, waren er minimale verzoeken, indien al, 's avonds en 's nachts. Het team kon een opschaalschema instellen waarmee de pods tijdens de daluren (avond en nacht) opschaalden naar een minimum. Dit bespaarde ongeveer 15-20% van de pilotkosten.
Het team kon het verkeer, de resourcebenutting en de reacties eenvoudig rechtstreeks vanuit de TrueFoundry UI monitoren. Ze ontvingen ook suggesties via het platform wanneer er sprake was van overprovisionering of underprovisionering van resources
"Voor mij was het grootste onderscheid bij het werken met TrueFoundry het gebruiksgemak en de snelle reactie en ondersteuning die het team bood. Ik kon onze volledige codebase binnen minder dan 1 dag opzetten en migreren, wat geweldig was. Tijdens de pilot en wanneer we twijfels of verzoeken hadden, was het TrueFoundry-team direct beschikbaar om onze twijfels op te lossen en ons te ondersteunen. Naast deze factoren krijgen we een enorme kostenbesparing die enorm nuttig is voor het project."
Om opschalen met TrueFoundry te testen, stuurde het team een burst van 88 verzoeken naar de applicatie en benchmarkte de prestaties van de beheerde ML-dienst van de cloudprovider versus TrueFoundry. Alle systeemconfiguraties werden gelijk gehouden, zoals de opschaallogica (gebaseerd op de wachtrijlengte, het initiële aantal nodes, instancetype, enz.)
We ontdekten dat TrueFoundry 78% sneller kon opschalen dan de beheerde ML-dienst, wat de gebruiker veel snellere reacties gaf. De end-to-end tijd die nodig was om op de query te reageren was 40% korter met TrueFoundry.
| Resultaten autoscaling-test (A10g-4vCPU's, 2 workers, 88 verzoeken) | ||
|---|---|---|
| Beheerde ML-dienst | TrueFoundry | |
| Totale tijd om alle 88 verzoeken te verwerken | 660s | 395,9s |
| Tijd om op te schalen (1 worker naar 2 workers) | 9 min | 2 min |
| Tijd voordat AutoScaler werd getriggerd | 2 min 30 sec | 15 sec |
De kosten die het team maakte voor de pilot werden met ~50% verlaagd door over te stappen naar TrueFoundry, mogelijk gemaakt door de volgende bijdragende factoren:
Terwijl de beheerde ML-dienst beperkt was door de beschikbaarheid van GPU-instances in dezelfde regio van de cloudprovider, kan TrueFoundry workernodes toevoegen aan het systeem die zich in elke regio of bij elke cloudprovider kunnen bevinden.
Dit betekent dat:
TrueFoundry biedt naadloze integratie met elke tool die het team wil gebruiken. Bij de cloudprovider werd dit beperkt door de ontwerpkeuzes van de provider en hun native integraties. Het team wilde bijvoorbeeld NATS gebruiken om berichten te publiceren, wat de native dienst van de cloudprovider op dat moment niet bood. Dit soort keuzes werd door TrueFoundry triviaal gemaakt voor het Wadhwani AI-team.



Het laatste nieuws, artikelen en bronnen in je inbox


